- TEEで外部検証可能なプライバシー保証を実現した次世代の連合学習システム
- 計算をサーバ側に移し、学習時間を従来の1〜2か月から大幅に短縮
- Gboardが既に採用し、英語・日本語の次単語予測モデルを提供
何が発表されたのか
Google Researchは2026年10月2日、Trusted Execution Environment(TEE、プロセッサ上に隔離された実行環境)を活用した次世代の連合学習(Federated Learning)システムを発表した。連合学習は、複数の端末に分散したデータを一箇所に集めずにモデルを訓練する機械学習の手法である。Googleは2017年にこれを導入して以来、Gboardの次単語予測やSmart Compose、Google Messagesの返信候補、AndroidのSmart Text Selectionなどに活用してきた。
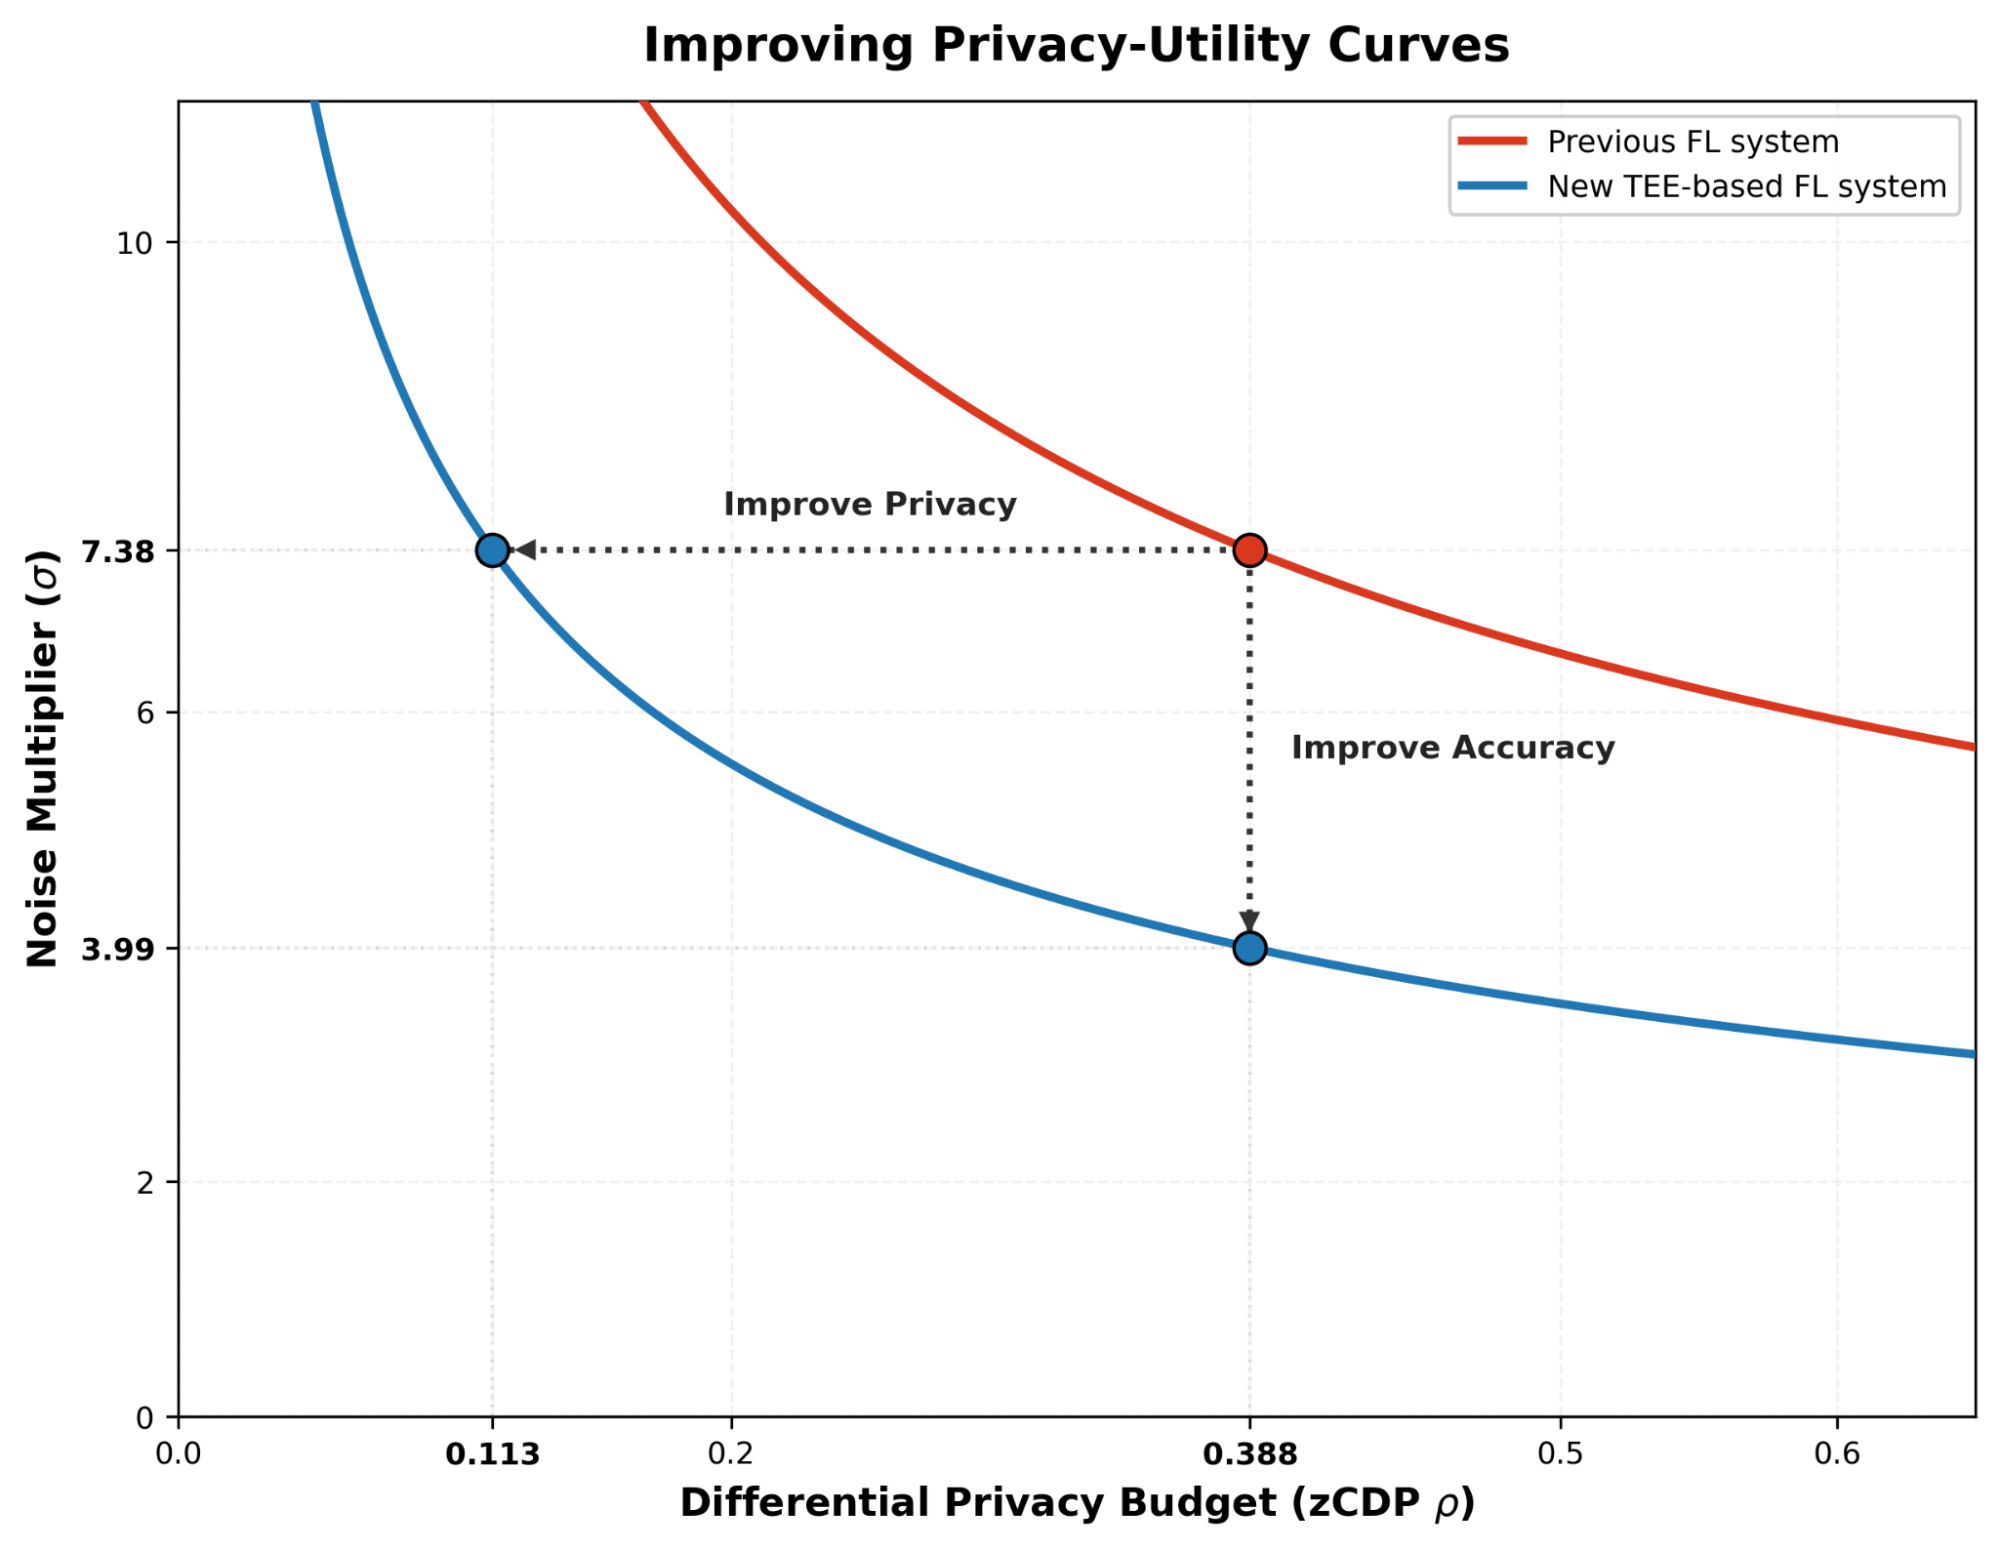
新しいシステムの狙いは、外部から検証可能なプライバシー保証を提供しつつ、計算をサーバ側へ移すことで学習速度や精度、対象デバイスの範囲を改善することにある。TEE上で動作するロジックはリモートから検証でき、内部状態を外部から観察できないという機密性と、改ざんされないという完全性を備えるとしている。Gboardは既にこのシステムを採用しており、従来の連合学習システムより計算時間が大幅に短縮されたという。
技術的な仕組み
システムは4つの中核的な運用概念で構成される。端末が訓練データを暗号化してアップロードする「データアップロード」、復号鍵を適切なTEEワークロードにのみ渡す「KMSとポリシー検証」、訓練ループを実行する「ワークロード実行」、訓練ラウンド終了時に復旧用の状態を保存する「耐障害性回復」である。
ポリシー検証を担うKey Management System(KMS)は、RAFTコンセンサスプロトコルを実装したTEEのクラスタで構成される。ワークロードの実行には、TensorFlow Federatedから派生したオープンソースでフレームワーク非依存のオーケストレーション言語「Federated Language」が使われる。訓練ループは定期的に匿名化されたモデル重みをデータ分析者へ公開する。
プライバシー強化の意味
従来の連合学習システムでは、端末のデータは即時集約のためにアップロードされるが、そのデータが記録されたり検査されたりしていないことを外部の観察者が検証する手段がなかった。後に導入されたSecure Aggregationはアップロードを暗号学的に保護したが、最先端の中央差分プライバシー保証とは互換性がなかった。
新システムでは、暗号化された訓練データはアクセスポリシーに記載されたPython訓練プログラムを実行するTEE内でのみ、アップロード後の限られた時間だけ復号・処理される。ワークロードの運用者に見えるのはメトリクスと差分プライバシーを適用したモデル重みのみである。
透明性と検証の仕組み
アクセスポリシーは公開透明性ログであるRekorに公開され、外部の監査者がサーバ側で実行され得るワークロードの全体を追跡できる。KMSとデータ処理のバイナリは、Confidential Federated ComputeのGitHubリポジトリで公開されているコードから再現可能にビルドできる。
モデル構造や前処理ロジックなど独自の情報を保護しつつ監査可能性を保つため、データ処理TEEは実行時にシリアライズされた情報をPythonプログラムへ動的に読み込む「サイドローディング」をサポートする。プライバシーに関わるロジックがPythonプログラム内に固定されていれば、外部から検証可能な保証を維持できるとしている。
Gboardでの実運用と性能
GboardはこのTEEベースのシステムを導入し、英語と日本語の次単語予測モデルを、より強いプライバシー保証と改善された精度で提供している。改善は新システムの設計上の複数の側面によるものと説明されている。
端末からのアップロードをすべて集めてからサーバ側の訓練ワークロードを実行することで、デバイス可用性の日周変動が訓練の進行に影響しなくなった。サーバ側の実行時に最適なデバイス参加スケジュールを動的に計算し、他の差分プライバシーパラメータの調整にも使えるという。従来は訓練に1〜2か月かかることがあったが、サーバ側での並列化により大幅に短縮されたとしている。
| 項目 | 従来のFLシステム | TEEベース新システム |
|---|---|---|
| 外部からの検証 | 不可 | 可能(Rekor、再現可能ビルド) |
| 差分プライバシー | Secure Aggregationは中央DPと非互換 | TEE内で処理し中央DPと互換 |
| 学習時間 | 1〜2か月 | サーバ側並列化で大幅短縮 |
Gboard has deployed this TEE-based FL system to launch English and Japanese next word prediction models with stronger privacy guarantees and improved accuracy.
GboardはこのTEEベースのFLシステムを導入し、より強いプライバシー保証と改善された精度を備えた英語と日本語の次単語予測モデルを提供している。
今後の見通し
Googleは今後、TEEとアクセラレータの統合を進め、より大きなモデルの連合学習を目指すとみられる。合成データ生成やLLM推論向けの別種のTEEを組み合わせるなど、連合学習以外のワークロードへの応用も検討中だとしている。将来のTEEハードウェアとサイドチャネル観測の緩和策の研究が進めば、動的に読み込まれるワークロードへの保護が深まるとの見方を示す。どの時点で本番環境へ広く展開されるかは、今回の記事では明確にされていない。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この発表はプライバシー保護の仕組みを外部に証明できるかどうかが実用の要件になりつつあることを示す。特に、オンデバイス処理の制約で連合学習を導入できなかった企業にとって、計算をサーバ側へ移せる設計は選択肢を広げる可能性がある。一方、TEEの可用性やサイドチャネル対策、運用コストは未解決の論点として残る。監査可能な透明性ログや再現可能ビルドといった要素は、規制対応や説明責任が求められる分野での設計の参考になる。
気になる点
- Gboardの日本語入力でも、この新しい連合学習の仕組みは使われているのか
- 原文によれば、GboardはこのTEEベースの連合学習システムを採用し、英語と日本語の次単語予測モデルを提供している。ただし、どの端末でいつから有効になっているかなど、展開時期や範囲の詳細は今回の記事では言及されていない。
- 既存の連合学習の仕組みから新しいシステムへ移行しやすいのか
- 学習ロジックを記述するFederated LanguageはTensorFlow Federatedから派生したオープンソースの言語で、KMSやデータ処理のバイナリもConfidential Federated Computeリポジトリで公開されている。ただし、すべての環境でそのまま動くかどうかは明らかにされていない。
- 計算をサーバ側に移すと、端末での連合学習の意味は薄れるのか
- データは端末で暗号化してアップロードされ、復号と処理はアクセスポリシーに合致するTEE内でのみ、アップロード後一定時間に限って行われる。生データをサーバ運用者が見られるわけではなく、集約後に差分プライバシーを適用した重みとメトリクスのみが可視となる。
用語解説
- 連合学習(Federated Learning)
- 複数の端末に分散したデータを集約せず、各端末上のデータを使ってモデルを訓練する機械学習の手法。
- TEE(Trusted Execution Environment)
- プロセッサ上に隔離された実行環境。外部から中身を観察できず改ざんも防げ、リモートから実行内容を検証できる。
- 差分プライバシー
- データに統計的ノイズを加え、個人のデータが含まれるかどうかを推測しにくくするプライバシー保護の枠組み。
- Secure Aggregation
- 複数の端末から集めたデータを、個々の値を秘匿したまま集約する暗号技術。
- リモートアテステーション
- 実行環境が本物で、想定通りのコードが動いていることを遠隔から検証する仕組み。
- サイドチャネル
- 実行時間や電力消費など、本来の出力以外の情報から内部状態を推測する攻撃の経路。
出典
Toward provably private learning from federated data
https://research.google/blog/toward-provably-private-learning-from-federated-data
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する