- GPT-6 Astra UltrafastがOpenAI APIと対象のChatGPT Work・Codexユーザー向けに提供開始
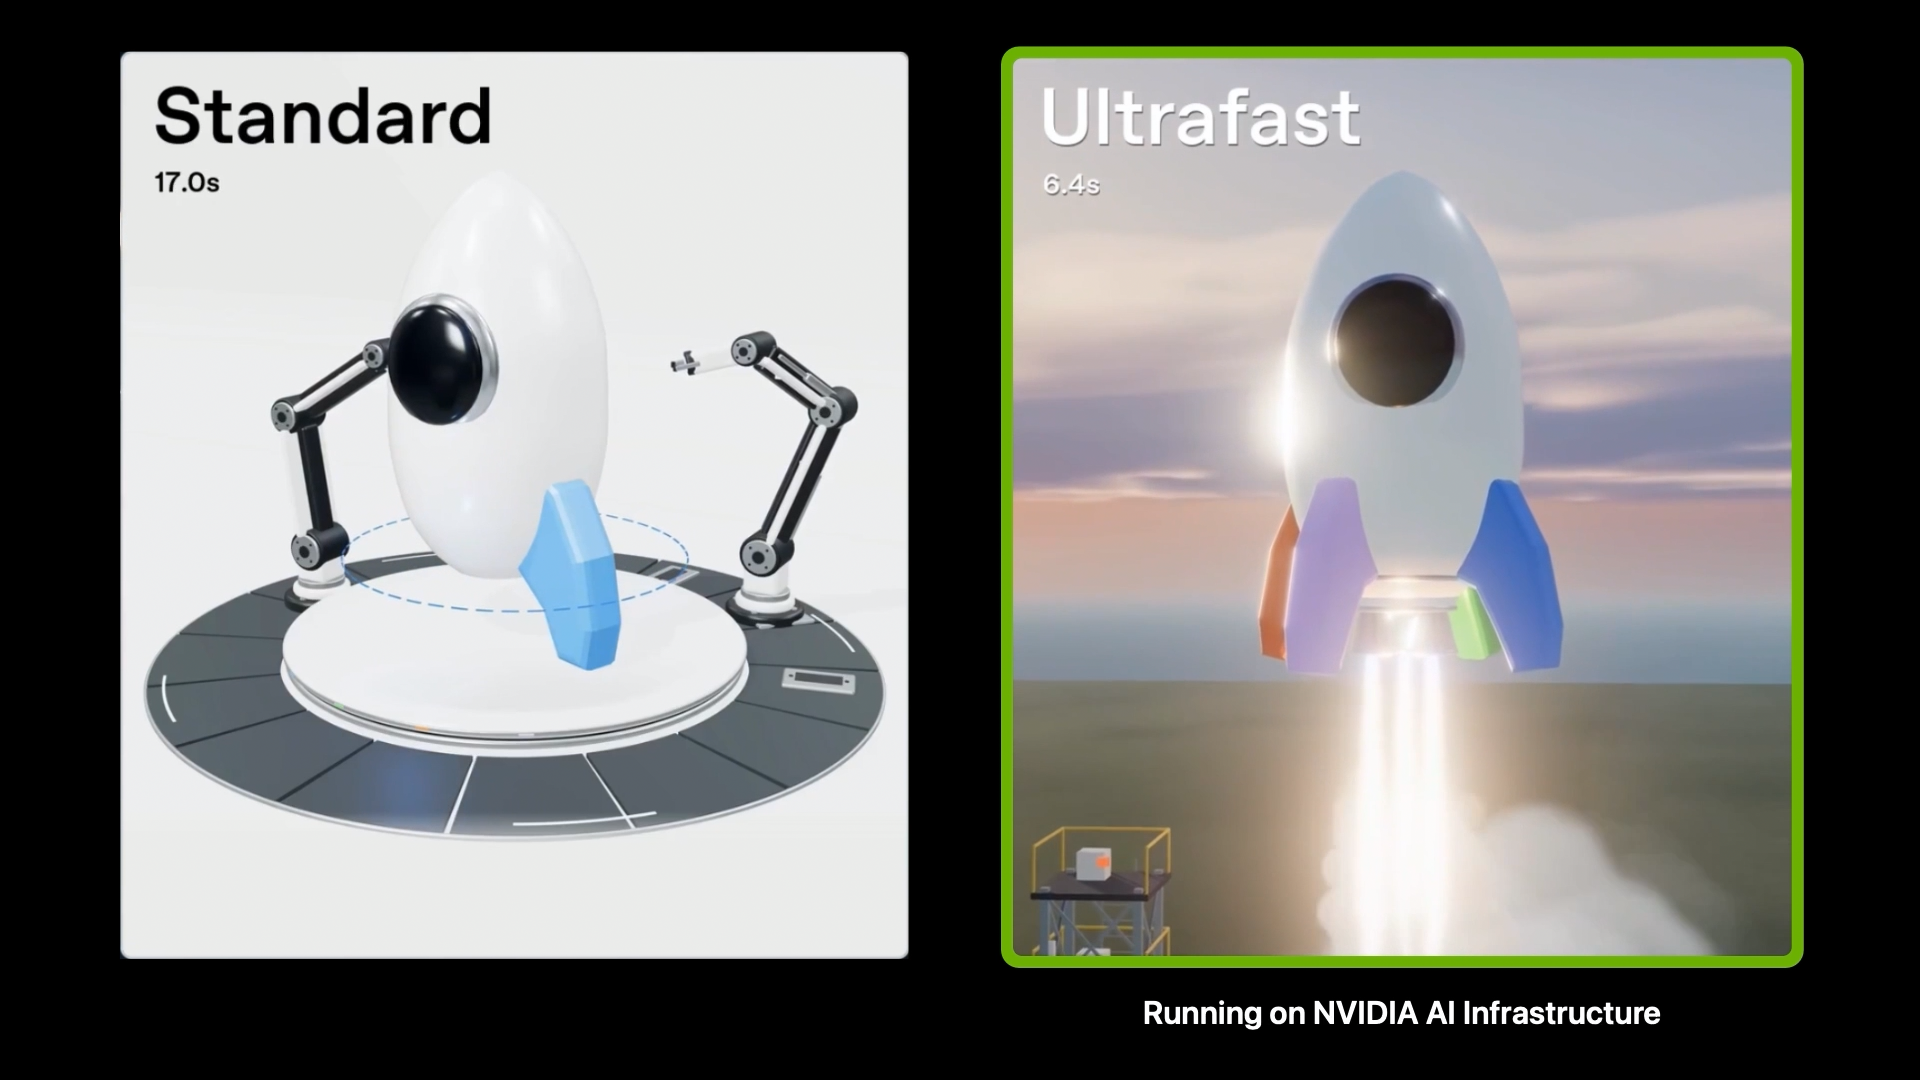
- NVIDIA Blackwell GPU上で動作し、Astra Standard比で最大8倍速いトークン生成
- OpenAIは自社モデルで推論ソフトを最適化、訓練・推論・強化学習でインフラを共用可能
何が公開されたのか
NVIDIAのブログによると、OpenAIの「GPT-6 Astra Ultrafast」がNVIDIAのBlackwell GPU上で動作し、OpenAI APIで利用できるようになりました。対象となるChatGPT WorkとCodexのユーザーも利用できるとされています。Astra Ultrafastは、OpenAIのモデルを通じた推論最適化によってNVIDIA Blackwellアーキテクチャの機能を引き出すことで、Astraの標準モードであるAstra Standardと比べて最大8倍速いトークン生成を実現すると説明されています。
開発者にとっての利点は待ち時間の短縮です。コーディングエージェントの編集・テスト・デバッグのサイクルを短くできるほか、ツール呼び出しの合間に応答を生成する時間を減らせます。対話型アプリケーションの応答性も向上するとされています。ブログは、応答が速いことの価値はエージェントがコードを書き、ツールを使い、結果を確認して次の行動を決めるといった反復の中でこそ大きくなると説明しています。
モデル自身で推論を最適化
ブログは、性能向上がモデルの配備後も続く点を強調しています。OpenAIは自社のモデルを使い、NVIDIA GPU上で動く推論ソフトウェアの改良を進めているとされます。プラットフォームのプログラマビリティを活かして改善を試し、実装できるため、時間の経過とともに応答が速くなり、配備したインフラの生産性も高まる可能性があるという説明です。
OpenAIの推論責任者であるPhilippe Tillet氏のコメントが引用されています。NVIDIAのツールとドキュメントへの深い投資により、自社モデルがBlackwellおよびRubin GPUのプログラミングを極めて得意になったという趣旨です。同氏は、Astraがその知識を高性能なカーネルに変換できると述べています。ここでのカーネルは、GPU上で動く計算処理の単位を指します。
訓練・推論・RLで共用
プログラム可能なNVIDIAプラットフォームは、モデルの進化に合わせて、訓練・推論・強化学習で同じインフラを再利用できるようにします。需要が変わったときに計算資源を別の用途へ振り向けやすくなり、利用率の改善や、ワークロードごとに過剰な設備を用意する事態の回避につながるとされています。
OpenAIのコンピュート担当CTOであるUday Ruddarraju氏は、NVIDIAとの協業がAIをより速く便利にしていると述べています。自社の内部モデルを使ってNVIDIA GPU上の推論を最適化し、NVIDIAのプログラマビリティがAstra Ultrafastの高速化を支えたという説明です。
現時点で不明な点
価格や具体的な実装方法は、このブログ記事には記載されていません。記事は「Ultrafastガイド」を参照するよう案内しており、アクセス方法・価格・実装の詳細はそこで示されるとみられます。
「最大8倍」という数値についても、どのような条件で測定したのか、比較対象のAstra Standardがどのような構成なのかは本文からは分かりません。実際の効果はワークロードによって変わるとみられます。日本国内での提供状況や対応言語に関する記述もありません。
| 項目 | Astra Ultrafast | Astra Standard |
|---|---|---|
| トークン生成速度 | Astra Standard比で最大8倍 | 比較の基準(速度の記載なし) |
| 動作GPU | NVIDIA Blackwell | 原文に記載なし |
| 提供状況 | OpenAI API、対象のChatGPT Work・Codexユーザー | 原文に記載なし |
NVIDIA’s deep investment in tooling and documentation has enabled us to make our models exceptionally good at programming Blackwell and Rubin GPUs.
NVIDIAのツールとドキュメントへの深い投資のおかげで、当社のモデルはBlackwellおよびRubin GPUのプログラミングを極めて得意にできるようになりました。
今後の見通し
今回の発表は、モデル本体の性能だけでなく、推論スタックとハードウェアの組み合わせで応答速度を引き上げる流れを示しています。OpenAIは自社モデルを推論ソフトウェアの最適化に使っているとしており、同様の手法が他のモデルやGPU世代にも広がる可能性があります。次に判断したいのは価格と実測性能です。Ultrafastガイドに料金体系や利用条件が示されれば、Astra Standardとの使い分けをコスト面から検討できます。また、レイテンシやスループットを測った条件と、どのワークロードで8倍に近づくのかが明らかになれば、エージェント型アプリへの採用判断がしやすくなるでしょう。日本からの利用可否も確認したい点です。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この発表の意味は主に2つあります。1つは、コーディングエージェントの応答速度が実務の生産性に直結する点です。編集・テスト・デバッグを繰り返す開発フローでは、1回あたりの待ち時間が短くなる効果が積み上がります。API経由で利用できるため、社内ツールやCIに組み込んだエージェントの体感速度を改善できる可能性があります。もう1つは、推論コストとインフラ計画への影響です。同じ処理を短い時間で終えられればGPUの占有時間を減らせる可能性がありますが、価格が示されていないためコスト削減効果は現時点では判断できません。訓練・推論・強化学習でインフラを共用できるという説明は、需要変動に合わせて計算資源を柔軟に配分したい企業にとって参考になる考え方です。
気になる点
- Astra Ultrafastの利用料金はいくらですか
- この記事には価格の記載がありません。原文は、アクセス方法・価格・実装の詳細について「Ultrafastガイド」を参照するよう案内しています。料金体系やAstra Standardとの価格差は現時点では公表されていないため、同ガイドやOpenAIの公式情報で確認する必要があります。
- 既存のOpenAI APIを使うコードから移行できますか
- Astra UltrafastはOpenAI API経由で提供されると記載されているため、同じAPIを利用する既存コードから呼び出せる可能性があります。ただし、モードの切り替え方法や必要なパラメータの変更といった実装詳細は原文に記載がなく、Ultrafastガイドでの確認が必要です。
- 日本からも使えますか
- 原文には提供地域に関する記述がありません。OpenAI APIおよび対象のChatGPT Work・Codexユーザー向けに提供されるとあるだけで、日本国内での提供可否や対応状況は現時点では公表されていません。公式の提供状況の案内を待つ必要があります。
用語解説
- Blackwell
- NVIDIAのGPUアーキテクチャの世代名。原文ではGPT-6 Astra Ultrafastの動作基盤として挙げられている。
- トークン
- 言語モデルがテキストを処理する際の最小単位。生成速度は通常トークン毎秒などで評価される。
- 推論(inference)
- 学習済みモデルに文章などを入力して出力を得る処理。学習とは負荷の性質が異なる。
- カーネル
- GPU上で動く計算処理の単位。効率よく実装できるかが推論性能を左右する。
- 強化学習(RL)
- 試行錯誤と報酬を通じてモデルや方策を改善する学習手法。訓練・推論と並ぶ計算負荷の種類。
- プロビジョニング
- 必要な計算資源をあらかじめ用意・配分すること。過剰に用意すると利用率が下がる。
出典
How NVIDIA GPUs Help Accelerate OpenAI’s GPT-6 Astra Ultrafast
https://blogs.nvidia.com/blog/gpus-openai-gpt-6-astra-ultrafast
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する