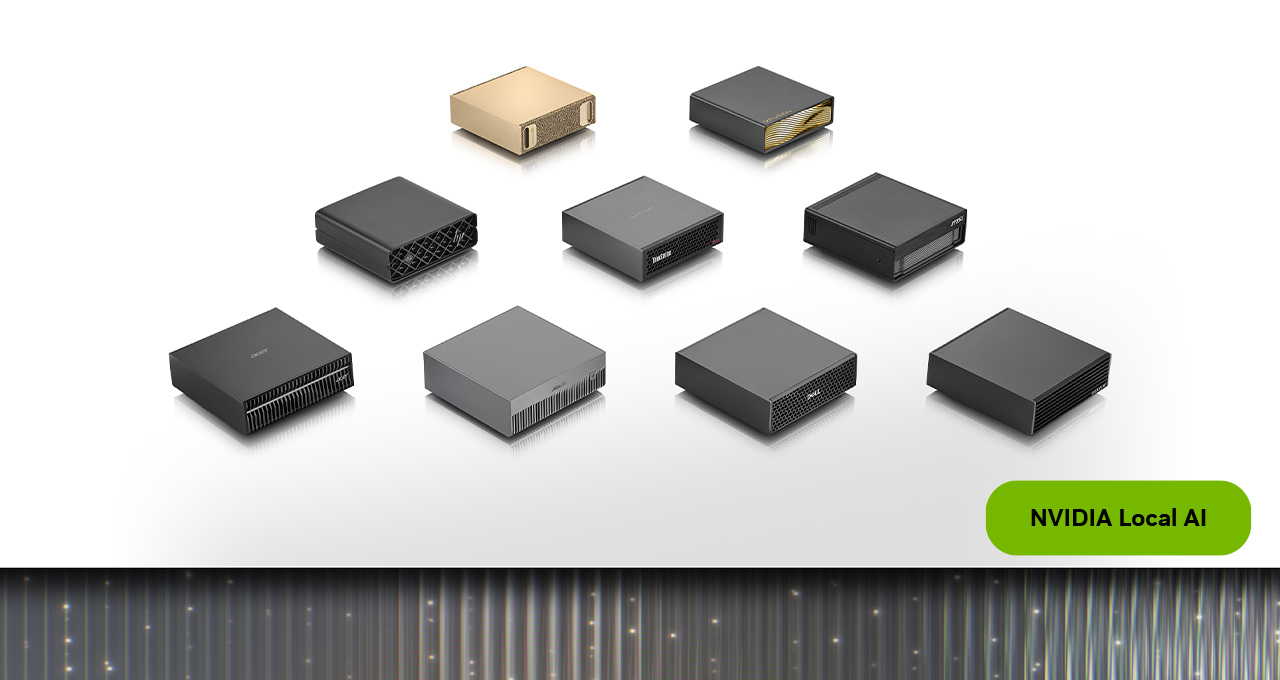
- DGX Sparkに64GB構成が追加、10月23日発売、4,999ドルから
- 1台で最大1,000億パラメータ、2台連結で最大2,000億パラメータに対応
- NVIDIA Syncで2台クラスタを自動構成、性能は最大1.7倍
何が発表されたのか
NVIDIAは、同社のコンパクトなパーソナルAIスーパーコンピュータ「DGX Spark」に、64GBのユニファイドメモリを搭載した新たな構成を追加すると発表した。提供するのはAcer、ASUS、Dell、Gigabyte、HP、MSIの6社で、発売は10月23日(金)、価格は4,999ドルからとされている。開発者、研究者、AIに関心を持つ利用者を主な対象に、DGX OSとNVIDIAのAIソフトウェアスタックを最初から使える状態で届けるとしている。
DGX Sparkは、NVIDIA Grace Blackwellの演算、ユニファイドメモリ、NVIDIA ConnectX-7ネットワーキング、CUDAで高速化されたAIソフトウェアスタックを1つのシステムにまとめたものだ。エージェント、推論、ファインチューニング、データサイエンス、エッジ開発向けのローカルAIプラットフォームだと位置づけられている。NVIDIAは、すべてのタスクをクラウドインスタンスに任せるのではなく、モデルや自社データを手元で試せる場所を提供するものだと説明している。
2台連結でどう変わるか
新構成は製造パートナー経由でのみ提供され、128GBモデルと同じGB10 Grace Blackwell Superchip、DGX OS、NVIDIAのAIソフトウェアスタックを維持しつつ、価格を手に届きやすい水準に保つとしている。1台で最大1,000億パラメータのモデルと、その上に作られたエージェントアプリケーションを、完全にオンデバイスで動かせるという。
2台を連結した場合、単純にメモリが2倍になるだけではないとNVIDIAは説明する。Qwen 3.8 27Bを使ったテストでは、クラスタ化した2台の64GBシステムが単体比で最大1.7倍の性能を示し、負荷に応じてさらに拡張できる余地があるとした。各ノードは同じソフトウェアスタックで動くため、1台から2台に拡張する際にソフトウェア環境を構成し直す必要はないとされている。
接続には、各DGX Sparkに標準で内蔵されるNVIDIA ConnectX-7 NICを使う。2台はQSFPケーブルで直接つなぐことができ、メモリを128GBにプールし、対応モデルを最大2,000億パラメータへ広げ、メモリ帯域を2倍にするとしている。このマルチノード構成の設定を担うのがNVIDIA Syncアプリで、クラスタアシスタント機能が接続された機器の検出、構成の検証、ConnectX-7ネットワークの設定を自動で行う。
ソフトウェアと提供時期
DGX Sparkは、NVIDIA Agent Toolkit、CUDA-X AIライブラリ、Nemotronのオープンモデル、Ollama、vLLM、PyTorch(CUDA対応)といった主要なランタイムをそのままサポートし、電源投入から数分でモデルを動かせるとしている。3D制作ソフトのBlenderも、いち早く対応するクリエイター向けアプリの一つとして挙げられ、ビルド済みのインストーラーが近く提供される予定だ。
同月末にはNVIDIA Sync Model Launcherが提供される予定で、数回のクリックでローカルAIを動かせるようにするとしている。単体またはクラスタ上でQwen3.8 27Bをダウンロードして起動し、接続された機器にまたがって実行するようNVIDIA Syncが設定、利用者のノートPCからアクセスできるようにする。ブラウザ上でコーディングを始められるよう、OpenCodeのセットアップも行うという。
利用例としては、コーディングや調査用のエージェントを継続的に動かす、普段使うPCで言語モデルや画像生成モデルを動かす、作業が1台の容量を超えたら2台構成に広げる、という3つが示されている。単体で始めて、必要になった時点でクラスタに拡張する段階的な使い方が想定されている。
現時点で分かっていないこと
発売は10月23日とされ、対応する販売パートナーも公表されているが、日本国内での販売時期や取り扱い、円換算の価格は示されていない。128GBモデルの価格についても今回の発表では言及がないため、64GB構成との価格差は不明だ。
2台クラスタの性能については、Qwen 3.8 27Bを使ったテストで最大1.7倍という数値が示されているが、他のモデルやワークロードでどの程度の効果があるかは明らかにされていない。また、NVIDIA Sync Model LauncherでQwen3.8 27B以外のモデルが扱えるようになるかも、この記事からは読み取れない。なお、モデル名は原文の表記に従っている。
| 項目 | 単体構成 | 2台クラスタ構成 |
|---|---|---|
| メモリ | 64GB | 128GB(2台をプール) |
| 対応モデル規模 | 最大1,000億パラメータ | 最大2,000億パラメータ |
| 性能 | 単体を基準 | 最大1.7倍(Qwen 3.8 27Bのテスト) |
| 接続方法 | 内蔵ConnectX-7 NIC | QSFPケーブルで直接接続(200 GbE) |
In NVIDIA's Qwen 3.8 27B test, two clustered 64 GB systems delivered up to 1.7x performance compared with a single system, with room to keep scaling as workloads demand.
NVIDIAのQwen 3.8 27Bのテストでは、クラスタ化した2台の64GBシステムが、単体システムと比べて最大1.7倍の性能を発揮し、ワークロードの要求に応じてさらに拡張できる余地があった。
今後の見通し
今後の焦点は、10月23日の発売後に、64GB構成の実売状況や128GB構成との価格差がどうなるかだ。NVIDIA Sync Model Launcherは同月末の提供予定とされており、どのモデルをどの程度の手間で動かせるのかが明らかになれば、導入判断がしやすくなる。また、Acer、ASUS、Dell、Gigabyte、HP、MSIの各社が日本国内でいつ、どのようなサポート体制で提供するかが示されれば、国内企業の検討は進むとみられる。エージェントを継続稼働させた場合の消費電力や設置条件、騒音といった運用面の情報も、実際の導入を左右する判断材料になると考えられる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この発表は「AI推論をどこで動かすか」の選択肢が増えることを意味する。クラウドAPIに依存せず、機密性の高いデータを社外に出さずにエージェントやモデルの検証を進められるため、社内規定が厳しい業種や、通信遅延・従量課金を避けたい用途では検討材料になる。1台で最大1,000億パラメータ級、2台連結で最大2,000億パラメータ級のモデルを扱えるとされ、まず1台で試し、必要になったらクラスタへ広げる段階的な導入が想定されている点も実務的だ。一方でNVIDIAのソフトウェアスタックに乗る前提のため、既存のクラウド環境や他社アクセラレータとの使い分け、運用・保守体制の設計は各社で検討が必要になる。
気になる点
- 日本国内でも購入できるのか
- 原文では販売パートナーとしてAcer、ASUS、Dell、Gigabyte、HP、MSIの6社が挙げられ、10月23日発売、4,999ドルからとされている。ただし日本国内での販売時期や各社の取り扱い状況、円換算の価格については言及がない。国内での提供可否は各社の日本法人の発表を待つ必要がある。
- 2台構成にした場合の費用はいくらになるのか
- 64GBモデル単体が4,999ドルからとされているため、単純計算では2台で約1万ドル程度になる。ただしNVIDIAは2台セットの価格や割引については示していない。QSFPケーブルや設置環境を含めた総額は現時点では公表されていない。
- 既存のPCやワークステーションと併用できるのか
- 原文では、DGX Sparkで言語モデルや画像生成モデルを動かし、ノートPCやデスクトップでエージェントやクリエイティブアプリを使う構成が例示されている。NVIDIA Sync Model Launcherは、クラスタ上のモデルを利用者のノートPCからアクセスできるようにするとされている。既存PCを置き換えるのではなく、推論を任せる使い方が想定されている。
用語解説
- ユニファイドメモリ
- CPUとGPUが同一のメモリ空間を共有する方式。データのコピーを減らし、大きなモデルを扱いやすくする。
- GB10 Grace Blackwell Superchip
- NVIDIAのGrace CPUとBlackwell GPUを組み合わせた小型システム向けのチップ。DGX Sparkの中核となる。
- ConnectX-7
- NVIDIAのネットワークインターフェースカード。DGX Sparkに標準で内蔵され、2台の接続に使われる。
- QSFP
- 高速通信用のケーブル規格。ここでは2台のDGX Sparkを直接つないでメモリをプールするために使う。
- 推論(inference)
- 学習済みモデルに新しい入力与えて結果を得る処理。エージェント実行やアプリ連携の中心となる。
- パラメータ
- モデルの規模を表す指標。数が多いほど一般に高性能だが、必要なメモリ量も増える。
出典
NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する