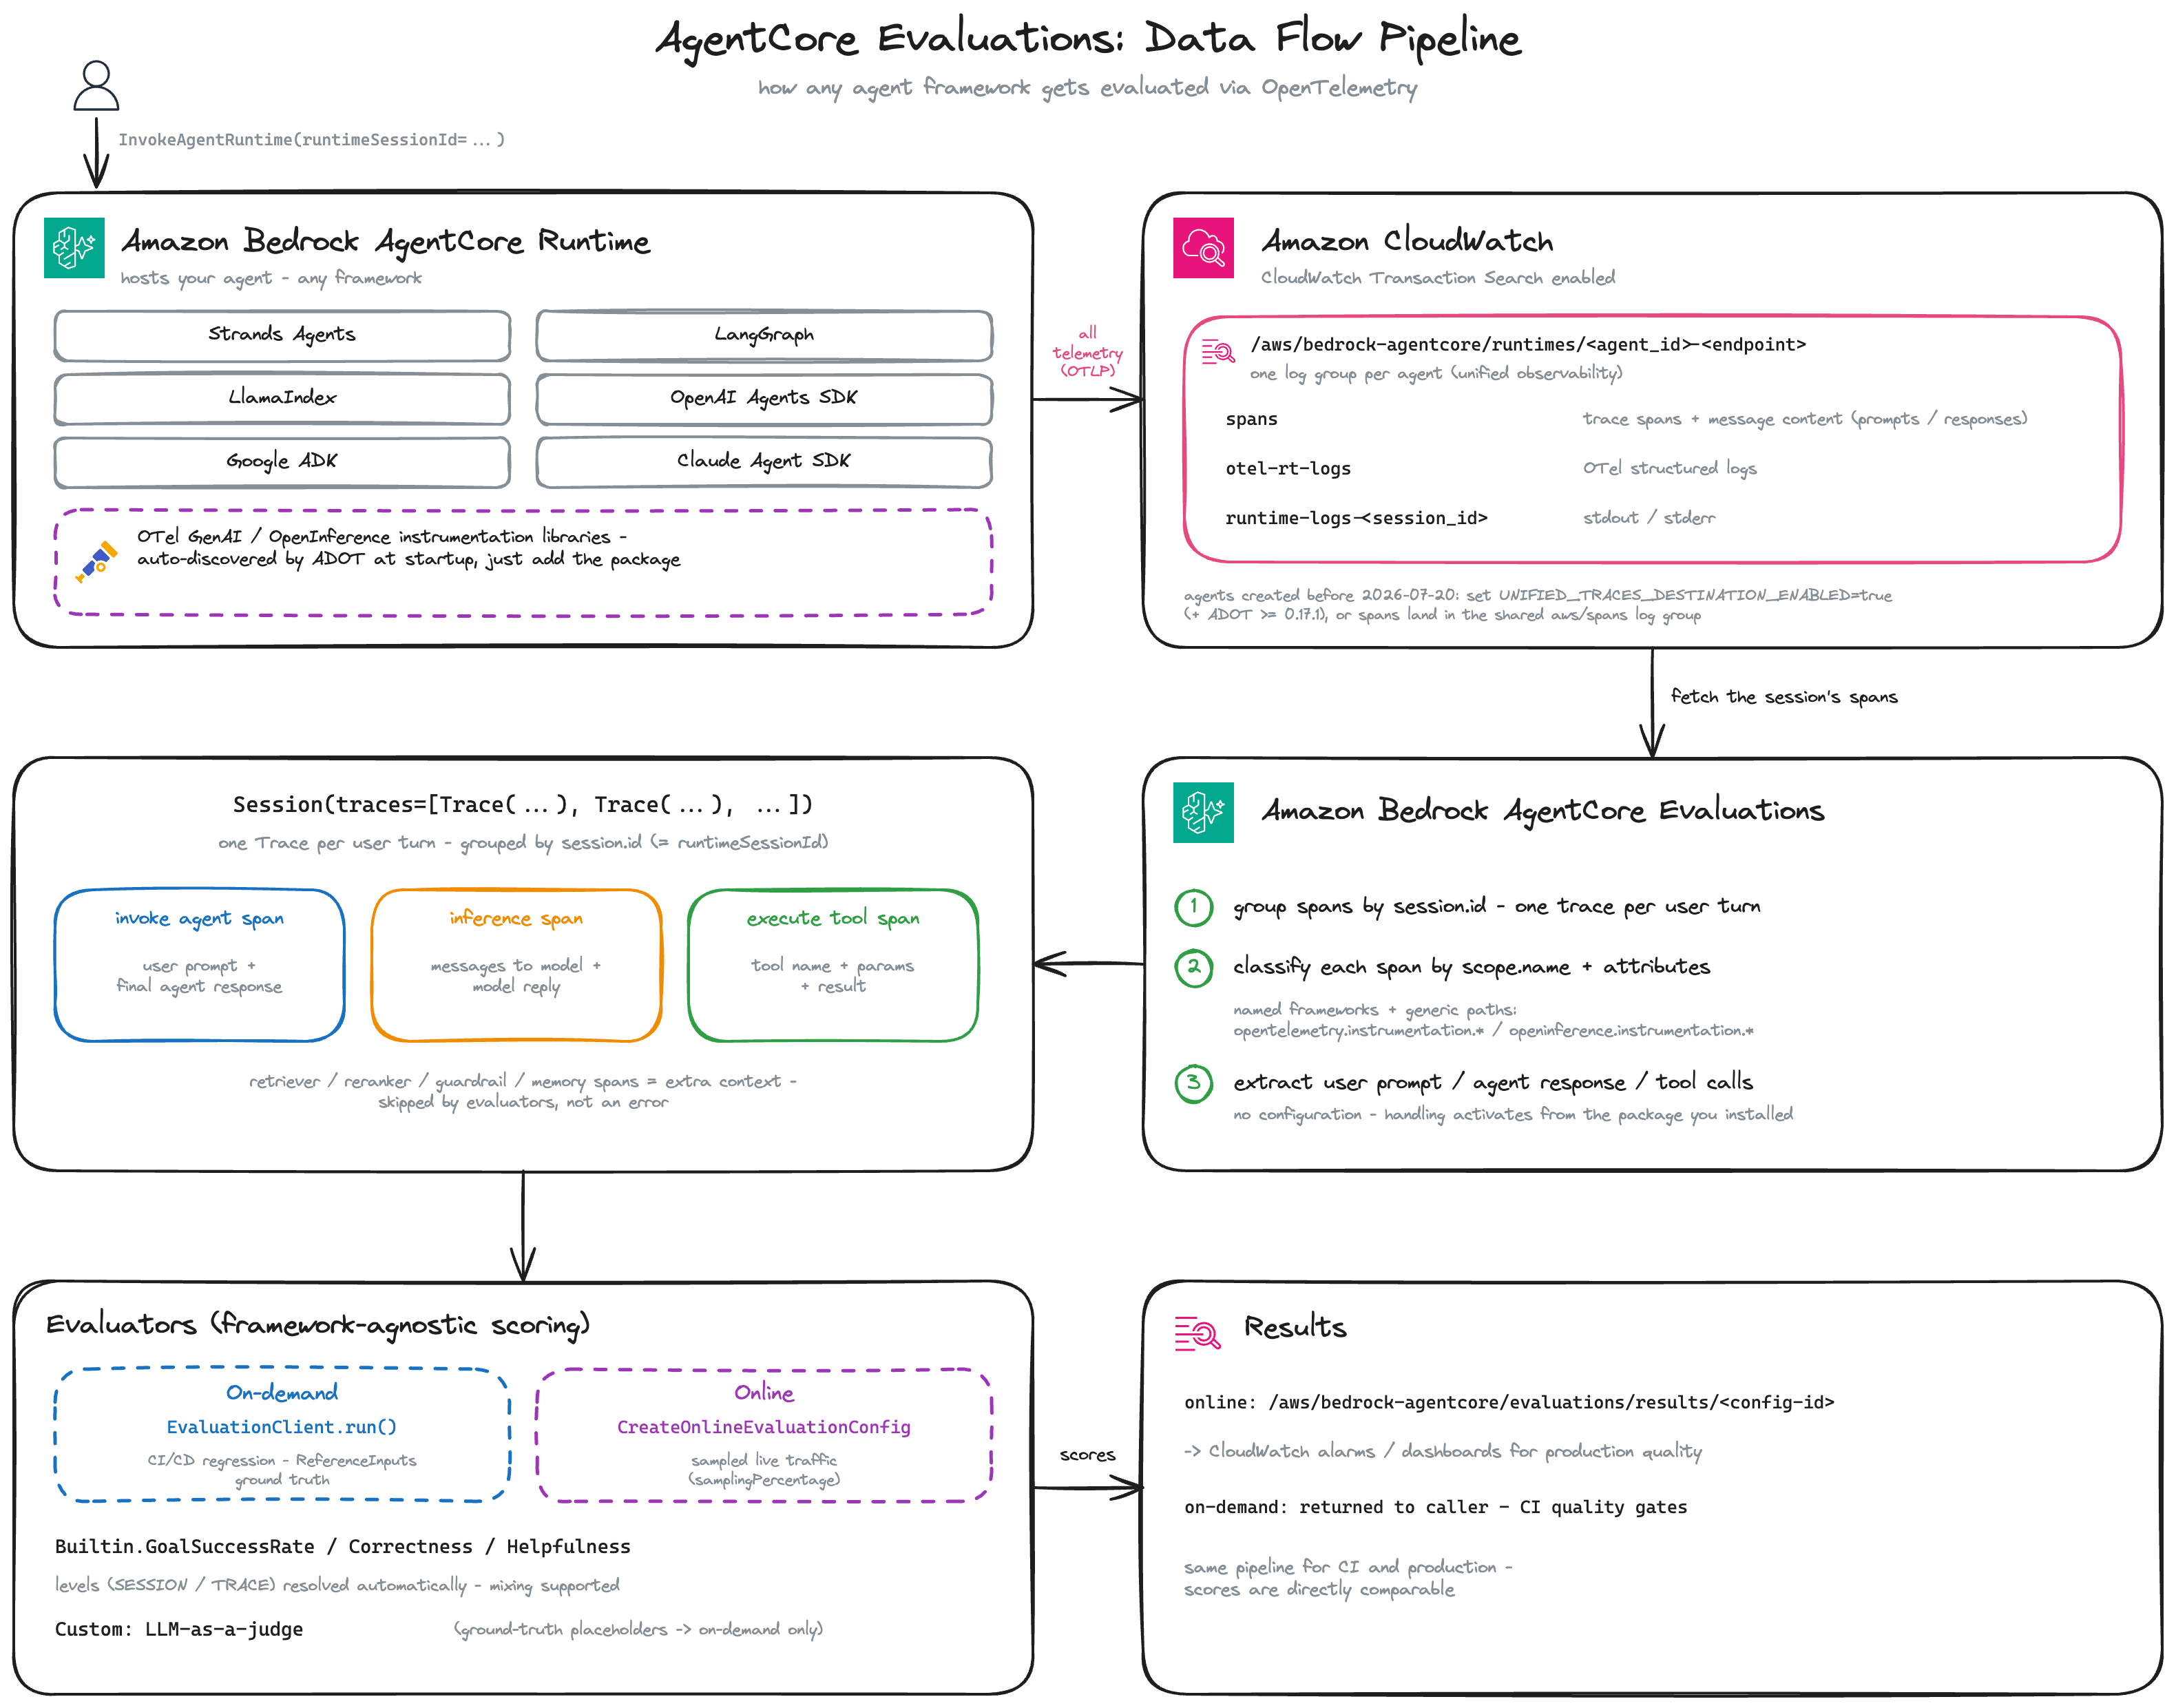
- OpenTelemetryを使い、フレームワーク非依存の評価を実現
- invoke agent・inference・toolの3種のスパンを読む
- LangGraphなど6基盤をサポートし、拡張は計装で対応
評価の断片化に終止符
AWSは、エージェント基盤の種類を問わず評価できる「Amazon Bedrock AgentCore Evaluations」を発表した。これまでエージェントの評価ツールは特定のSDKやLLMクライアント、トレーシング手法に依存することが多く、異なる基盤を組み合わせるとパイプラインが壊れる問題があった。今回のサービスは、評価の仕組みをフレームワークから切り離すことで、この断片化に対応する。
対応基盤としては、LangGraph、LlamaIndex、OpenAI Agents SDK、Google ADK、Claude Agent SDK、Strands Agentsが挙げられている。これらはAmazon Bedrock AgentCoreランタイム上で動作させることができ、ホスティングやスケーリング、メモリ、可観測性のインフラを共通化できる。
OpenTelemetryを共通基盤に
評価の共通言語となるのがOpenTelemetryだ。これは分散システムのトレースやメトリクス、ログを標準化するベンダー中立の計装フレームワークで、エージェントの実行はスパン(処理の1単位)のツリーとして記録される。AgentCoreランタイムでは、AWS Distro for OpenTelemetry(ADOT)がスパンを収集し、Amazon CloudWatchに転送する。
エージェントの実行では、モデル呼び出し、ツール呼び出し、検索、ガードレールなど多様なスパンが生成される。このうち評価で必要なのは、ユーザー1ターンに相当する「invoke agent」スパン、個々のモデル呼び出しの「inference」スパン、ツール呼び出しの「execute tool」スパンの3つだけ。他のスパンは追加コンテキストとして無視されるため、トレースが複雑でも設定変更は不要だ。
スパンの分類と2つのスキーマ
スパンからどのデータを読むかは、計装ライブラリが付与する「スコープ名」で自動的に切り替わる。OpenTelemetryのGenAI規約に従う場合は「gen_ai.operation.name」で分類し、OpenInference規約に従う場合は「openinference.span.kind」で分類する。属性名は異なるが、どちらのスキーマでも同じ3つのスパン役割を抽出できる。
例えばOpenTelemetry GenAI規約では、ツール名やツール呼び出しID、ツール定義が特定の属性に格納される。一方OpenInferenceは、メッセージ内容を「llm.input_messages.{i}.message.role」のようなインデックス付きのフラットな属性で表す。実装によって属性の置き場所が異なるが、評価サービスはどちらの形式でも読み取れる。
導入に必要な2つの条件
エージェントのセッションを評価するには、スパンがsession.idを持ち、実行時に使ったruntimeSessionIdと一致している必要がある。AgentCoreランタイム上ではADOTがこの属性を自動で注入するため、エージェントのコード変更は不要。また、メッセージ内容がスパンと同じロググループに含まれていることも重要だ。
新規作成エージェントの標準構成(unified observability)では、スパンとメッセージ内容が同一ロググループに保存される。一方、旧構成のエージェントではスパンはaws/spansに、メッセージ内容はエージェント個別のロググループに分かれて保存される。この場合にデータソースがaws/spansのみだと、応答品質を評価する項目でエラーになるため、設定の見直しが必要。
カスタム計装と将来性
対応フレームワークは明示された6つにとどまらない。スコープ名が「opentelemetry.instrumentation.*」または「openinference.instrumentation.*」で始まる計装ライブラリを使っていれば、汎用の読み取りパスで評価できる。逆に、独自のスコープ名で計装した場合は、たとえスパンが規約に沿っていても認識されない。
将来新たなフレームワークやスパン種別が登場しても、未知のスパンは追加コンテキストとして無視されるため、前方互換性があると説明されている。評価ロジック自体はフレームワークに依存しないため、複数の基盤を同じ基準で比較しやすくなる。
| 項目 | OpenTelemetry GenAI規約 | OpenInference規約 |
|---|---|---|
| 役割の識別 | gen_ai.operation.name | openinference.span.kind |
| ツール追跡 | gen_ai.tool.name / gen_ai.tool.call.id | llm.input_messages.*.tool_call_id / llm.output_messages.*.tool_calls |
| メッセージ内容 | gen_ai.input.messages / output.messages | llm.input_messages.{i}.message.content など |
| ツール定義 | gen_ai.tool.definitions | llm.tools.{i}.tool.json_schema |
As long as an agent’s telemetry flows through OpenTelemetry, the evaluation service can score it, regardless of what SDK sits underneath.
エージェントのテレメトリーがOpenTelemetryを通じて流れる限り、評価サービスはその下にあるSDKに関係なくスコアリングできる。
今後の見通し
AgentCore Evaluationsの対応フレームワークは今後も増えるとみられる。基準としてはOpenTelemetryとOpenInferenceの規約に沿った計装が普及することが条件だ。次に注目すべきは、既存エージェントのunified observability移行が進むかどうかと、LLM-as-a-judgeによる評価結果の信頼性だろう。実際の導入判断には、各評価指標(GoalSuccessRateなど)がどのようなプロンプトで判定されるのか、自社ユースケースと照らして検証する必要がある。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっては、複数のエージェントフレームワークを評価対象にする際のコスト削減につながる。従来はフレームワークごとに評価ツールを用意する必要があったが、OpenTelemetryにテレメトリーを集約できる環境であれば、同じ評価指標で比較できる。特にBedrock AgentCore上で運用していれば、ADOTがsession.idを自動付与するため、コード変更の負担は小さい。一方で、旧構成からの移行や、独自計装のスパンを扱う場合は設定を理解しておく必要がある。評価基盤を共通化しておくことは、フレームワーク移行の自由度を高める上でも有効だろう。
気になる点
- 対応フレームワークは何がありますか?
- 現在、Strands Agents、LangGraph、OpenAI Agents SDK、LlamaIndex、Google ADK、Claude Agent SDKが挙げられています。いずれもOpenTelemetryまたはOpenInferenceの計装に対応しています。
- 自社のフレームワークを対応させるには?
- OpenTelemetryかOpenInferenceに準拠した計装ライブラリを導入し、スコープ名の接頭辞を「opentelemetry.instrumentation.*」または「openinference.instrumentation.*」にすることが目安です。独自のスコープ名では評価されません。
- 旧構成のエージェントでは評価できないですか?
- データソースにメッセージ内容を含める設定にすれば可能です。スパンはaws/spansに、メッセージ内容はエージェントのロググループにあるため、両方を参照するよう構成する必要があります。設定しないと応答品質系の評価がエラーになります。
用語解説
- OpenTelemetry
- 分散システムのトレースやメトリクス、ログを標準化する計装フレームワーク。
- スパン
- 1回の処理を表す単位。名前、時間、属性を持ち、トレースはスパンのツリーになる。
- OpenInference
- Arize AIが管理するLLM用のオープンなテレメトリ仕様。LlamaIndexやPhoenixで採用。
- LLM-as-a-judge
- LLM自身に生成結果の良し悪しを判定させる手法。
- Amazon Bedrock AgentCore
- エージェントの実行基盤。ホスティングやメモリ管理などを担う。
出典
Evaluate any agent framework with Amazon Bedrock AgentCore Evaluations
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する