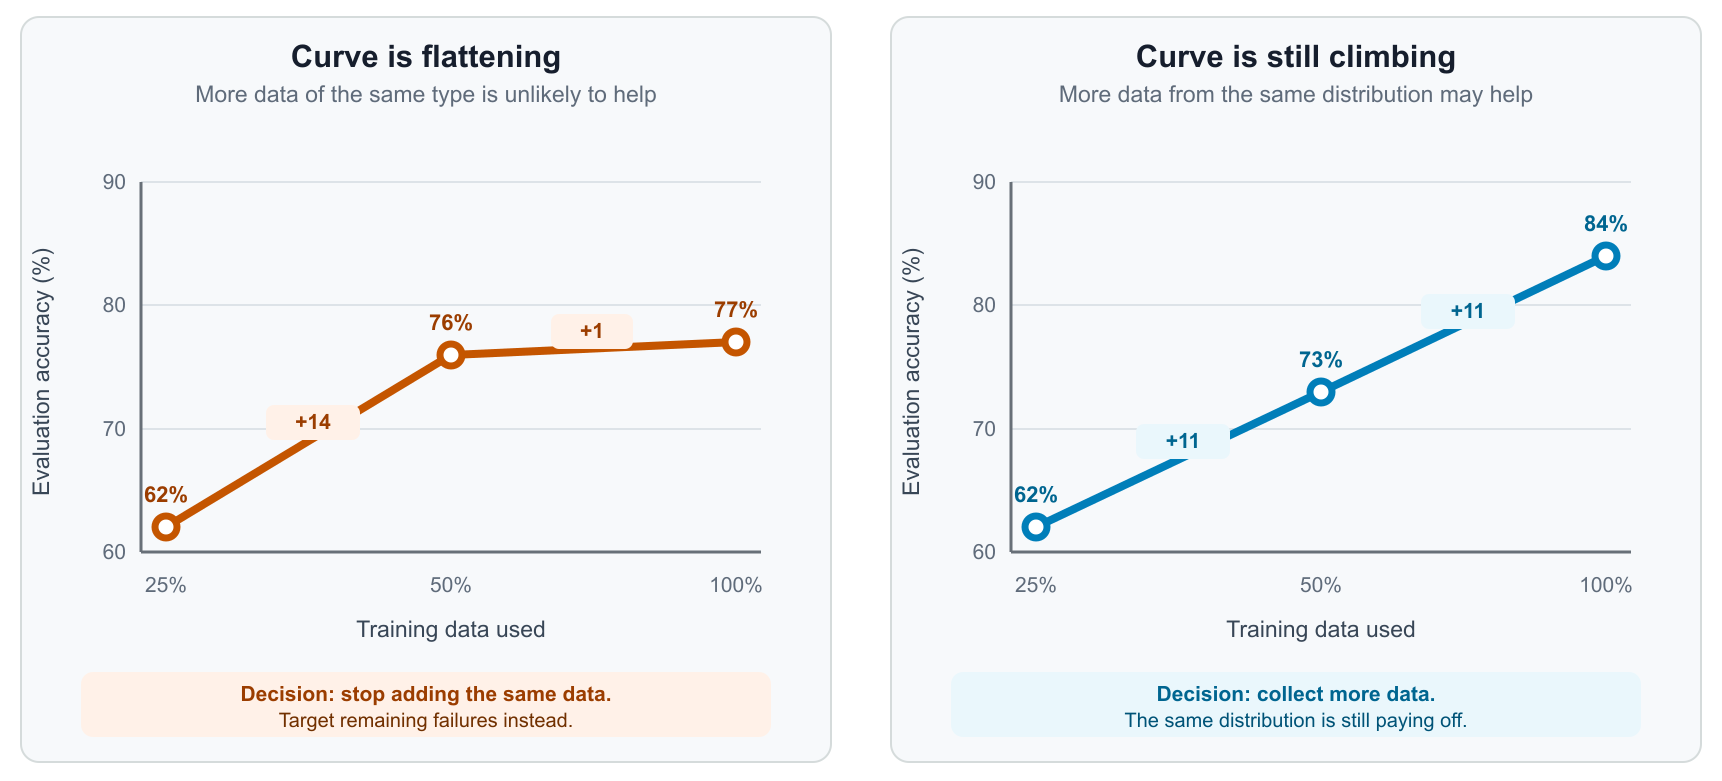
- 学習曲線分析でデータの飽和点を調べ、追加データの要否を判断する
- 品質と多様性でサブセットを選ぶと、全データ学習を上回る場合がある
- データ混交は汎用能力の保険であり、タスク性能向上のための手段ではない
学習曲線でデータ量を判断
教師ありファインチューニング(SFT)に使うデータ量は、一般的なタスクで高品質なサンプル約2,000件が一つの目安とされる。ただし、これはあくまで概算値であり、単純な形式変更なら500件、複雑な多段推論なら1万件以上が必要になることもある。それ以上に重要なのは、実際の本番トラフィックを代表する評価用ベンチマークを先に用意することだ。AWSのAmazon Bedrock evaluationsを利用すれば、自社のデータセットと指標でモデルを評価できる。
学習曲線分析では、全データを使って1回トレーニングを実施し、10〜20%のステップごとにチェックポイントを保存する。保存した各チェックポイントを評価セットで測り、データ量に対する性能の伸びを確認する。データ量を2倍にしても主要指標の改善が1〜2%未満であれば飽和とみなし、同じ種類のデータを増やしても効果は見込めない。
サブセット選択の効果
学習曲線が早い段階で飽和した場合、データ全体を使う代わりに、品質と多様性の基準で選んだサブセットを使う方が高精度になることがある。実際の研究例として、AlpaGasusは品質上位20%だけに絞った方が、全データで学習するより速く、かつ高いスコアを達成したと報告している。重複や低品質なサンプルを除くことで、勾配のノイズが減るためだ。
サブセット選択は、破滅的忘却の軽減にも効果を発揮する。学習に使うサンプルが少なければ、プリトレーニング済みモデルの能力から遠ざける勾配更新も少なくなる。そのため、データ混交の必要性が下がる可能性もある。
データ拡張の3つの方法
データが不足している場合の拡張方法として、複数の選択肢がある。一つはDeepSeek-R1のような強力なモデルを使って推論トレースを生成し、正解を検証して残す蒸留方式だ。もう一つは、ベースモデル自身に高温サンプリングで複数の回答を生成させ、最終回答が正しいものだけをフィルタリングする方法で、STaRの核となる考え方に近い。医療や法律など正しさが重要な領域では、専門家による記述をLLMで言い換えて増幅する方法もある。
さらにSelf-InstructやEvol-Instructのようなプロンプト拡張も有効である。拡張データを扱う際の原則は、文体の多様性を確保することと、すべての生成データが人間によるキュレーションデータと同じ品質基準を満たすことだ。合成データは重複や微細な誤りを生みやすいため、重複の除去とフィルタリングを必ず適用する必要がある。
データ混交で忘却を防ぐ
特定のタスクに特化したファインチューニングでは、他の能力が損なわれる破滅的忘却が問題になる。データ混交は、タスクデータと共にモデルの既存能力を保つためのデータを混ぜることで、この問題に対処する。記事に挙げられた例では、タスク70%、一般指示20%、安全性データ10%といった割合が紹介されている。Amazon Nova Forgeでは、こうした混交を各カスタマイズ段階で行える。
ただし、データ混交は必ずしもタスク性能を向上させない。一般データを混ぜるほどタスクデータのトークンが減るため、領域内の指標が下がることがある。サンプル数で5%の一般データでも、トークン数では勾配の80%以上を占める場合があり、トークンレベルの比率を監視することが重要だと記事は指摘している。
| 状態 | 推奨される対応 |
|---|---|
| 早期に飽和 | 高品質サブセットを選び、それを学習データとする |
| 100%時点でも改善中 | エラー分析に基づき、異なる種類のデータを追加収集 |
Treat data mixing as an insurance policy for general capabilities, not as a performance booster for your target task.
データ混交は、タスクの性能向上のためではなく、汎用能力を保つための保険と考えるべきだ。
今後の見通し
今後は、データ混交の比率を自動最適化するDoReMiやRegMixのような手法が注目を集めるとみられる。モデル規模やデータ量に応じた最適な比率は変わるため、環境に合わせて実験する必要がある。Amazon Nova Forgeの具体的な機能や操作方法が公開されれば、実務への応用が進むだろう。また、評価ベンチマークの整備が引き続き重要であり、AWSが提供する評価サービスがさらに充実することが期待される。
日本の開発者・IT企業にとっての意味
日本のIT企業がLLMを業務に適用する際、SFTはドメイン適応の主要な手段である。この記事の方法を使えば、データ量の判断を経験則ではなく学習曲線に基づいて行えるため、無駄なアノテーション費用を削減できる。また、サブセット選択によってモデルの汎用性を保ちながらタスク特化を進められる可能性がある。評価ベンチマークを先に作るという考え方は、品質管理の実務で重要な指針となる。AWSのサービスに依存しない内容も多いため、自社の基盤モデルにも応用できる。
気になる点
- 学習曲線分析には追加のトレーニングコストがかかるの?
- 記事では、全データで1回だけトレーニングし、途中のチェックポイントを評価する方法を勧めている。複数回のフルトレーニングを回すよりはコストを抑えられるが、具体的な金額はモデルやデータ量に依存するため、記事では言及されていない。
- Amazon Nova Forgeはどのように使うの?
- 記事では、自社データとAmazonが用意した学習データを混ぜてカスタマイズする機能として紹介されている。具体的な操作方法や料金については記載がないため、AWSの公式ドキュメントを確認する必要がある。
- データ拡張で生成したデータの品質を保つには?
- 生成された拡張データには、人間が作成したデータと同じ品質基準を適用することが原則だと記事は述べている。重複の除去や低品質サンプルのフィルタリングを必ず行い、それが終わるまでトレーニングセットに加えないことが求められる。
用語解説
- SFT
- 教師ありファインチューニングのこと。用意した入力と出力のペアを使ってモデルを追加学習させる手法。
- 破滅的忘却
- 新しいタスクを学習した際に、以前に学習した能力が大幅に失われる現象。
- 学習曲線分析
- トレーニングデータ量とモデル性能の関係をグラフにして、データ追加の効果を判断する手法。
- 合成データ
- 既存のデータから生成された人工的なデータ。拡張や多様化に使われる。
出典
Preparing data for supervised fine-tuning Part 2: Advanced data strategies
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する