- タスクに応じてモデルを自動選択・編成するオーケストレーション技術を研究プレビューとして公開
- Single・Cascade・Critiqueの3つの実行パターンを最適化問題として組み合わせる
- TerminalBench 2.1で品質4.9ポイント向上、推定コスト67%削減を実現
HydraFusionとは
GitHubは2026年9月4日、GitHub Copilot向けの新たな研究プレビュー「Project HydraFusion」を発表した。背景には、開発者に最適なモデルを提供したいという方針がある。2026年初めには「Auto model selection」が導入されており、HydraFusionはその考え方をさらに発展させたものと位置づけられる。
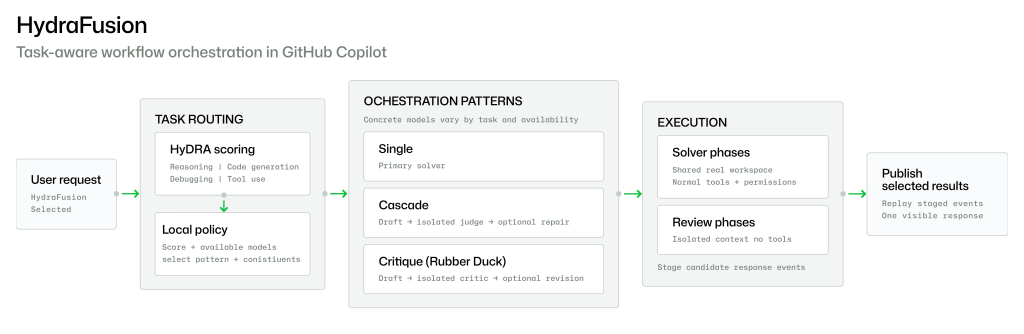
HydraFusionは、リクエストごとに複数プロバイダのモデルを実行時に組み合わせる。開発者はHydraFusionを通常のモデルと同じように選択するだけで、内部でどのモデルが使われるかやワークフローの構成は自動的に決定される。パフォーマンス、コスト、レイテンシのバランスを考慮しつつ、タスクごとに最適な実行パターンを選ぶ仕組みだ。
3つの実行パターンと運用原則
HydraFusionはワークフロー選択を最適化問題として扱う。推論、コード生成、デバッグ、ツール使用などの能力シグナルを参考に、品質基準を満たす最も効率的な実行パターンを選択する。現在、選択肢は「Single」「Cascade」「Critique」の3つだ。Singleは1つのモデルが直接タスクを解き、Cascadeは効率的なモデルが一度回答して品質ゲートで可否を判定する。Critiqueは別系統のモデルが独立してレビューし、元のモデルが修正する流れを取る。
また、HydraFusionは5つの運用原則に基づいて設計されている。ドラフトやクリティーク、リビジョン、フォールバックなど全ての工程のコストを集計する「完全な会計処理」、各工程のタイムアウトやキャンセルを明確にする「実行範囲の制限」、レビュー工程をツールなしの隔離環境で行う「隔離されたレビュー」、失敗時にパッチを適用しない「フェイルセーフな適用」、実行前にワークフロー定義やモデルの可用性を確認する「検証済みルーティング」の5つだ。これにより、リポジトリレベルのタスクでも安全にオーケストレーションを運用できるとしている。
ベンチマーク結果
オフライン評価では、HydraFusionの固定ポリシーを3つのエージェント向けベンチマークで検証した。比較対象はClaude Opus 5とGPT-5.6 Solで、各モデルは同じタスク入力、ツール、実行制限、価格設定、採点条件の下で評価された。品質評価では「検証済みタスク品質」、つまり正しく解答できたタスクの割合と、推定ワークフロー総コストが計測された。
TerminalBench 2.1では、HydraFusionはClaude Opus 5に比べて検証済みのタスク品質を4.9ポイント向上させ、推定コストを67%削減した。DeepSWEではOpus 5と比較して品質が1.5ポイント下回るものの、コストは36%削減している。内部ベンチマークであるCheckpointBenchでは、品質差は0.1ポイントにとどまり、コストを65%削減した。ただし、これらの結果は特定のベンチマーク改訂版、ワークフロー設定、モデルプール、価格前提に依存しており、すべてのモデルが同じ中程度の思考レベルで評価されたと注記されている。
開発プロセスと今後の展開
HydraFusionのルーティングポリシーは、実際のGitHub Copilot利用データを元に調整された。開発チームは実セッションから収集したCheckpointBenchを利用し、繰り返しポリシーを改善した。ポリシー候補の探索にはビームサーチが用いられ、品質、コスト、障害モードを固定ベースラインと比較しながら最適なルールを構築したという。
ただし、開発プロセスは一直線ではなかった。8月11日から8月25日の間に評価ハーネスで2件の運用障害が発生し、無効なランが除外された。こうした試行錯誤を経て、8月25日以降に最も強い性能を発揮する設定に到達した。現在は研究プレビュー段階であり、実開発者のワークロードで効果を検証し、品質、レイテンシ、信頼性、キャッシュ効率、コスト、安全性を最適化していく方針だ。
プレビューでは、まず1ターンの単一プロンプトによるコーディングタスクが推奨されている。将来的には、より長い反復的なセッションでのマルチターン性能に注力する予定としている。
| ベンチマーク | 品質(Opus 5比) | 推定コスト削減 |
|---|---|---|
| TerminalBench 2.1 | +4.9ポイント | 67% |
| DeepSWE | -1.5ポイント | 36% |
| CheckpointBench | -0.1ポイント | 65% |
So far, the reasoning and task solving capability [of HydraFusion] is at or better than Opus.
現時点で、HydraFusionの推論能力とタスク解決能力はOpusと同等かそれ以上だ。
今後の見通し
HydraFusionは研究プレビューであり、今後実開発者の利用データを通じて有効性が検証される見込みだ。現在は単一ターン中心のワークフローだが、マルチターン対応やモデルプールの拡張が進めば、より複雑なリポジトリ作業にも適用できるようになるとみられる。また、ベンチマーク結果が実際のワークロードでどの程度再現されるかが、今後の導入判断の鍵になる。GitHubはプレビューでのフィードバックを基にプロダクション品質に向けた調整を行うとしており、次に公表されるマルチターン評価や実環境でのコスト・レイテンシのデータが注目される。
日本の開発者・IT企業にとっての意味
日本のIT企業・開発者にとって、HydraFusionはAIコーディング支援のコスト構造を変える可能性がある。現在はモデルごとに料金を意識しながら選択したり、レビューを別のモデルに依頼したりする手作業が存在するが、HydraFusionがこれを自動化すれば、開発者はタスクの本質に集中できるようになる。特に国内ではPoCや開発効率の向上が重視されており、推定コスト削減は導入判断に大きな影響を与え得る。また、モデルオーケストレーションはGitHub Copilotだけでなく、自社のAIシステムにも応用可能な考え方だ。ベンチマーク結果が実運用でどれだけ再現されるかを確認しつつ、自社の開発フローへの取り入れを検討する価値がある。
気になる点
- HydraFusionは日本でも利用できるのか?
- 原文では研究プレビューとして公開されたと述べられているが、利用可能な地域については明記されていない。GitHub Copilotの既存機能に組み込まれている場合、日本からも利用できる可能性があるが、現時点では公式な地域情報は不明だ。
- HydraFusionが使用するモデルはどれか?
- 複数プロバイダのモデルを選択すると記述されている。ベンチマークではClaude Opus 5とGPT-5.6 Solが比較対象として使われており、モデルプールにはこれらを含む複数のモデルが含まれると考えられる。ただし、具体的な構成や利用されるモデルの一覧は公表されていない。
- コストは従来と比べてどう変わるのか?
- ベンチマークでの推定コスト削減率が報告されている。Claude Opus 5と比較して、TerminalBench 2.1では67%、DeepSWEでは36%、CheckpointBenchでは65%の削減とされる。実際の請求額はタスクの種類や利用状況によって変わるため、個々のケースでの見積もりが必要だ。
用語解説
- オーケストレーション
- 複数のAIモデルを状況に応じて組み合わせ、タスク処理を最適化する仕組み。
- TerminalBench 2.1
- ターミナル環境で複雑な多段階タスクを実行するコーディングエージェントの評価ベンチマーク。
- ビームサーチ
- 複数の候補を同時に探索し、評価スコアに基づいて最適な選択肢を絞り込む探索アルゴリズム。
出典
Project HydraFusion: Frontier quality via multi-model orchestration
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する