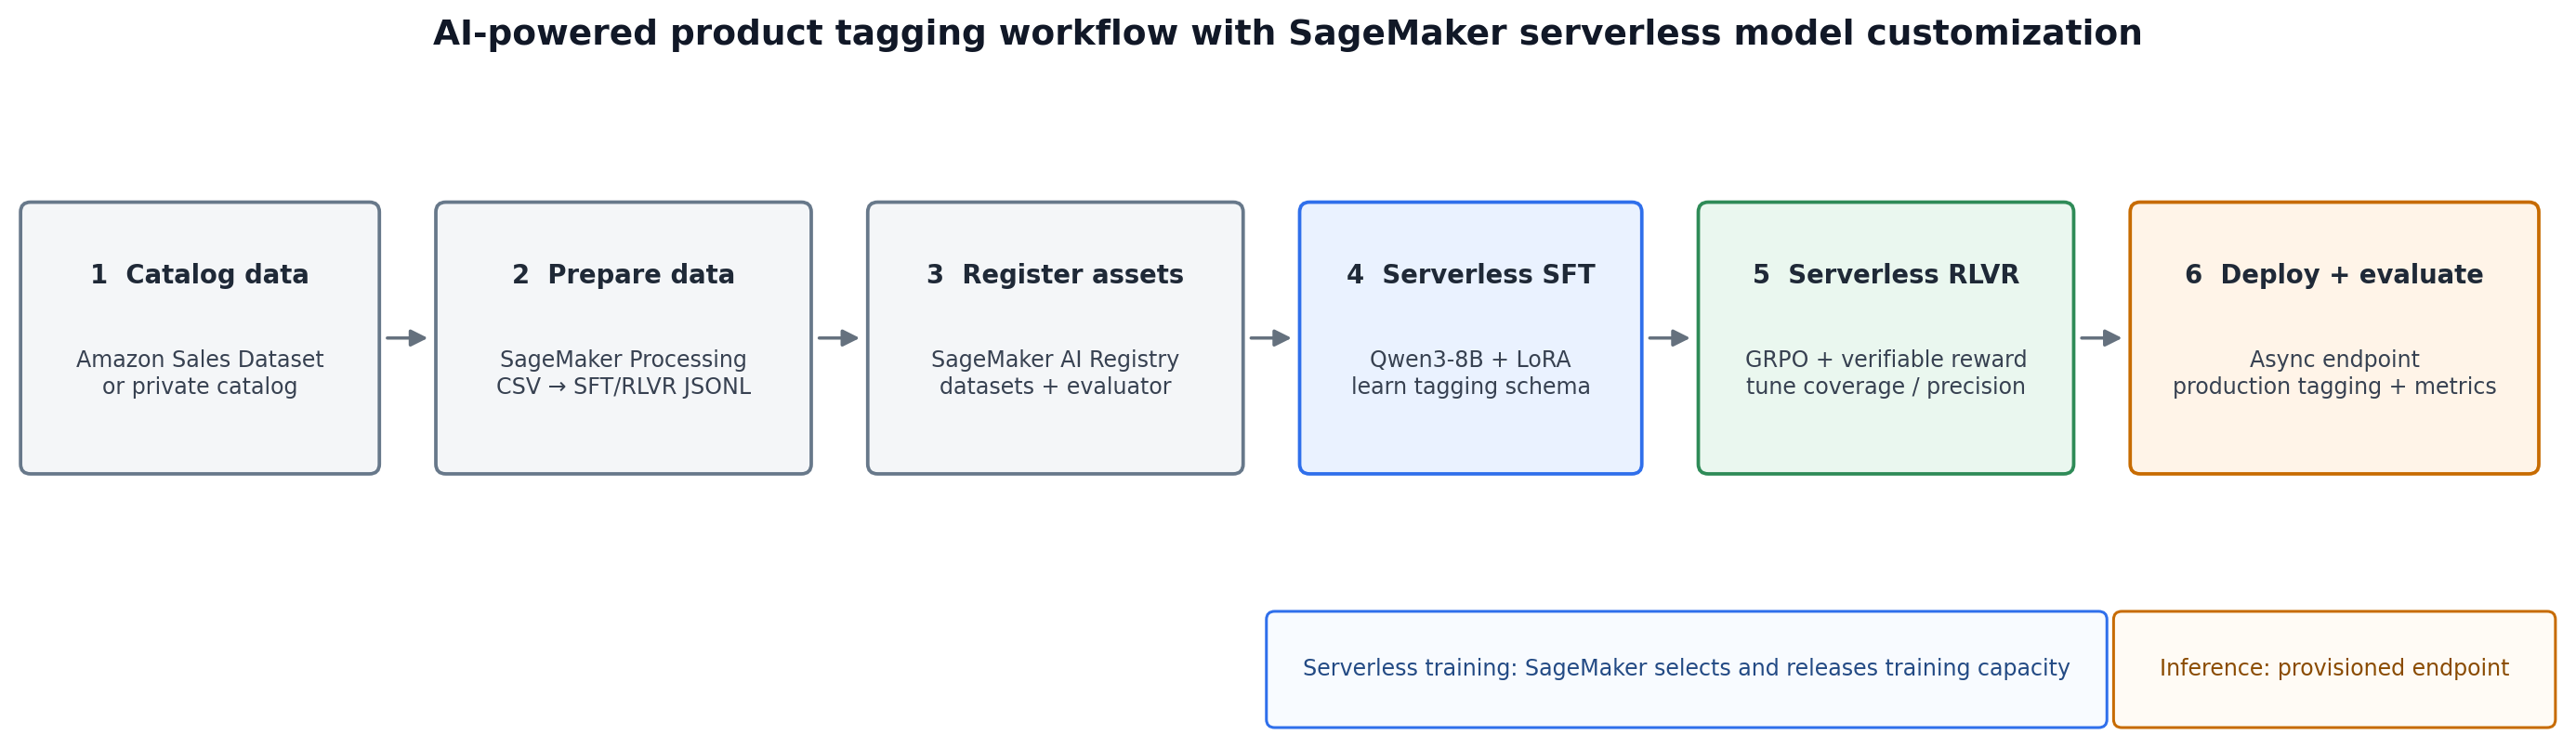
- Qwen3-8BをSFTで9カテゴリのタグ付けスキーマに適応させる
- RLVRとGRPOで網羅性と精度のトレードオフを報酬関数で最適化する
- 学習はサーバーレス、推論はml.g6.2xlargeの非同期推論で実行する
何が公開されたか
AWSの機械学習ブログで、小売カタログ向けの商品タグ付けシステムをAmazon SageMakerで構築する手順が公開されました。対象となるのは、商品名・説明・カテゴリパスなどから一貫したタグを付与する処理です。SKU(在庫管理単位)が数千件に及ぶと手作業でのタグ付けは現実的でなく、汎用のフロンティアモデルを使ってもスキーマの一貫性を保つのが難しいという課題があります。
この記事では、汎用モデルではなく小規模なオープンウェイトモデルを用途に合わせてカスタマイズする考え方が示されています。タクソノミー(分類体系)が安定しており、出力をプログラムで採点できる場合には、この方法が適することが多いとしています。同記事は、ワークフローが必要としない広い能力に対してリクエストごとにコストを払わずに済む点も利点として挙げています。
SFTとRLVRの2段階
学習は2段階です。まずQwen3-8Bに対して教師あり微調整(SFT)を行い、9カテゴリの出力スキーマと入出力の形式を教えます。記事では、SFTがスキーマ遵守の面で最も大きな改善をもたらすと期待されると述べられています。SFTはLow-Rank Adaptation(LoRA)で行われ、記事の例ではlora_rankが16、max_epochsが3、sequence_lengthが4Kに設定されています。
次に、検証可能な報酬による強化学習(RLVR)をGroup Relative Policy Optimization(GRPO)で行います。GRPOは各プロンプトに対して複数の候補を生成し、この実装ではrollout_n=8で8個の候補を出し、評価器がそれぞれを独立に採点します。KL正則化によってSFTの参照モデルからの乖離を抑えつつ、グループ内の相対的な優劣から方策を更新する仕組みです。
報酬関数は決定論的で、9カテゴリの出力形式を確認し、0.5のしきい値でのファジーマッチングを使って予測タグと参照タグを比較します。報酬はrecall、precision、accuracyなどに重みを配分し、学習の序盤はrecall、後半はprecisionを重視するようにスケジュールを変えます。これにより、タグの取りこぼしと不要なタグのトレードオフをプロンプトではなく報酬の中で明示的に扱えるとしています。
サーバーレス学習の位置づけ
この記事の特徴は、学習にサーバーレスモデルカスタマイズを使う点です。従来のamazon-sagemaker-examplesリポジトリのQwen3-8Bの例では、顧客が選択したGPUインスタンスとカスタムトレーニングイメージを使うAmazon SageMaker Training Jobsが使われていました。今回の手順ではPython SDK v3のSFTTrainerとRLVRTrainerを使い、コンピュート設定を指定しない場合、SageMakerが学習キャパシティを選定・解放します。
SFTとRLVRにはカスタムトレーニングイメージは不要です。一方で推論はサーバーレスではなく、ml.g6.2xlargeの非同期推論エンドポイントを使います。バッチ指向のカタログ拡充では、リクエストをキューに入れて結果をS3に書き出せるこの構成が適しているとしています。vLLMのカスタムイメージは推論にのみ使用され、サーバーレスの学習段階では使いません。
データはAmazon SageMaker Processingジョブで変換され、S3上のJSONLファイルとして書き出された後、Amazon SageMaker AI Registryにバージョン付きデータセットとして登録されます。カスタマイズのトレーナーは、従来のトレーニング入力チャネルではなく、このバージョン付きデータセットのARNを消費する点も従来との違いです。
前提条件と制約
実施にはいくつかの前提があります。ローカルツールとしてPython 3.11以上、AWS CLI v2、pandas、Amazon SageMaker Python SDK v3、vLLMの推論イメージをビルドする場合はDockerが必要です。データセットにはKaggleのAmazon Sales Dataset(1,000件超の商品レコード)を使うか、同じプロンプト/ターゲットのスキーマに変換できる自社カタログを使います。
サーバーレスモデルカスタマイズは、Qwen3-8BのSFTとRLVRに対応したAWSリージョンとモデル/手法の組み合わせで利用する必要があります。また、非同期エンドポイント用にml.g6.2xlargeとエンドポイント数のホスティングクォータを確保する必要があります。権限は最小権限とし、root認証情報や長期のアクセスキーは避け、AWS IAM Identity Centerなどの短命な認証情報を使うよう求められています。
記事に記載された9カテゴリのタグ付けスキーマやデータ変換は、このウォークスルー向けに用意されたものです。自社カタログに適用する場合は、スキーマと入力項目を自組織の承認済みデータに合わせて置き換える必要があります。
| 項目 | SageMaker Training Jobs | サーバーレスカスタマイズ |
|---|---|---|
| コンピュート | 顧客がGPUインスタンスを選択 | 未指定ならSageMakerが選定・解放 |
| トレーニングイメージ | カスタムイメージを使用 | SFT/RLVRはカスタムイメージ不要 |
| クライアント | 従来のSMTJの例 | Python SDK v3のSFTTrainer/RLVRTrainer |
The reward is deterministic: it checks the nine-category output format and uses fuzzy matching at a 0.5 threshold to compare predicted tags with the reference.
報酬は決定論的である。9カテゴリの出力形式を確認し、0.5のしきい値でのファジーマッチングを使って予測タグと参照タグを比較する。
今後の見通し
今回公開されたのは手順のウォークスルーであり、タグ付け精度の具体的な改善幅やコスト比較の数値は示されていません。今後、サーバーレスモデルカスタマイズが対応するモデルや手法、リージョンが広がれば、同様の小規模オープンウェイトモデルの業務適用が進むとみられます。判断材料としては、Qwen3-8BのSFT・RLVRに対応するリージョンの一覧、サーバーレス学習の料金体系、非同期推論を含めたエンドツーエンドのレイテンシとコストが明らかになることが挙げられます。また、報酬関数の重み配分を変えたときにタグの精度と網羅性がどう動くかの実測値が出れば、自社カタログへの適用可否をより具体的に評価できると考えられます。
日本の開発者・IT企業にとっての意味
この事例は、汎用のフロンティアモデルをすべてのリクエストに使うのではなく、用途を絞った小規模オープンウェイトモデルを自社データで調整するという設計判断を示しています。商品タグ付けのように出力スキーマが固定され、正解と機械的に比較できるタスクでは、報酬を自分で定義して強化学習に使えるため、評価用の別の大規模モデルを用意せずに済みます。日本のIT企業にとっては、ECや社内カタログ、マスタデータ整備といった定型の分類業務で、精度とコストのトレードオフを自組織の基準で設計できる点が実務上の意味を持ちます。一方で、学習はサーバーレスでも推論はml.g6.2xlargeの常設エンドポイントが必要であり、権限設計やクォータ確保、データのバージョン管理を含めた運用体制を整える必要があります。まずは自社のタクソノミーが安定しているか、出力をプログラムで採点できるかを見極めることが導入判断の出発点になるとみられます。
気になる点
- 日本国内のリージョンでも利用できますか
- 原文には、Qwen3-8BのSFTとRLVRに対応したAWSリージョンとモデル/手法の組み合わせで使う必要があると書かれていますが、対応リージョンの具体的な名前は挙げられていません。利用可否はAWSの公式ドキュメントで確認する必要があります。
- 学習にかかる費用はどのくらいですか
- 原文には料金やコストの数値は記載されていません。コンピュート設定を指定しない場合にSageMakerが学習キャパシティを選定・解放する仕組みであることは説明されていますが、課金体系は示されていないため、現時点では具体的な金額は分かりません。
- 汎用モデルからこの構成に移行できますか
- 原文は、タクソノミーが安定していて出力をプログラムで採点できる場合に、小規模オープンウェイトモデルのカスタマイズが適することが多いとしています。SFTでスキーマを教え、RLVRで網羅性と精度を最適化する流れです。ただし9カテゴリのスキーマはウォークスルー固有で、自社カタログ用の変換が必要です。
用語解説
- SFT(教師あり微調整)
- 正解付きの入出力例を使ってモデルを追加学習させ、特定タスクや出力形式を覚えさせる手法。
- RLVR(検証可能な報酬による強化学習)
- 正解と機械的に比較できる報酬関数を使い、モデルの振る舞いを最適化する強化学習の考え方。
- GRPO
- Group Relative Policy Optimization。複数の候補を生成し、グループ内の相対的な優劣から方策を更新する強化学習アルゴリズム。
- LoRA
- 低ランク適応。モデル全体ではなく一部のパラメータだけを学習させる軽量な微調整手法。
- 非同期推論
- リクエストをキューにためて処理し、結果をS3などに書き出すAmazon SageMakerの推論方式。
出典
Build an AI-powered product tagging system with Amazon SageMaker serverless model customization
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する