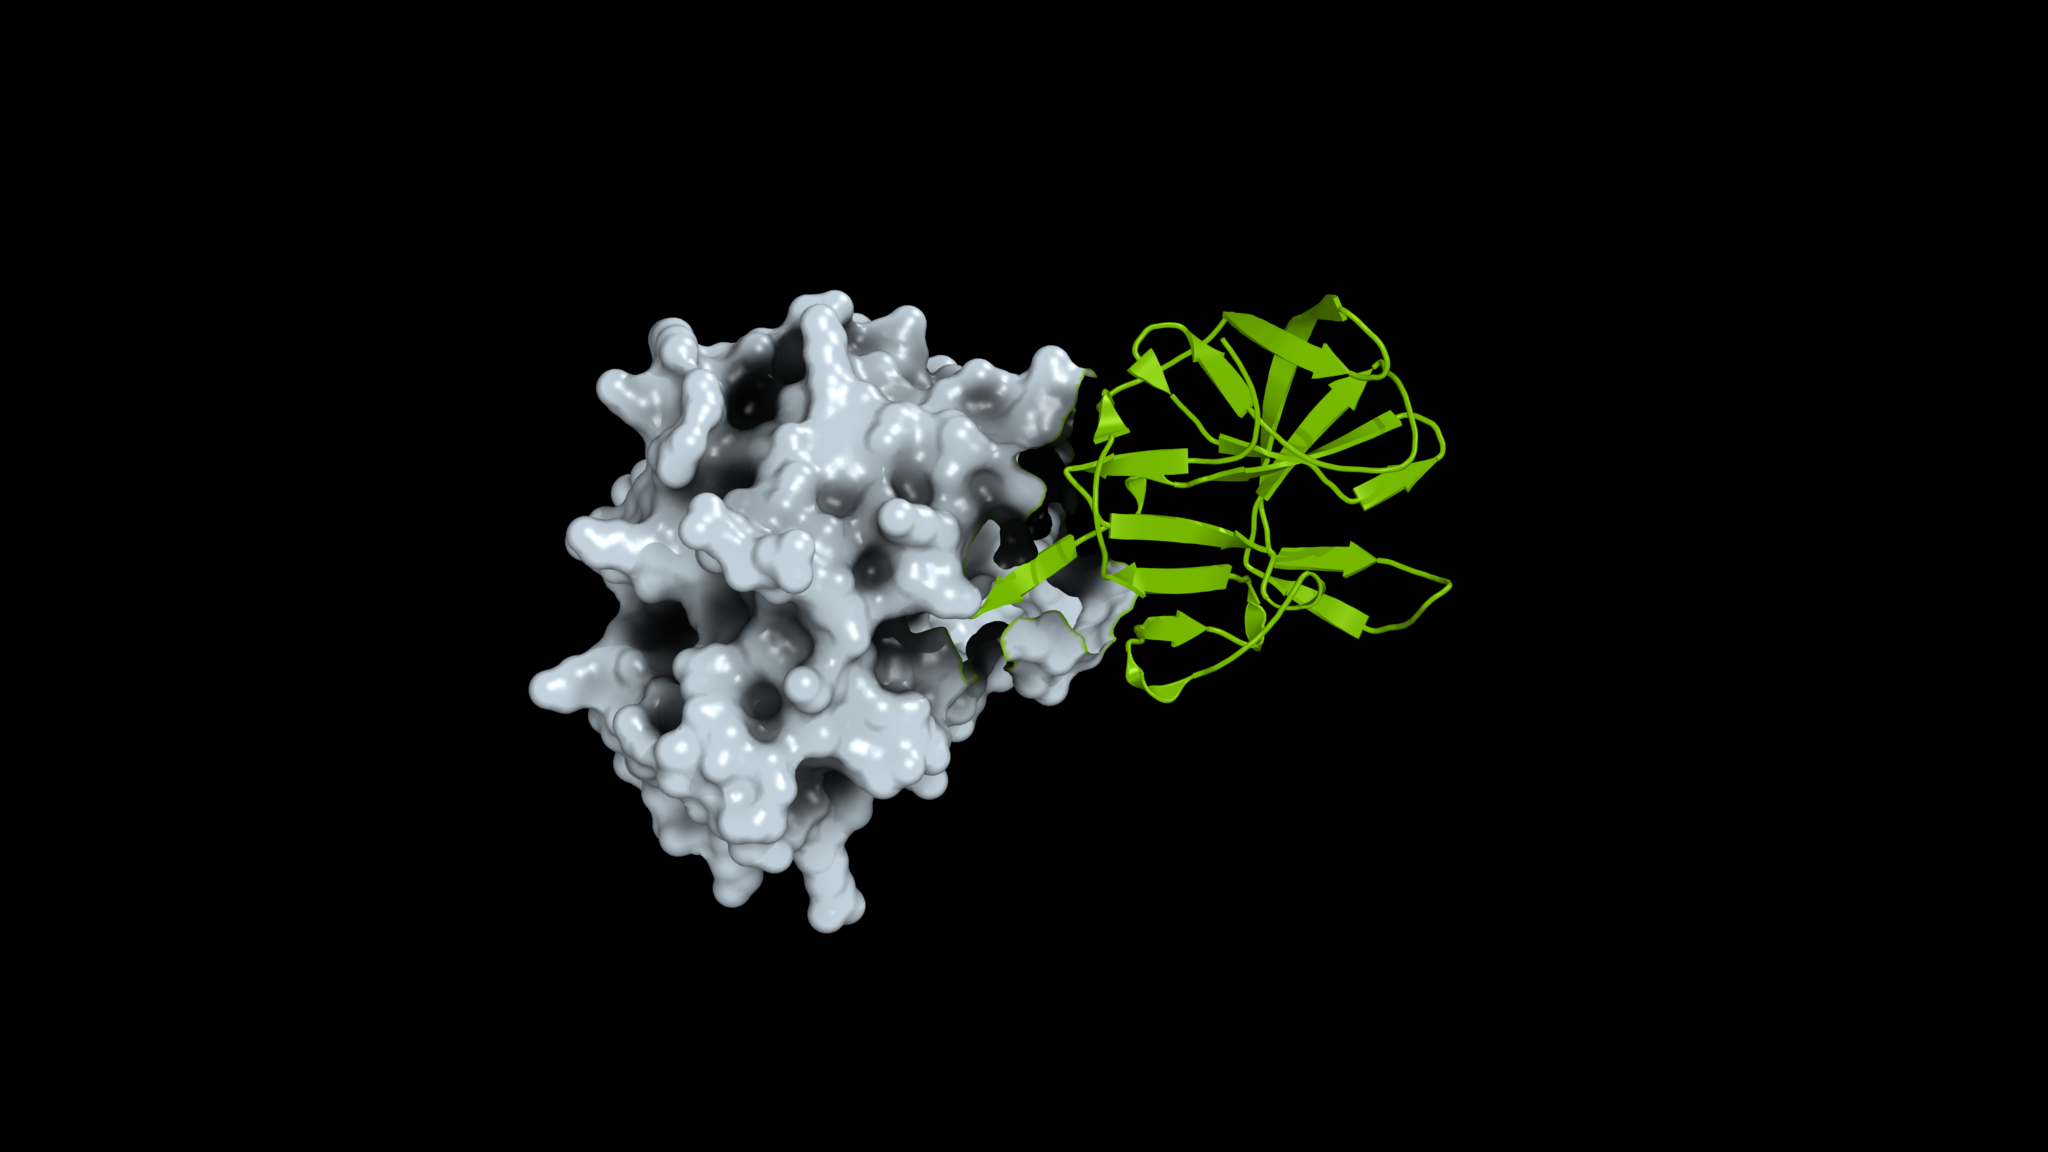
- 2,800種類を超えるウイルスのタンパク質複合体について予測3D構造を公開
- AlphaFold2とNVIDIA BioNeMoで推論を数千プロテオーム規模に拡大
- 追加された相互作用の約30%は科学にとって新規で、Protein Data Bankに未収載
何が公開されたのか
NVIDIAは、Google DeepMindやEMBL-EBIなどを含む国際的な研究連携に参加し、2,800種類を超えるウイルスのタンパク質複合体について予測された3D構造を公開したと発表した。データはAlphaFold Databaseを通じて、世界中の科学者が利用できる形で提供される。NVIDIAは合わせて、構造予測に使ったGPUアクセラレーション済みのワークフロー「BioNeMo Structure Prediction Pipeline」も公開した。研究者は自分の対象について、タンパク質の配列から予測3D構造を得られるようになる。
対象となったのは、ヒトに感染することが知られるウイルス科で、一般的な風邪のウイルスからMpoxのような新興の脅威まで含まれる。連携にはCoalition for Epidemic Preparedness Innovations(CEPI)、EMBL-EBI、Google DeepMind、NVIDIA、ソウル大学校、成均館大学校、スイスバイオインフォマティクス研究所、グラスゴー大学が名を連ねる。公開は、ニューヨークで開かれた世界経済フォーラムが招集した国連総会の会合に合わせて行われた。
技術的な新しさ
多くのタンパク質は単独では働かず、複数の分子が集まった複合体として機能する。ワクチンや薬が標的にするのは、こうした複合体の構造であることが多い。新型コロナウイルスではスパイクタンパク質の3D構造の理解がワクチン設計の土台になったが、他の数千種のウイルスについては同等の構造知見が存在しなかった。今回のデータセットは、その空白を埋め始めるものと位置づけられる。
構造予測にはGoogle DeepMindのAIモデルAlphaFold2を用い、NVIDIA BioNeMo Inference Runtimeで最適化した。これにより推論を数千のウイルスプロテオームへ拡大し、各ウイルスがコードする複合体(相互作用するタンパク質の集まり)を予測できたという。従来、タンパク質の構造決定は結晶化とX線照射を要し、1構造あたり数年と数千ドルかかり得た。AlphaFold2は数分で予測でき、一括処理に向く。高信頼度の予測は実験手法で検証する流れになる。
既存データベースとの関係
追加されたタンパク質相互作用のうち約30%は科学にとって完全に新しいもので、実験的に決定された構造の主要リポジトリであるProtein Data Bankには記録されたことがない形だとされる。NVIDIAの担当者はこのデータベースを「仮説生成のエンジン」と表現し、生物学者とAIコミュニティが単一分子ではなく複合体としてタンパク質相互作用を調べられるようにすると述べている。
今回の追加により、AlphaFold Databaseは科学界でカタログ化されているほぼすべてのタンパク質をカバーする2億6,000万件以上のタンパク質・複合体予測を保持するに至った。予測には信頼度のラベルが付き、ウイルス複合体がどのような形を取り得るか、個々のタンパク質がウイルスプロテオーム内でどう相互作用し得るかを示す。EMBL-EBIの暫定所長は、データをオープンにすることが診断や治療、ワクチン開発の理解に重要だとし、研究が手薄だったウイルスも対象に含まれ、流行に直面する低資源環境の科学者の障壁を下げると述べている。
注意点と限界
公開されるのはあくまで予測構造であり、実験的に確認された構造ではない。そのため信頼度のラベルが付され、高信頼の予測は実験手法で検証することが想定されている。予測が実際の複合体構造をどの程度の精度で再現するかの定量的な評価は、原文では示されていない。
また、データセットの利用条件やライセンス、BioNeMo Structure Prediction Pipelineを動かすために必要な計算資源の詳細は原文に記載がない。パンデミックへの備えという目的は、予測データを実際のワクチンや治療薬の開発につなげられるかにかかっており、そこは今後の検証課題となる。
| 項目 | 従来の実験手法 | AlphaFold2による予測 |
|---|---|---|
| 手法 | タンパク質を結晶化してX線を照射 | AlphaFold2で3D構造を予測 |
| 所要時間 | 1構造あたり数年かかる場合がある | 数分で予測でき、一括実行が可能 |
| コスト | 1構造あたり数千ドル | 原文に記載なし |
When the next pandemic happens, there may be something that comes out of the blue, and we'll be lacking the knowledge we had for COVID.
次のパンデミックが起きたとき、まったく予想外の何かが現れ、私たちはCOVIDのときに持っていた知識を欠いているかもしれません。
今後の見通し
次のパンデミックに備えるには、事前に知識を蓄積しておくことが重要だという問題意識が背景にある。Center for Global Developmentの分析では、2050年までにCOVID-19と同程度に深刻なパンデミックに世界が見舞われる確率は約50%と推定されている。今後は、公開された予測構造が実際の研究でどの程度使われ、創薬やワクチン設計の候補選定にどう寄与するかが焦点になる。予測精度の検証結果や、低資源環境の研究機関での利用状況が明らかになれば、この取り組みの実効性を判断できるとみられる。
日本の開発者・IT企業にとっての意味
創薬やワクチン開発にAIを使う動きは、日本の製薬企業や創薬スタートアップにとっても他人事ではない。今回のポイントは、予測モデルそのものよりも、GPU最適化された推論ワークフローが公開され、数千規模のウイルスプロテオームという大量の対象に一括で適用された点にある。自社の標的タンパク質に対して同じパイプラインを回せる余地が生まれたことは、構造解析に外部委託や長い実験期間を要してきた企業にとって選択肢の拡大につながり得る。一方で、公開されるのは予測であり、創薬の判断には実験による検証が欠かせない。データの信頼度ラベルや複合体としての構造をどう社内の探索プロセスに組み込むかが、実務上の設計課題になるとみられる。
気になる点
- このデータは無料で誰でも使えますか
- 原文では、AlphaFold Databaseを通じて世界中のどの科学者でもオープンに利用できるとされています。EMBL-EBIの担当者も、研究が手薄だったウイルスを含むことで低資源環境の科学者の障壁を下げると述べています。ただし、具体的なライセンス条件や商用利用の可否は原文に記載がなく、現時点では確認できません。
- 予測構造はそのまま創薬に使えますか
- そのまま使えるという位置づけではなく、信頼度のラベルが付いた予測として提供されます。原文では、科学者が高信頼度の予測を実験手法で検証する流れが示されており、候補探索や仮説生成を加速するための材料と考えるのが妥当です。
- 自社のタンパク質でも同じ予測を実行できますか
- NVIDIAがBioNeMo Structure Prediction Pipelineを公開しているため、研究者が自分の標的について配列から予測3D構造を得る道が用意されています。ただし、必要なGPU構成や実行手順、対応する配列の規模などの詳細は原文に記載がなく、別途ドキュメントの確認が必要です。
用語解説
- AlphaFold2
- Google DeepMindが開発した、タンパク質がどのような3D構造に折りたたまれるかを予測するAIモデル。
- BioNeMo
- NVIDIAが提供する、創薬・生命科学向けのAIモデルと推論ランタイムの基盤。
- プロテオーム
- ある生物やウイルスが持つタンパク質の全体像を指す用語。
- タンパク質複合体
- 複数のタンパク質分子が結合し、まとまりとして機能する構造。
- Protein Data Bank
- 実験的に決定されたタンパク質構造を収める主要な公開リポジトリ。
- 推論
- 学習済みのAIモデルに新しい入力データを処理させ、結果を得ること。
出典
How Open Science Can Help Researchers Prepare for the Next Pandemic
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する