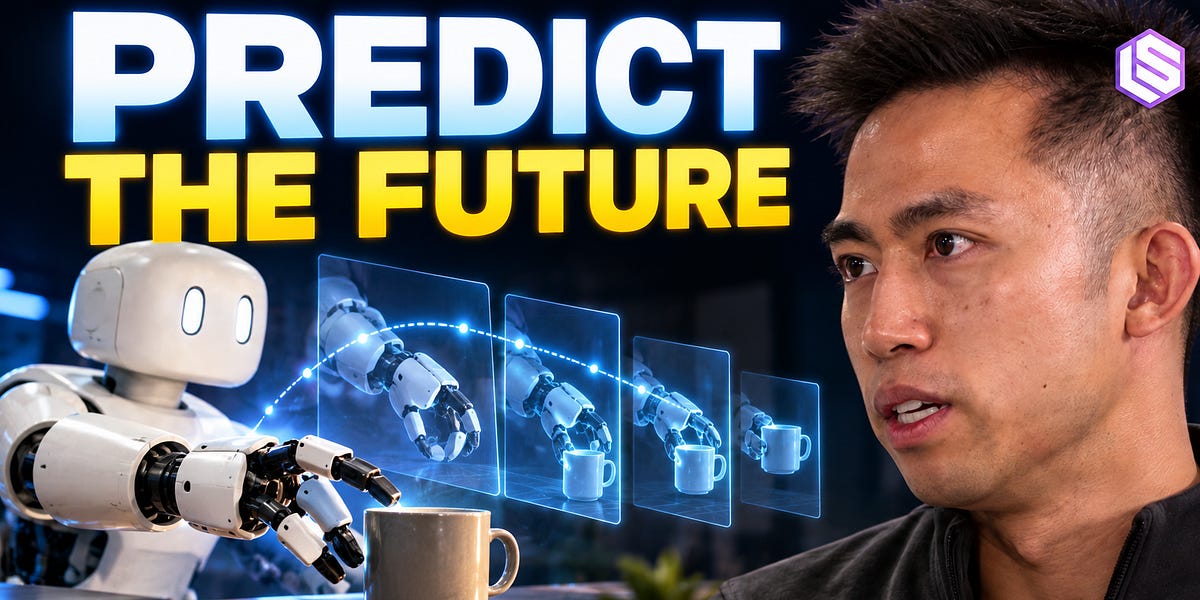
- Dyna-2は100万時間超の人間映像で学習した世界アクションモデルで、行動と未来映像の両方を出力する
- ナプキン折りを24時間連続で成功率99.4%、外食チェーンのDin Tai Fungでは毎日数千枚を処理
- 新タスクは45分程度のデモで学習可能。データの確保が最大の課題で合成データにも注目
発表された内容
Dyna Roboticsは、世界アクションモデル「Dyna-2」を発表しました。100万時間を超える人間の映像で事前学習したモデルで、人間のデータにおけるスケーリング則を4桁にわたって確認したと主張しています。同社はこれに続き、実機で動作する物理ロボットエージェント「Dyna-2.1」を公開しました。ポッドキャストには共同創業者兼チーフサイエンティストのJason Ma氏が出演し、技術の仕組みと実運用の状況を説明しています。Ma氏はAlphaGo、ペンシルベニア大学(Penn)、NVIDIA、Google DeepMind、Eurekaプロジェクトを経て同社を創業したと紹介されています。
実運用の例として挙げられているのがレストランでのナプキン折りです。Dynaのモデルはナプキン折りを24時間連続でこなし、成功率99.4%を記録したとされています。作業中にナプキンの山を崩してしまった後も、作業を再開できた点が強調されています。外食チェーンのDin Tai Fungでは、毎日数千枚のナプキンが処理されているとのことです。エピソードにはTakuと呼ばれるロボットのライブデモも収録されています。
世界アクションモデルとは
世界アクションモデルは、将来の映像や世界の状態を予測する「世界モデル」に、ロボットが実行する行動の生成を組み合わせたものです。入力にはロボットのカメラが捉えた過去数秒の映像や画像に加え、関節の角度を計測するエンコーダの値、作業を指示する言語が使われます。出力はロボットがハードウェア上で実行する行動と、未来の映像です。Ma氏は、未来の映像を先に生成し、それを手がかりに行動を決める流れを、言語モデルのチェーン・オブ・ソート(推論の途中過程を明示させる手法)に近い考え方だと説明しています。
モデルの内部には拡散トランスフォーマーが使われており、エンコーダのみで構成されたトランスフォーマー・アーキテクチャを採用しているとのことです。拡散モデルはランダムなノイズから反復計算を経て、精細な画像などを生成する手法で、画像生成の分野で実績があります。ロボットの場合も精密で滑らかな行動を生成する必要があり、画像生成と似た性質を持つため、この構成が向いているとMa氏は説明しています。生成手法としてはフローマッチングも用いられています。
データと汎化の課題
ロボティクス最大の課題として挙げられているのがデータです。言語モデルにはインターネットという大規模な学習源がありますが、ロボットにはそれに相当するものがなく、実世界の行動データをどう集めるかがスケーリングの制約になるとMa氏は述べています。同社は人間の一人称視点の映像やロボットのデモンストレーションを組み合わせ、異なる身体構造のロボット間で知識を移す「クロス・エンボディメント」転移に取り組んでいます。合成環境やシミュレーションを使い、モデル自身が学習データを生成する方向性も議論されています。
新しいタスクの学習コストも注目点です。Ma氏によれば、45分程度のデモンストレーションで新しいタスクを覚えられるといいます。また同氏は、特化型の解を個別に作り込むのではなく、データを大規模に集めて学習させる方向を、ロボティクスにおけるBitter Lesson(汎用的な手法と計算資源が最終的に優位になるという考え方)として位置づけています。GPT-6やコーディングエージェント、AIが生成するシミュレーション環境が研究をどう変えるかも話題に上っています。
実運用とハードウェア
ハードウェアは自社で設計しています。既製のヒューマノイドを使うのではなく、車輪型のセミヒューマノイドを選んだことが述べられています。オンデバイスでの推論とモデルの蒸留が不可欠だとMa氏は説明しています。器用なハンドについては発熱が課題として残っているとのことです。
実運用の例として、ホテルのBest Westernと外食のDin Tai Fungが挙げられています。PoC(実証実験)と本番展開は別物だという点も議論の中心です。エージェント・ハーネスによって、ロボットが1時間にわたる複数ステップの作業を実行できるとされています。
まだ分かっていないこと
今回参照できる情報はポッドキャストの内容と公開されたトピックの一覧に基づくもので、詳細なベンチマークや学習曲線の数値、モデルの規模は示されていません。「4桁にわたるスケーリング則」の具体的な内容や、成功率99.4%がどの条件で測られたのかも明らかではありません。価格や提供地域、対応するタスクの範囲についても言及がありません。
世界アクションモデルとVLA(視覚・言語・行動モデル)の比較はトピックとして挙げられているものの、本記事で参照できる範囲では詳細な比較は示されていません。日本での展開や日本語での利用についても触れられていないため、国内導入の可否は現時点では判断できません。
| 項目 | Dyna-2 | Dyna-2.1 |
|---|---|---|
| 種類 | 世界アクションモデル | 物理ロボットエージェント |
| 学習データ | 100万時間超の人間映像 | 原文に記載なし |
| 役割 | 未来映像の予測と行動の生成 | 実機でのタスク実行 |
So the way I think about it is this is kind of analogous to chain of thought, you know. And basically, the models are reasoning in the visual, the physics space, and then outputting actions.
私の考え方では、これは一種のチェーン・オブ・ソートに似ています。つまりモデルは視覚と物理の空間で推論してから、行動を出力しているのです。
今後の見通し
実機エージェントがレストランやホテル以外の現場にも広がるかどうかが、次の焦点になるとみられます。判断材料として重要なのは、成功率99.4%という数値がどの条件で測られたのか、第三者による検証が行われるのか、そして価格や提供地域がどう設定されるかです。世界アクションモデルとVLAのどちらが実運用に適するかについても、公開された比較データが出れば評価できるようになります。ハンドの発熱などハードウェア側の課題がどこまで解消されるかも、長時間の自律稼働を左右するとみられます。
日本の開発者・IT企業にとっての意味
物理AIの分野では、モデルの性能だけでなく、実現場での長時間稼働と復帰能力が商用化の分かれ目になりつつあります。日本のIT企業にとっての意味は二つあります。一つは、ロボット向けのモデル設計で「未来の状態を予測してから行動を生成する」という選択肢が現実味を帯びてきたことです。画像生成で使われてきた拡散トランスフォーマーやフローマッチングの知識が、ロボティクスに応用できる範囲が広がっています。もう一つは、データ収集とオンデバイス推論の設計です。45分のデモで新タスクを学習できるという主張が正しければ、現場ごとのデータをどう集め、蒸留して端末側で動かすかが導入コストを左右します。PoC止まりにしないための運用設計が問われることになります。
気になる点
- Dyna-2の「世界アクションモデル」は、よく聞くVLAと何が違うのですか
- 世界アクションモデルは、ロボットが実行する行動に加えて未来の映像を出力し、それを手がかりに行動を決める点が特徴です。Ma氏は言語モデルのチェーン・オブ・ソートに近い考え方だと説明しています。VLA(視覚・言語・行動モデル)との違いはトピックとして挙げられていますが、本記事で参照できる範囲では詳細な比較は示されていません。
- 新しい作業を覚えさせるには、どのくらいのデータと期間が必要ですか
- Ma氏は、45分程度のデモンストレーションで新しいタスクを学習できると述べています。ナプキン折りについては、24時間連続で成功率99.4%を記録したとの報告があります。ただし、どのような条件やタスクで測られた数値なのか、必要な計算資源や学習時間の詳細は公表されていません。
- 日本企業でも導入できますか。費用はどのくらいですか
- 原文ではホテルのBest Westernや外食のDin Tai Fungでの展開が紹介されていますが、日本での提供や導入可否、価格については言及がありません。現時点では公表されていないというのが正確なところです。提供地域や料金体系、対応タスクの一覧が示されれば、導入判断ができるようになります。
用語解説
- 世界アクションモデル
- 将来の映像や世界の状態を予測し、その予測を手がかりにロボットの行動も生成するモデル。
- 拡散トランスフォーマー
- ノイズから反復計算で精細なデータを生成する拡散モデルに、トランスフォーマーを組み合わせた構成。
- フローマッチング
- ノイズからデータへの変換経路を効率的に学習する生成手法。拡散モデルと並んで用いられる。
- VLA(視覚言語行動モデル)
- 視覚情報と言語指示からロボットの行動を出力するモデル。原文では世界アクションモデルとの違いが話題になっている。
- クロス・エンボディメント転移
- ある身体構造のロボットで得た知識を、異なる構造のロボットに移して活用すること。
- モデル蒸留
- 大きなモデルの知識を小さなモデルに移し、端末上でも動かしやすくする手法。
出典
Dyna-2: General Purpose Physical Agents with Hour-Long Autonomy — Jason Ma, Dyna Robotics
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する