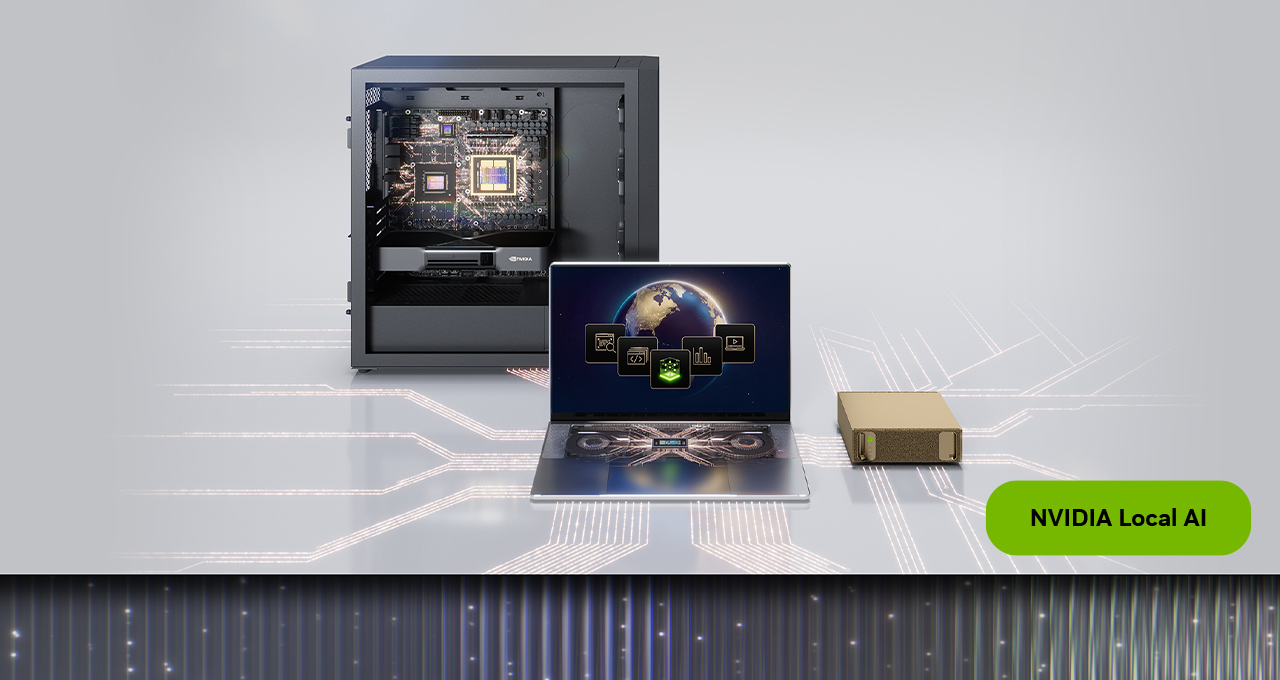
- RTX Spark、DGX Spark、DGX Stationの3系統をGTCベルリンで展示
- DGX Sparkは最大8台のクラスタ構成に対応し、1TBのメモリを確保
- DGX StationのWindows版は12月出荷予定で製造業アプリをサポート
3層に分かれたローカルAIの布陣
NVIDIAがGTCベルリンで示したのは、ローカルAI向けハードウェアを用途別に3系統へ分けた構成である。Windows PC上で個人向けエージェントを動かす「RTX Spark」、Linux上で開発者がアプリを構築・拡張する「DGX Spark」、企業チームがフロンティア級のワークロードを動かす「DGX Station」が並ぶ。
RTX Sparkは10月16日に発売されたばかりで、最大128GBのユニファイドメモリと1ペタフロップスのAI演算性能を備える。DGX Sparkは10月23日(金)から64GB構成の出荷が始まり、DGX StationはASUS、Dell Technologies、GIGABYTE、HP、MSI、Supermicro、Exxactから出荷中だ。DGX StationのWindows版は12月に投入される予定である。
個々のマシン単体ではなく、エージェント用アプリ、対応モデル、管理ツールまでを含めた組み合わせとして提示された点が今回の特徴といえる。データをクラウドに送らずにAIを動かす選択肢を、個人・開発者・企業チームの各規模で揃えようとしている。
DGX Sparkは8台クラスタで拡張
DGX Sparkは、内蔵のNVIDIA ConnectX-7ネットワーキングとNVIDIA Sync Cluster Assistantを使い、複数台を接続できる。手動構成で最大8台までのクラスタに対応し、合計1TBのユニファイドメモリを確保できるため、GLM 5.3のようなフロンティア級モデルを動かせるとしている。
小規模チームが1つのクラスタを共有し、各開発者が同じモデルに対して同時にセッションを走らせる使い方が想定されている。10月中にはNVIDIA Syncの「Model Launcher」が提供され、数クリックで構成に合ったモデルとコンテナをダウンロードしてOpenCodeに接続できるようになる。
10月のソフトウェアアップデートでは、アプライアンスモードで稼働中にネットワークを切り替えられる「Wi-Fi Assistant」が追加される。DGX Spark SkillsもNVIDIA Sync経由で、トラブルシューティングや保守、公式ドキュメントへの案内を提供する。
DGX Stationは企業運用とWindows対応
DGX Stationは748GBのコヒーレントメモリと最大20ペタフロップスのAI性能を持ち、30人以上のユーザーにクラウドモデルに近い速度でモデルを提供できるとされる。NVIDIA SyncがDGX Stationにも対応し、Linuxベースの2台間の接続を簡単にする。
企業のITチーム向けには、Absolute Security、Splunk by Cisco、Fleet Device Management、Microsoft Intune、Perforce Puppet、Progress Software Chef、Taniumとの統合が追加された。既存の資産管理や構成管理の枠組みに載せ、承認手続きの迅速化や配備リスクの低減につなげる狙いとみられる。
12月予定のWindows版では、nTop、Dassault Systèmes、Keysight Technologies、MathWorks、Rockwell Automation、Siemens、Synopsys、Unity、Alteraといった製造業向けアプリのサポートが示されている。Hermes Agent、Perplexity、Aibleなどのエージェントをオンプレミスで動かせる。加えて、Linux版DGX StationではNVIDIA Cloud Functionsがアーリーアクセスで提供予定で、ローカルのモデルエンドポイントを共有カタログに登録し、OpenAI互換の単一エンドポイントから利用できる。
ローカル向け新モデルと推論高速化
Recursive Superintelligenceは、ローカルでのコーディング向けLLM「Recursive Flint」を公開した。40Bパラメータの混合エキスパート(MoE)モデルで、トークンあたりのアクティブパラメータは2.5B。64GBのRTX Sparkで毎秒220トークン以上を出すとしている。
学習には同社の「Eureka Machine」を使い、専用カーネルを自動生成することでモデルの重みを変えずに生成速度を55%高めたという。重みはHugging FaceでApache 2.0ライセンスの下に公開され、RTX SparkやDGX Spark、GeForce RTX、RTX PRO GPUで動かせる。
ほかにも、4GBのメモリで動くNemotron Bolt E4B 4GB、8GBのVRAMで動く画像モデルFLUX 3 Image Kleinなど、day-zero対応モデルが並ぶ。llama.cppでは投機的デコーディングによりエージェント処理が最大1.4倍、vLLMではQwen3.8 27Bを使う処理が最大1.3倍高速になるとしている。
公表されていない点
記事には各製品の価格や、日本を含む地域ごとの提供時期についての言及がない。販売チャネルや為替の状況によって実売価格は変わるため、導入判断には別途の情報収集が必要になる。
性能面の数値はいずれもベンダー側の発表であり、実際のワークロードでのスループットや消費電力、設置環境の条件は示されていない。クラウドAPIと比べて総額で見合うかどうかは、利用量と運用体制を置いた比較で確かめる必要がある。
| 項目 | RTX Spark | DGX Spark | DGX Station |
|---|---|---|---|
| 主な利用者 | 個人・クリエイター(Windows PC) | 開発者(Linux) | 企業チーム(Linux) |
| メモリ | 最大128GBのユニファイドメモリ | 64GB(最大8台接続で1TB) | 748GBのコヒーレントメモリ |
| AI性能 | 1ペタフロップス | 記事に記載なし | 最大20ペタフロップス |
| OS | Windows | Linux | Linux(12月にWindows版) |
DGX Station offers 748GB of coherent memory and up to 20 petaflops of AI performance, enabling developers to run advanced models like GLM 5.3 and serve 30+ users.
DGX Stationは748GBのコヒーレントメモリと最大20ペタフロップスのAI性能を備え、開発者はGLM 5.3のような先進的なモデルを動かし、30人以上のユーザーに提供できる。
今後の見通し
次の焦点は12月に予定されるDGX Station for Windowsの出荷である。製造業向けアプリとエージェント実行基盤が同じマシンに載ることで、設計・シミュレーションの現場での需要がどの程度動くかが注目される。加えて、NVIDIA Cloud Functionsの一般提供時期、各製品の価格、日本を含む地域ごとの展開時期が明らかになれば、導入可否を判断しやすくなる。推論エンジン側の高速化が実際のワークロードでどこまで効くかも、ベンチマークの公開を待って確認したい。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっては、フロンティア級モデルを社内のマシンで動かす選択肢が、個人・チーム・部門の3段階で揃ってきたことが意味を持つ。機密性の高いデータを扱う開発現場では、DGX Sparkの8台クラスタやDGX Station上でモデルを動かし、NVIDIA Cloud Functionsでチーム内の推論サービスとして共有する構成が現実味を帯びる。製造業のクライアントを持つ企業では、12月予定のDGX Station for WindowsがCADやCAEなど既存のWindowsアプリと同じマシンでエージェントを動かせる点が提案材料になりうる。一方で価格と国内提供時期は未公表のため、クラウド利用との費用比較は現時点ではできず、PoCでの検証が先になる。
気になる点
- 日本でも購入できるのか
- 記事には販売地域についての記載がなく、日本での提供時期は公表されていない。ASUS、Dell Technologies、HP、Lenovo、MSI、GIGABYTE、Acer、Supermicro、Exxactといったパートナー各社からの出荷が示されているため、各社の国内展開を待つ形になる。
- 価格はいくらか
- RTX Spark、DGX Spark、DGX Stationのいずれについても、記事に価格の記載はない。構成や搭載メモリによって価格帯が変わる可能性があり、現時点では公表されていないと答えるほかない。
- DGX Sparkのクラスタはどうつなぐのか
- 内蔵のNVIDIA ConnectX-7ネットワーキングとNVIDIA Sync Cluster Assistantを使い、手動構成で最大8台まで接続できる。合計1TBのユニファイドメモリを確保でき、小規模チームが1つのクラスタを共有する使い方が想定されている。
用語解説
- ユニファイドメモリ
- CPUとGPUが同じメモリ空間を共有する方式。大きなモデルをGPU専用メモリに分割せず載せやすい。
- MoE(混合エキスパート)
- 複数の専門家ネットワークのうち一部だけをトークンごとに使うモデル構造。総パラメータを増やしつつ計算量を抑えられる。
- 投機的デコーディング
- 小さなモデルで候補を先に生成し、大きなモデルでまとめて検証する推論高速化手法。出力の品質を保ちながら速度を上げる。
- 量子化
- モデルの重みをより少ないビット数で表現し、メモリ使用量と計算量を減らす手法。精度低下とのトレードオフがある。
- KVキャッシュ
- 推論時に過去のトークンの内部状態を保持する領域。長い文脈を扱うほど多くのメモリを消費する。
- ペタフロップス
- 1秒あたり1000兆回の浮動小数点演算を表す性能指標。AI演算の処理能力を示す際によく使われる。
出典
Bringing the Spark to Europe: Local Intelligence Powers Next Wave of Agents
https://blogs.nvidia.com/blog/local-ai-gtc-rtx-dgx-spark-station-sync
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する