- Google CloudのA5Xインスタンスが来月から一般提供、欧州への拡大も計画
- Vera Rubin NVL72、ConnectX-9 SuperNICs、Virgo Network、第4世代液冷を統合
- 複数サイトで最大96万基のRubin GPUまで拡張する計画を表明
何が発表されたのか
NVIDIAとGoogle Cloudは、NVIDIA Vera Rubin基盤を搭載したGoogle CloudのA5Xインスタンスを来月から一般提供すると発表しました。あわせて、提供地域を欧州へ拡大する計画も示しています。A5Xは、訓練・推論・大規模な強化学習をひとつの統合プラットフォームとしてクラウド利用者に届けることを狙うものです。
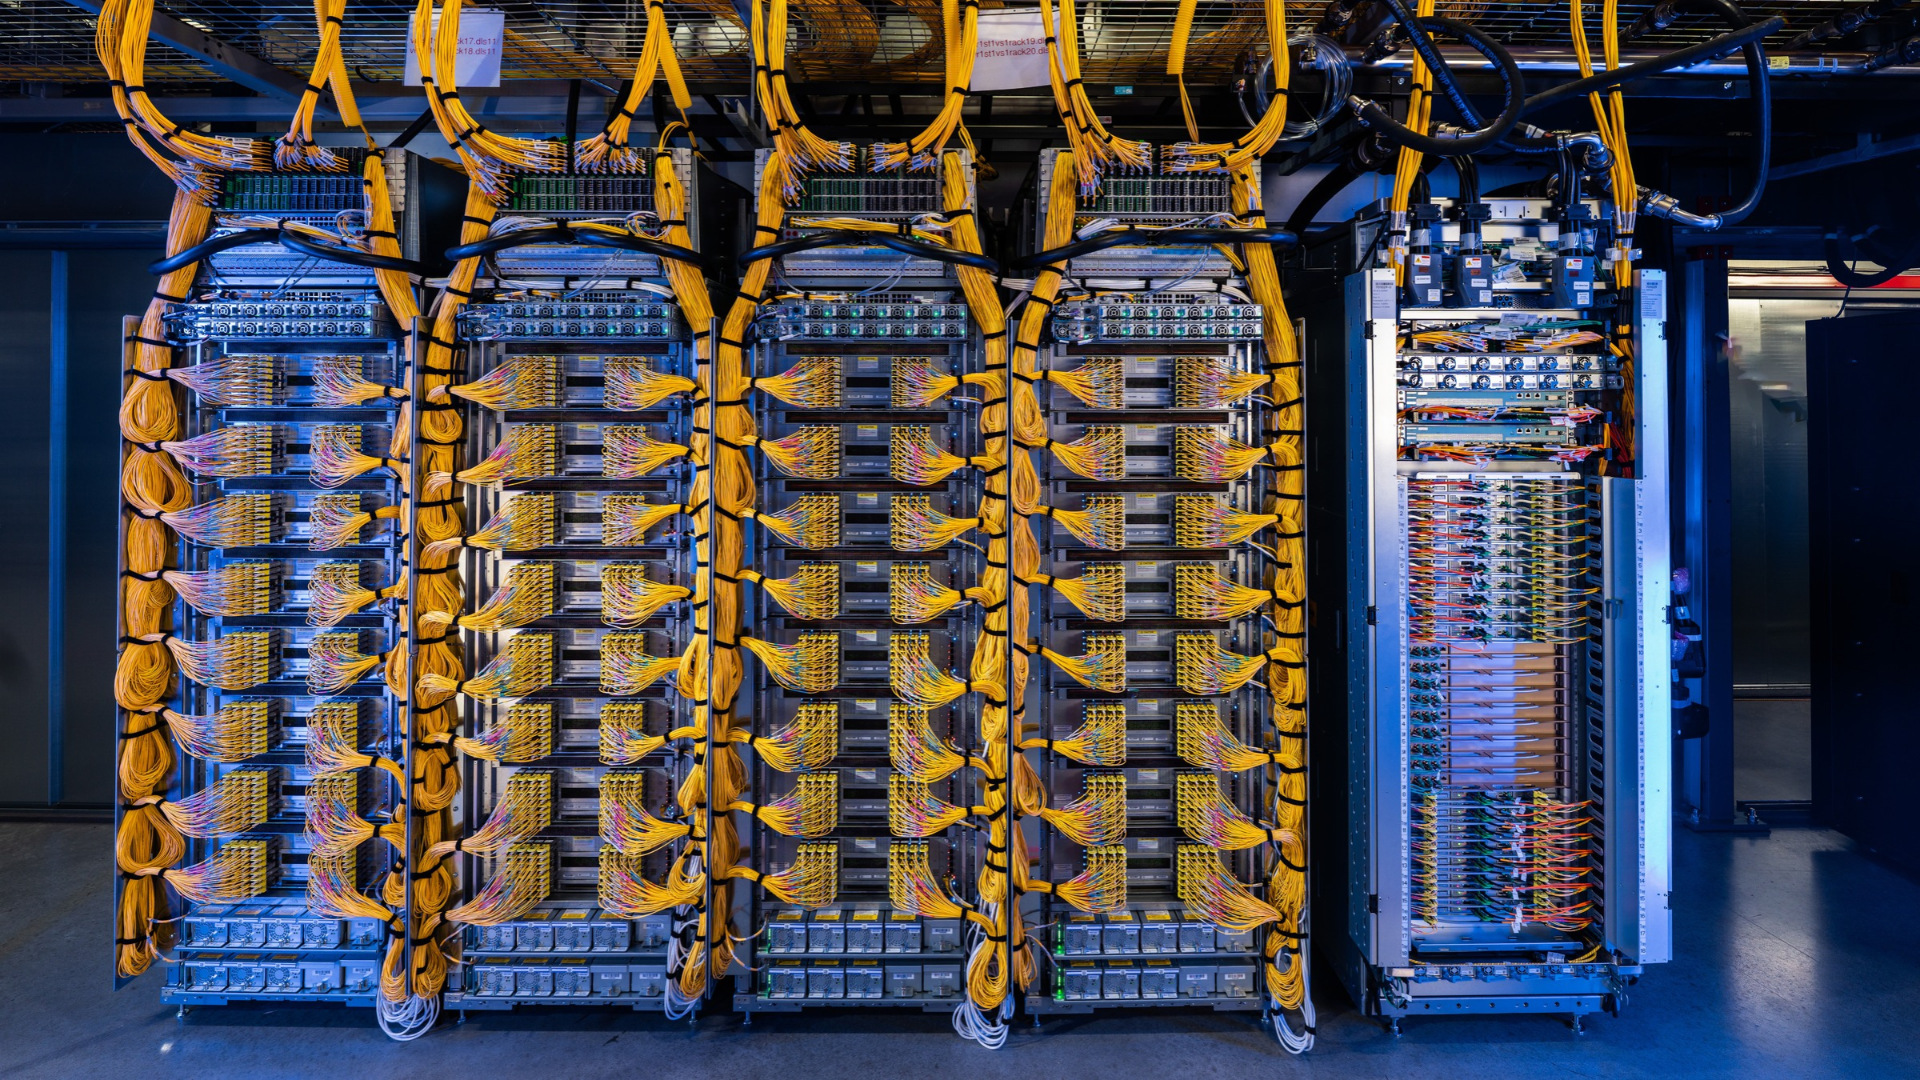
A5Xは、NVIDIA Vera Rubin NVL72、NVIDIA ConnectX-9 SuperNICs、Google Cloud Virgo Network、Google Cloudの第4世代先進液冷技術を組み合わせて構成されます。想定されている用途は、規模の大きいエージェント推論と強化学習のワークロードです。Vera RubinはGoogle CloudのAI Hypercomputerに統合システムとして組み込まれ、計算・ネットワーク・ストレージをまとめて提供する形になります。
規模と強化学習向けの設計
Google Cloudは、Vera Rubinベースのインフラを複数のサイトにまたがって最大96万基のRubin GPUまで拡張する計画を示しています。最初にA5Xへアクセスしたのは、AlphaGoの開発者であるDavid Silver氏が設立したロンドンのIneffable Intelligenceです。同社はこの基盤を使い、大規模な強化学習と、経験から継続的に学ぶ「superlearner」と呼ぶシステムの研究を進めています。
強化学習では、経験を生成し、結果を評価し、モデルを更新するというサイクルを回し続ける必要があります。そのため、この一連の処理を大規模に支えられるインフラが求められます。A5Xは、計算・ネットワーク・ストレージを統合したシステムとして、こうした経験駆動型の学習を支える位置づけだと説明されています。
エージェント用途の実演
ロンドンのマーケティング・コミュニケーション企業であるWPPは、NVIDIA NemotronモデルとNVIDIA OpenShellを使い、Vera RubinベースのA5Xインスタンス上でクリエイティブエージェントの参照アーキテクチャを実演しました。エージェントは会話形式の依頼を、動画生成やアップスケーリング、リストーリングといった多段の制作ワークフローに変換します。実行の前には人による承認が入る仕組みです。
OpenShellはエージェント実行用の統制されたサンドボックスを提供し、機密性の高いブランド資産や制作ツールへのアクセスを制御する役割を担います。WPPの初期テストでは、通常は複数ノードのクラスタが必要だったワークロードが、単一のA5Xインスタンスで動作したとされています。
機密計算と電力効率
Google Cloudは、NVIDIA Confidential Computingをラックスケールでベアメタルインスタンスに提供する最初のクラウドプロバイダーの一つになるとしています。対象として挙げられているのは、NVIDIA GB300 NVL72を搭載したA4X Maxインスタンスです。さらに、NVIDIA RTX PRO 6000 Blackwell Server Edition GPUを搭載したG4 VMでもConfidential Computingを一般提供し、機密性の高い推論やファインチューニングに使える柔軟な基盤を用意します。
Vertebrae、Polaris Cloud、Confidential Core AIといった顧客は、会話のプライバシー保護、検証可能なエージェント実行、ポリシーに沿った企業インテリジェンスのためにConfidential G4を利用しているとされます。電力効率の面では、Vera Rubin基盤にNVIDIA DSX MaxLPSを適用し、ワットあたり性能の最適化とデータセンターの電力枠内での容量拡大を検討している段階です。
We're building superlearners that continually improve through their own experience. That demands substantial compute and a tight connection between generating experience and training on it.
私たちは、自らの経験を通じて継続的に改善するスーパーラーナーを構築しています。そのためには相当な計算資源と、経験を生成することとそれを学習することの間の密接な結びつきが必要です。
今後の見通し
A5Xの一般提供は来月に始まり、その後欧州へ展開が広がる見込みです。ただし、提供リージョンの詳細、料金、実測性能といった具体的な情報は今回の発表では示されていません。次に判断材料になるのは、一般提供開始時に公表されるリージョン一覧と料金体系、そしてIneffable IntelligenceやWPPのような利用企業から出てくる実測の性能・効率のデータとみられます。日本を含むアジア地域でいつ利用できるようになるかも、現時点では明らかになっていません。
日本の開発者・IT企業にとっての意味
大規模な強化学習とエージェント推論をクラウドで回すための基盤の選択肢が、Vera Rubin世代で具体的に動き出した点が重要です。NVL72やConnectX-9 SuperNICs、専用ネットワーク、液冷をまとめて提供する形は、自社でラックスケールのクラスタを組む場合の設計・調達の前提にも影響します。特に強化学習は経験生成と学習を近接させて回す必要があり、計算とネットワークを一体で捉える発想が実務のボトルネック設計を変える可能性があります。また、Confidential ComputingがラックスケールのベアメタルやG4 VMで広がることは、規制産業や機密データを扱う日本企業がエージェント導入を検討する際の判断材料になります。ただし国内リージョンでの提供時期と価格は未公表で、すぐに移行を検討できる段階ではない点には注意が必要です。
気になる点
- 日本国内のリージョンでも利用できますか
- 今回の発表で示されているのは、来月の一般提供開始と欧州への提供拡大計画です。日本を含むアジア地域の提供時期については公表されていません。国内で使えるかどうかは、今後のリージョン展開の発表を待つ必要があります。
- A5Xの料金はどのくらいですか
- A5Xインスタンスの価格は今回の発表では示されていません。Vera Rubin NVL72や液冷設備を含む構成のため、一般的なGPUインスタンスとは異なる課金体系になるとみられますが、現時点で確認できる価格情報はありません。
- A4X MaxやG4とはどう使い分けますか
- 原文では、A4X MaxはGB300 NVL72搭載のベアメタルインスタンスとして機密計算のラックスケール提供の例に挙げられ、G4はRTX PRO 6000 Blackwell搭載のVMとして機密推論やファインチューニング向けと説明されています。A5XはVera Rubin世代の大規模学習・推論向けという位置づけで、詳細な使い分けは原文に記述がありません。
用語解説
- 強化学習
- 試行錯誤で得た経験と報酬をもとに、モデルの振る舞いを改善していく機械学習の手法。
- SuperNIC
- NVIDIAのネットワークインターフェースカードの名称。原文ではConnectX-9 SuperNICsとして言及。
- Confidential Computing
- 処理中のデータを保護された領域で扱い、クラウド事業者側からも中身を守る技術。
- ベアメタル
- 仮想化層を挟まず、ハードウェアをそのまま利用する形で提供されるクラウドインスタンス。
- AI Hypercomputer
- Google Cloudが計算・ネットワーク・ストレージを統合システムとして提供するAI向け基盤の呼称。
出典
Google Cloud and NVIDIA Announce General Availability of NVIDIA Vera Rubin Infrastructure
https://blogs.nvidia.com/blog/google-cloud-vera-rubin-infrastructure
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する