- SageMaker AIが学習ループを自前で書けるtraining session APIを発表
- アルゴリズムではなくGPUなどの計算資源を抽象化し、運用負荷をサービス側へ
- 課金は処理トークン単位で、報酬計算やデータ読み込み中はGPU課金なし
何が発表されたのか
AWSは2026年10月22日、Amazon SageMaker AIのサーバーレスなモデルカスタマイズ機能を広げる「training session API」を発表しました。従来のフルマネージドな微調整では、ベースモデルとデータ、ハイパーパラメータを渡せば学習手順はサービス側が持ちます。一方、管理の度合いが低いサービスでは自由度と引き換えに、インフラと学習フレームワークの面倒を利用者が見ることになります。今回のAPIは、この二択を解消するものだと説明されています。
特徴は、抽象化する対象をアルゴリズムから計算資源へ移した点です。forward_backward()、optim_step()、sample()といった操作がSageMakerのAPI呼び出しになり、利用者はそれらを組み合わせて、SFT(教師あり微調整)や選好最適化、強化学習などの手順を自分で書けます。呼び出し先は、選んだベースモデルとLoRAアダプタがGPUに読み込まれたままのステートフルなセッションです。実行環境の準備、分散実行、勾配同期、障害復旧、テナント分離はサービス側が担います。
3つのクライアントと非同期呼び出し
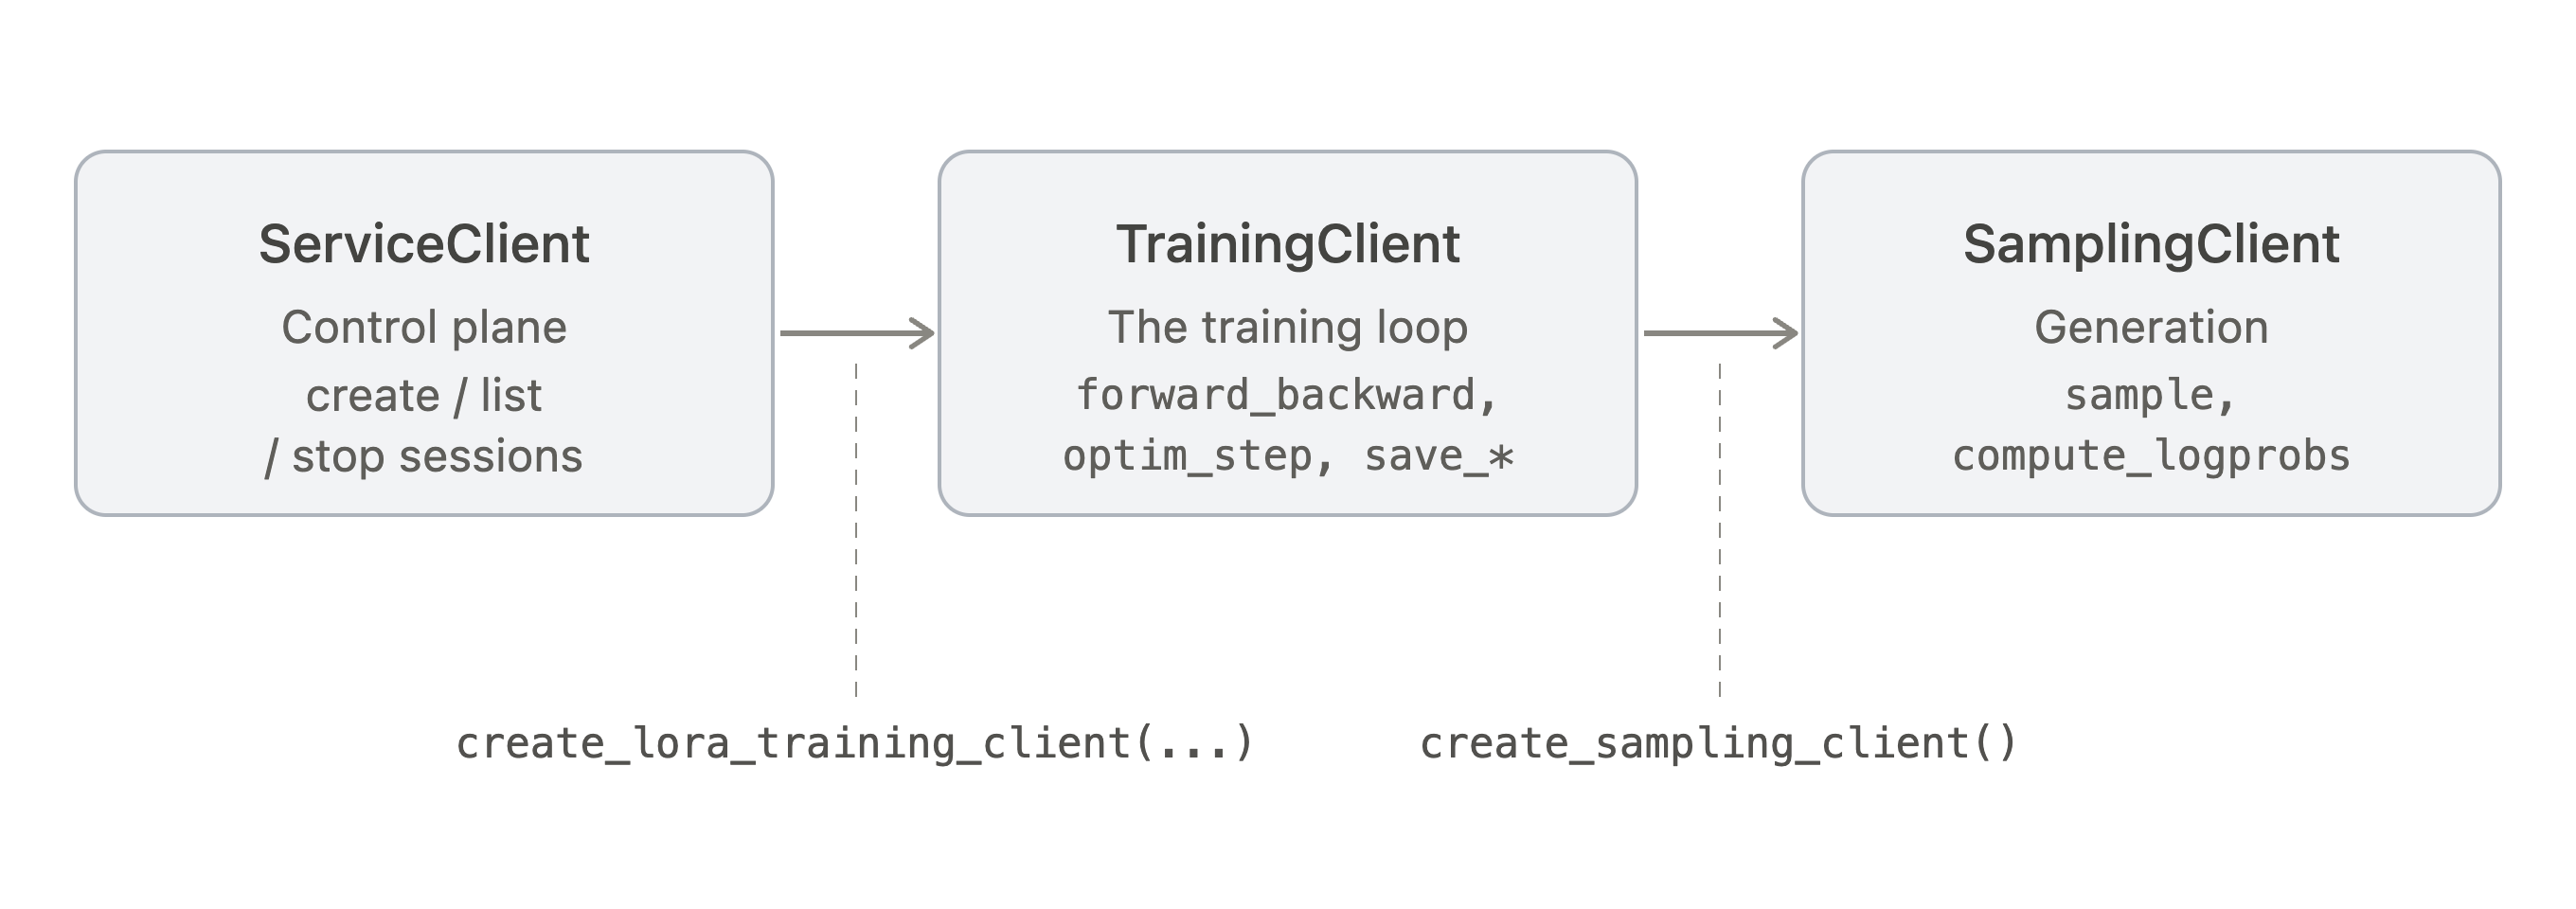
APIはSageMaker Python SDKの3つのクライアントで構成され、順番に生成します。ServiceClientは実行ロール、モデルパッケージグループ、Amazon S3の出力先といったプラットフォーム設定を保持し、任意でAWS KMSキーやVPC設定も指定できます。ServiceClientからTrainingClientが作られ、forward、forward_backward、optim_step、save_weights_for_samplerといった学習とチェックポイントの操作を提供します。さらにTrainingClientからSamplingClientが作られ、sampleとcompute_logprobsで生成とスコアリングを担当します。
GPUを使う呼び出しはAPIFutureを即座に返し、バックグラウンドで送信された後に.result()で結果を待つ仕組みです。有効なセッションはOpenAI互換のchat completionsエンドポイントも提供するため、既存のOpenAI向けクライアントコードからサンプリングできます。
GSM8Kで見る強化学習ループ
原文では、約8,500問の小学校算数の文章題ベンチマークであるGSM8Kを使った最小構成の強化学習ループが解説されています。対象はOpenAIのGPT-OSS 20Bで、LoRAアダプタをrank=32、alpha=64で学習し、GRPO(Group Relative Policy Optimization)を適用します。各質問に対してモデルが複数の回答を生成し、正誤でスコアを与え、グループ平均を上回った回答を強化する流れです。
1ステップは4段階で進みます。まずGPU側で現行モデルから回答をサンプリングし、次にローカルのPythonコードが報酬関数や検証ツールでスコアを付けます。続いてforward_backwardとoptim_stepがスコアを勾配更新に変換し、最後にsave_weights_and_get_sampling_client()でサンプラーを更新します。SFTの場合はサンプリングと報酬の段階を省き、ラベル付きデータに対するcross_entropy損失でforward_backwardを呼ぶ形になります。
あわせて、SFTとRLのすぐに実行できるレシピを集めた「SageMaker training sessions cookbook」も公開されました。原文では、競技プログラミングの問題に対して生成コードをユニットテストで採点する実践的なワークロードも紹介されています。
課金と既存選択肢との位置づけ
課金は処理したトークン単位で、ループが消費した計算分だけが請求されます。報酬関数の計算にローカルで10秒かかっても、その間のGPU時間は課金されません。時間単位のGPU課金と比べると、アイドル状態のGPUコストが発生せず、コストが実時間やクラスタサイズではなくデータセットと生成量に比例するため、支出を予測しやすく実験の比較もしやすいと説明されています。
SageMaker AIのモデルカスタマイズ手段の中では、フルマネージドのServerless Model Customizationよりアルゴリズムを細かく制御でき、SageMaker Training JobsやAmazon SageMaker HyperPodで学習するより運用上の負担が小さい位置づけです。想定読者として、GRPOやPPOなどのRL手法を実装する研究者、非標準の損失やデータカリキュラムを必要とするSFT・選好最適化のチーム、独自のロールアウトが必要なエージェント型RLの構築者、設定ファイル駆動の微調整では足りなくなったMLエンジニアが挙げられています。
現時点で分かっていないこと
対応するベースモデルと、それぞれを利用できるAWSリージョンはドキュメントに記載されているとされるものの、原文には一覧が示されていません。料金の単価や最低利用額についても記述がなく、コストの具体的な水準は現時点では判断できません。
また原文は、ループを成立させている3つの詳細を説明する部分で途切れています。非同期呼び出しの挙動やバッチ送信の仕組みについては、原文だけでは全体像を確認できません。導入を検討する場合は、ドキュメントとcookbookのコードを直接確認する必要があります。
| 項目 | training session API | 時間単位のGPU課金 |
|---|---|---|
| 課金の単位 | 処理したトークン数 | GPUを確保した時間 |
| 待ち時間の扱い | ローカル処理中は課金されない | ループの待ち時間も課金対象になる |
| コストが比例する対象 | データセットと生成量 | 実時間とクラスタサイズ |
Instead of abstracting away the algorithm, they abstract away the compute.
アルゴリズムを抽象化する代わりに、計算資源を抽象化する。
今後の見通し
次に注目されるのは、対応ベースモデルとリージョンの一覧、そしてトークン単価が明らかになることです。これらが分かれば、既存のSageMaker Training JobsやHyperPodで学習しているワークロードを、コスト面で置き換えられるか判断しやすくなります。またcookbookのレシピがどの程度そのまま実務に使えるか、GSM8K以外の実データでの挙動が共有されるかも判断材料になるとみられます。原文が途中で切れているため、まずはドキュメント側の更新を確認するのが確実です。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっての意味は、独自の学習手順を持つチームがGPUクラスタの運用を持たずに実験を回せる可能性が生まれたことです。独自損失やRL報酬関数、選好最適化は、既製のレシピでは表現しづらく、これまでは自前のクラスタ管理とセットになりがちでした。トークン単位の課金は、報酬計算やデータ前処理が重いワークロードほどコストを読みやすくします。一方で対応モデル・リージョン・単価が未確認のため、既存のTraining Jobs中心の構成をただちに置き換えるというより、アルゴリズム探索フェーズの選択肢が増えるとみられます。まずcookbookのレシピで検証する進め方が現実的です。
気になる点
- 日本のリージョンでも利用できますか
- 原文は対応リージョンをドキュメントで案内するとしているだけで、一覧は示していません。ap-northeast-1(東京)で提供されるかどうかは現時点では公表されていません。導入検討時は公式ドキュメントのリージョン一覧を確認する必要があります。
- 料金はいくらですか
- 処理したトークン数に応じた従量課金であると説明されていますが、単価や最低利用額は原文に記載がありません。ローカルでの報酬計算中はGPU課金が発生しない点はコスト設計上の利点ですが、具体的な金額はドキュメントで確認する必要があります。
- 既存の学習コードを流用できますか
- 操作ベースのプログラミングモデルは、低レベルのforward_backward、optim_step、sampleを呼ぶ既存の学習ループに直接対応するとされています。ただし利用できるベースモデルはドキュメントに記載された範囲で、LoRAアダプタを前提とする点は事前に確認が必要です。
用語解説
- LoRA
- モデル全体を再学習せず、小さな低ランク行列だけを学習する微調整手法。GPUメモリと計算量を抑えられる。
- GRPO
- Group Relative Policy Optimization。同じ質問への複数回答をグループとして比較し、平均を上回った回答を強化する強化学習手法。
- SFT
- Supervised Fine-Tuning。ラベル付きの入出力例を用いた教師あり微調整。cross_entropy損失で学習する。
- ステートフルセッション
- モデルをGPUに読み込んだまま状態を保持し、複数のAPI呼び出しをまたいで同じセッション上で操作を続けられる実行単位。
- APIFuture
- 非同期処理の結果を後から受け取るための仕組み。呼び出しは即座に戻り、.result()で完了を待つ。
出典
Write your own training loop — without managing GPUs — with Amazon SageMaker training session APIs
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する