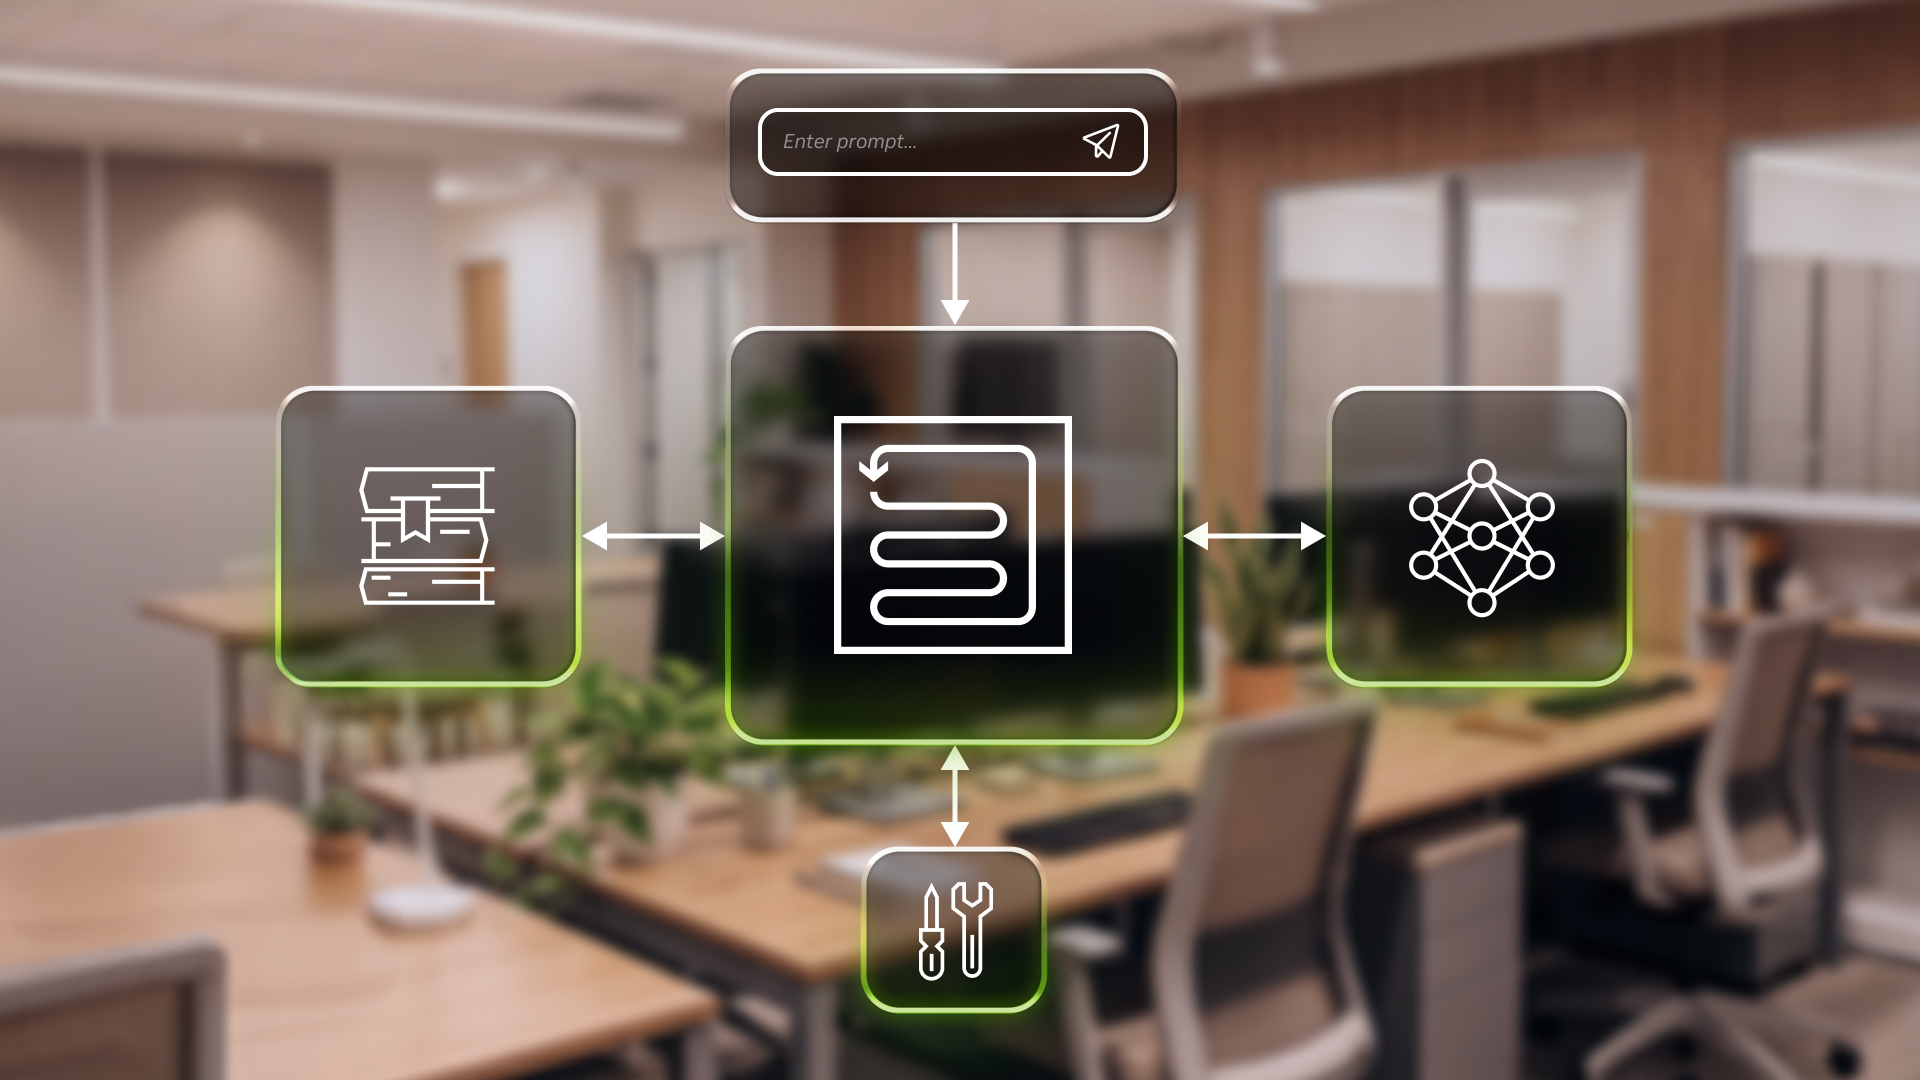
- Agent Toolkitは知識基盤、オープンモデル、実行環境、設計図、ツール群で構成される
- Agent Knowledge Foundationはデータを移動せずに社内データを知識化できるとする
- PalantirやDatabricks、Snowflakeが採用、Nemotron Retrieverは検索高速化に寄与
Agent Toolkitの構成
NVIDIAは、オープンソースの「NVIDIA Agent Toolkit」を新しいツール群で拡充したと発表した。構成要素は、新設の「NVIDIA Agent Knowledge Foundation」とNVIDIA CUDA-Xライブラリ、Nemotron Retrieverと新しいKumoファミリーを含むNVIDIAのオープンモデル、セキュアなエージェント実行環境「NVIDIA OpenShell」、セキュアなエージェントの設計テンプレート「NVIDIA NemoClaw」、そしてNeMo RelayやNeMo Compassといったツール・スキル群である。
NVIDIAは、エージェントの有用性は「何を知っているか」で決まり、信頼性は「どの境界の内側で動くか」で決まると説明している。そのうえで、実際の業務をこなし、開発から配備まで信頼できるエージェントを作るには、モデル・ハーネス・ランタイム・データ・ツールをまとめたオープンなエージェントスタックが必要だとしている。
社内データを知識に変える
Agent Knowledge Foundationは、企業が持つデータを、エージェントが使える「会社の知能」に変えるための基盤と位置づけられている。エージェントは関連情報を見つけ、それが業務にとって何を意味するかを理解し、予測や意思決定の支援に使えるという。NVIDIAは、データを移動させず、既存のワークフローを作り直さず、ガバナンス制御も変更せずに利用できるとしている。
基盤にはcuDF、cuGraph、cuML、cuOpt、cuVSを含むCUDA-Xライブラリと、新しいAuto-Ontologyライブラリが含まれる。Auto-Ontologyは、生の社内データを顧客・製品・注文といった馴染みのある業務概念に変換し、それらの関係を対応づける。さらに、Nemotron RetrieverとKumo Structuredのオープンモデル(Kumo Tabular、Kumo Relational、Kumo Time Series、Kumo Forecast)が、質問への回答や予測に必要な社内情報の検索を担う。
検索モデルの導入効果
Nemotron Retrieverは、検索をより速く、より正確にするモデルとして紹介されている。埋め込みモデルを使ったAmazon OpenSearch Serviceは、検索ステップを減らしながら関連性を高め、遅延はほとんど増えなかったという。SAPがファインチューニングしたリランカーは約3倍速く動作し、ServiceNowはリランキング品質を高めつつ遅延を4分の1近く削減したとされる。Zoomは文書理解、検索関連性、コンテキスト取得のためにNemotron Retrieverを活用している。
Kumoファミリーについても適用例が示されている。DatabricksはKumo AnomalyとDatabricks Genie Ontologyを組み合わせ、文脈を踏まえたエージェントを動かす。Snowflakeは顧客がSnowflake Notebook環境でKumo EngineとKumo Relationalのオープンモデルを使えるようにし、予測機能を広げるとしている。
実行時の統制と導入企業
OpenShellはエージェントの実行におけるセキュアな境界を提供し、エージェントが何にアクセスし、何を実行できるかを企業が制御できるようにする。NemoClawのブループリントは、セキュアで特定用途向けのエージェントを構築するための参照設計である。最新のブループリントはエージェント最適化向けで、エージェントの知能を継続的に高めるための手順の出発点を提供するという。
企業導入も進んでいる。NVIDIAのサプライチェーン組織はPalantirを通じ、Palantir Foundry、Ontology、AIPを用いてAgent Knowledge Foundationを活用し、専用エージェントの配備や独自データからの実用的な洞察の生成、結果予測、意思決定の最適化を行う。ほかにAWS、ClickHouse、Cloudera、Cohesity、Dassault Systèmes、Dell、Elastic、Exa、IBM、NetApp、Oracle、Perplexity、Starburst、VAST Dataも同基盤上で構築しているとされる。
現時点で分かっていないこと
提供時期や価格、ライセンス条件は原文に記載がない。Nemotron RetrieverやKumoファミリーは「オープンモデル」と表現されているが、個別モデルのライセンス条項や配布形態、商用利用の条件は示されていない。日本国内での提供状況についても言及はない。
記事に挙げられた効果の数値は各社の発表に基づくもので、比較条件となるデータセットや実行環境は明らかにされていない。NemoClawの最適化ブループリントが具体的にどの手法を用いるのかも、原文からは読み取れない。
| 導入企業・製品 | 用途 | 確認された効果 |
|---|---|---|
| Amazon OpenSearch Service | 検索 | 検索ステップを削減し関連性を向上、遅延はほぼ増加せず |
| SAP | ファインチューニングしたリランカー | 約3倍高速化 |
| ServiceNow | リランキング | 品質向上と遅延を4分の1近く削減 |
| Zoom | 文書理解・検索関連性・コンテキスト取得 | 効果の数値は非公表 |
Companies can use Agent Knowledge Foundation without moving data, rebuilding existing workflows or changing governance controls.
企業は、データを移動させたり、既存のワークフローを作り直したり、ガバナンス制御を変更したりすることなく、Agent Knowledge Foundationを利用できる。
今後の見通し
企業データとエージェントをつなぐ「知識の層」は、モデル単体の性能とは別の競争軸になりつつある。今回の発表は構成要素と導入企業の名前が中心で、次に判断材料となるのは、Agent Knowledge Foundationの一般提供時期と価格、Auto-Ontologyがどの程度まで自動で業務概念を抽出できるか、既存のデータ基盤からどのように接続するかの3点とみられる。原文ではGTC Berlinのセッションで、専用エージェントの構築・配備・最適化が扱われると案内されており、そこで実装の詳細が明らかになる可能性がある。
日本の開発者・IT企業にとっての意味
企業がAIエージェントを業務に入れる際の最大の壁は、モデルの性能よりも「社内データをどう渡し、どこまで動かしてよいかをどう統制するか」にある。今回の発表は、データを移動させずに知識化する基盤と、実行時のアクセス境界を提供するランタイムを同じスタックにまとめた点に意味がある。日本のIT企業にとっては、PalantirやSnowflake、Databricksといった既存のデータ基盤の上にエージェントを載せる設計が現実的になってきたことを示す。一方で、価格や提供時期、ライセンスが不明なため、すぐに検証を始めるかは別途情報収集が必要になる。既存のDWHや社内検索との接続方式が明らかになれば、PoCの設計判断がしやすくなる。
気になる点
- 導入すると、社内データをNVIDIA側に移す必要があるのか
- 原文では、Agent Knowledge Foundationはデータを移動させず、既存のワークフローを作り直さず、ガバナンス制御も変更せずに使えるとされている。ただし、実際の接続方式やどこで処理が実行されるかの技術的な詳細は示されていない。
- Nemotron RetrieverやKumoは自社環境で利用できるのか
- 両者はNVIDIAの「オープンモデル」として位置づけられている。Kumo StructuredとしてはKumo Tabular、Kumo Relational、Kumo Time Series、Kumo Forecastの4つが挙げられているが、ライセンス条項や配布形態、商用利用の条件は原文に記載がない。
- 日本企業でも使えるのか、費用はどのくらいか
- 原文に挙がっているのはPalantir、Databricks、Snowflakeなど主に米国の企業・製品の事例で、日本国内での提供時期や価格、日本語データへの対応状況は公表されていない。現時点では判断材料がない。
用語解説
- エージェント
- 目標に向けて自律的に判断し、ツールやデータを使って作業を進めるAIプログラム。
- 埋め込みモデル(embedding)
- 文章を数値ベクトルに変換し、意味的な類似検索を可能にするモデル。
- リランカー
- 検索結果をクエリとの関連度で並べ替えるモデル。検索精度の向上に使う。
- オントロジー
- 顧客や製品などの概念と、その関係性を定義した知識の枠組み。
- CUDA-X
- NVIDIAのGPUライブラリ群。データ処理や機械学習、最適化などを高速化する。
出典
NVIDIA Agent Toolkit Expands, Grounding Enterprise Agents in Company Data
https://blogs.nvidia.com/blog/enterprise-platforms-agent-toolkit
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する