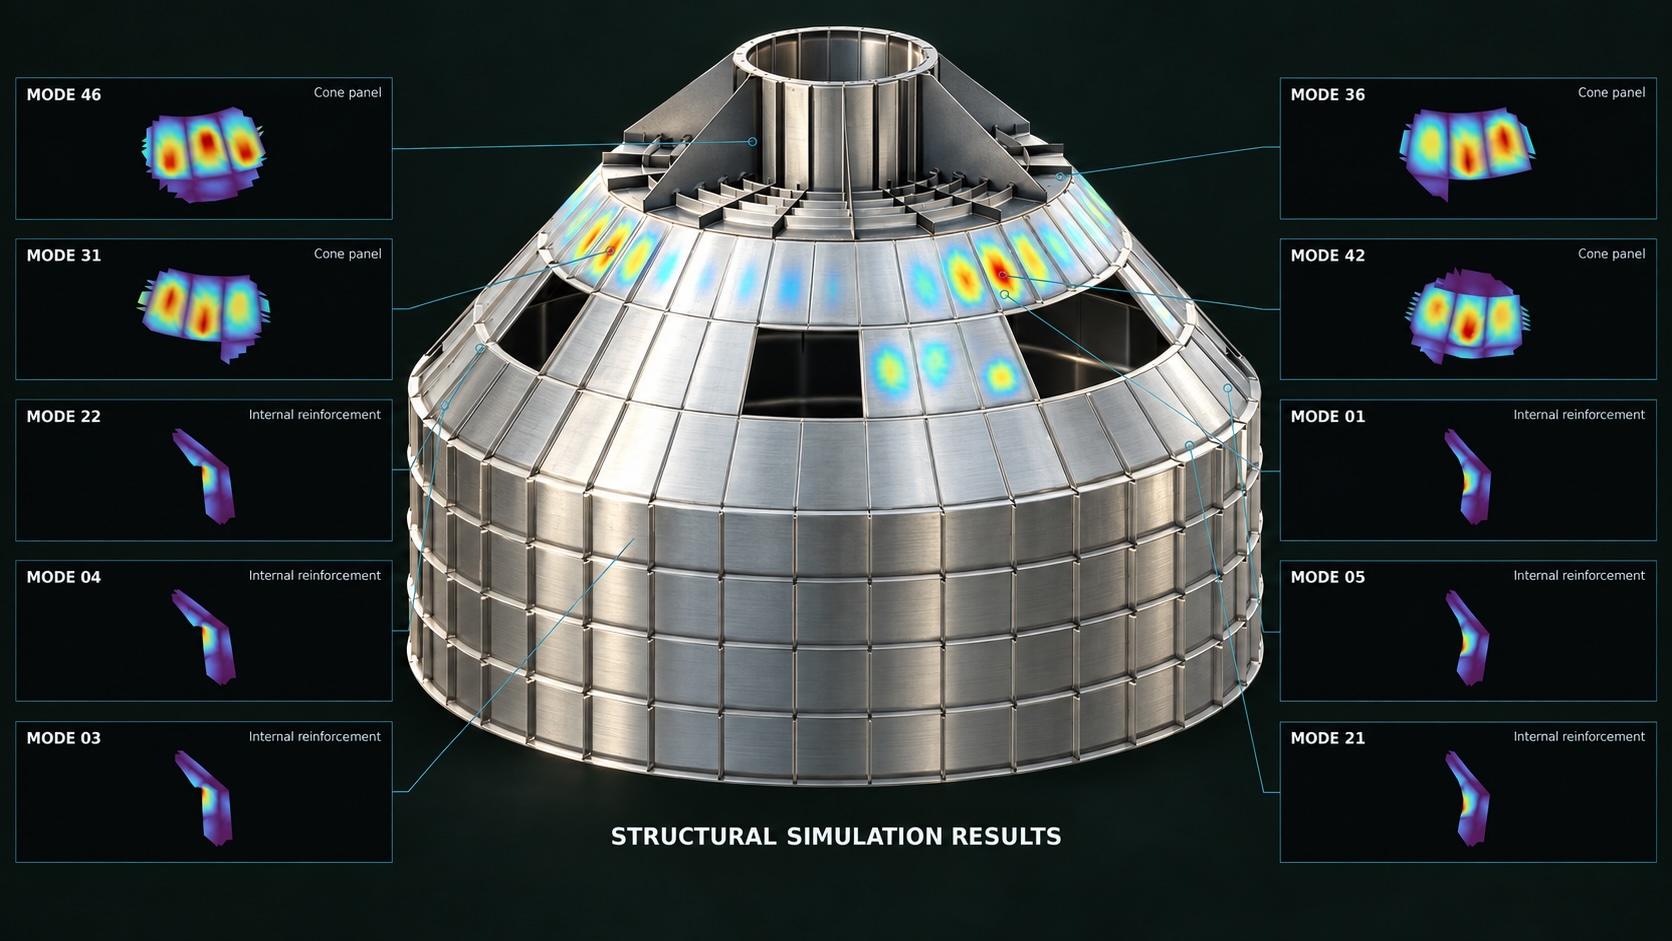
- NVIDIAがCUDA-Xライブラリの一つ、疎行列ソルバーcuDSSの一般提供を開始
- シミュレーションで反復される大規模疎行列の求解をGPUに移し、計算時間を短縮
- 半導体・CAE・EDAの主要ベンダーが自社製品に組み込み、最大10倍の高速化を報告
cuDSSが一般提供に
NVIDIAは、CUDA-Xライブラリの一つである「NVIDIA cuDSS」の一般提供(GA)を開始したと発表しました。cuDSSは、エンジニアリングおよび科学技術シミュレーションの中でも計算負荷の高い工程をGPUに移すためのライブラリです。CUDA-Xは、NVIDIAのGPU計算基盤であるCUDAを土台にしたライブラリ群を指します。
チップや航空機、産業システムといった複雑な設計では、製造前に性能を予測するためにシミュレーションが使われます。設計が複雑になるほど計算時間は長くなり、計算資源の制約から、チームが試せる設計案の数は限られてしまいます。cuDSSは、この制約を緩める位置づけの製品と説明されています。
疎行列求解をGPUで加速
シミュレーションでは、要素の多くがゼロである「疎行列」を用いた大規模な連立方程式の求解が繰り返し発生します。この処理は計算量が多く、シミュレーション全体の時間を律速する要因になりがちです。cuDSSはこの求解部分をGPUで処理することで、結果が出るまでの時間短縮とシミュレーションのスループット向上を狙います。
NVIDIAによれば、これによりエンドユーザーは、より大規模で現実に近いモデル、より精度の高い表現、より広い設計空間を、低いコストで探索できるようになるといいます。
cuDSSは、単体のワークステーションから大規模な計算クラスタまで、追加設定なしでスケールするとされています。開発者はC、C++、Python、Fortranの各インターフェースを通じて、既存のエンジニアリング・科学技術・最適化ソフトウェアに組み込むことができます。
主要ベンダーの採用状況
Applied Materialsは、物理ベースの欠陥解析シミュレーションプラットフォーム「Ginestra」にcuDSSを組み込み、CPUのみの手法と比べて疎行列求解を最大10倍高速化したとしています。半導体材料やデバイス信頼性の探索を加速する狙いです。
COMSOLの「COMSOL Multiphysics」をNVIDIAの高速計算環境上でcuDSSと組み合わせ、ZEISS SMTはEUVリソグラフィのプラズマシミュレーションのベンチマークで4倍の高速化を測定値として確認し、シミュレーション全体を6日14時間で完了させたと報告しています。Dassault Systèmesは「Abaqus」の構造ソルバーと「CST」の電磁界ソルバーで8〜10倍の高速化を報告しています。
このほか、Cadenceは「Celsius」で熱・構造応力・反り解析にcuDSSを使い、Nokiaを含む顧客の複雑な設計分析を支援しています。Siemensは「Simcenter STAR-CCM+」の流体構造連成ワークフローに、Synopsysは「Sentaurus Device」にそれぞれcuDSSを組み込み、Infineonなどの複雑なデバイスのモデル化を加速しているとしています。
現時点で公表されていない点
原文では、cuDSSの価格やライセンス条件、対応するGPUの種類、必要なCUDAのバージョンといった導入に必要な情報は示されていません。既存のCPUベースのソルバーから置き換える際の移行手順についても言及はありません。
また、各社が示した高速化の数値は、それぞれのツールとベンチマーク条件下での発表値です。ワークロードによって効果は変わるとみられ、一般的な性能として受け取るには注意が必要です。
cuDSSの詳細は、GTC BerlinのNVIDIAデモブースとDassault Systèmesのブースで案内されるとのことです。
| 導入企業 | 対象ソフトウェア | 報告された高速化 |
|---|---|---|
| Applied Materials | Ginestra | 最大10倍 |
| ZEISS SMT(COMSOL Multiphysics経由) | EUVリソグラフィのプラズマシミュレーション | 4倍(測定値) |
| Dassault Systèmes | Abaqus(構造)/CST(電磁界) | 8〜10倍 |
As simulation workloads grow in size and complexity, cuDSS can scale out of the box from individual workstations to large computing clusters.
シミュレーションのワークロードが大規模化・複雑化するにつれて、cuDSSは個々のワークステーションから大規模な計算クラスタまで、追加設定なしでスケールできます。
今後の見通し
今回の一般提供により、cuDSSは特定顧客向けの要素技術から、CAE・EDAベンダーが製品に組み込めるライブラリへと位置づけが移りつつあります。今後は、各ベンダーの製品版でcuDSSがどのリリースから既定で利用できるようになるか、対応GPUや必要なCUDAバージョン、価格体系がどこで公開されるかが判断材料になるとみられます。また、今回は各社が自社ツール内での高速化を報告している段階であり、同一モデル・同一条件でCPU版とGPU版を比較した第三者検証の結果が示されれば、導入判断はしやすくなるでしょう。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっての意味は、GPUによるシミュレーション加速が「自前で実装するもの」から「市販ツールに組み込まれて届くもの」になりつつある点にあります。Applied Materials、COMSOL、Cadence、Dassault Systèmes、Siemens、Synopsysといったベンダーが自社製品にcuDSSを取り込んでいるため、半導体設計や自動車、電子機器の開発現場では、ツールのバージョンアップに伴ってGPU加速が選択肢に入ってきます。自社でシミュレーションソフトや最適化ソルバーを開発している企業は、C/C++/Python/Fortranのインターフェース経由で疎行列求解部分だけをGPUに移せる可能性があります。一方で、価格や対応GPU、CPU資産との使い分けは原文に情報がなく、導入検討では各ベンダーへの確認が必要です。設計案を試せる回数が増えることは、開発期間の短縮や検討品質の向上につながるとみられます。
気になる点
- 日本企業の開発現場でも使えますか
- 原文は提供地域を明示していませんが、cuDSSは一般提供が開始されたライブラリで、C、C++、Python、Fortranの各インターフェースから既存ソフトウェアに組み込める形で提供されると説明されています。日本での提供条件やサポート体制は原文に記載がなく、現時点では公表されていません。
- 既存のCPUベースのシミュレーション環境から移行する必要がありますか
- cuDSSは既存のエンジニアリング・科学技術・最適化ソフトウェアに組み込んで使うもので、ワークステーションから大規模クラスタまで追加設定なしでスケールするとされています。ただしCPUソルバーとの併用や置き換えの手順、必要なGPU構成は原文に記載がなく、現時点では公表されていません。
- 報告されている高速化は自社のワークロードにも当てはまりますか
- 原文の数値は、Applied MaterialsのGinestraでCPUのみと比べ最大10倍、ZEISS SMTのEUVリソグラフィのプラズマシミュレーションで測定値4倍、Dassault SystèmesのAbaqus/CSTで8〜10倍など、各社が自社ツールと条件で示したものです。ワークロード依存とみられ、一般化はできません。
用語解説
- 疎行列
- 要素の多くがゼロである行列。有限要素法などのシミュレーションで大規模に現れ、求解に計算コストがかかる。
- ソルバー
- 連立方程式などを解いて数値解を求めるプログラム。シミュレーションでは計算時間の大半を占めることが多い。
- CUDA-X
- NVIDIAのGPU計算基盤CUDAを土台にしたライブラリ群の総称。cuDSSもその一つに位置づけられる。
- EUVリソグラフィ
- 極端紫外線を使う半導体露光技術。光源のプラズマ挙動の解析などに大規模シミュレーションが必要となる。
- 流体構造連成
- 流体と構造物の相互作用を同時に解く解析手法。流体と構造で異なるソルバーを連携させる必要がある。
出典
NVIDIA cuDSS Now Generally Available to Accelerate Engineering and Scientific Simulations
https://blogs.nvidia.com/blog/cudss-generally-available-engineering-scientific-simulation
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する