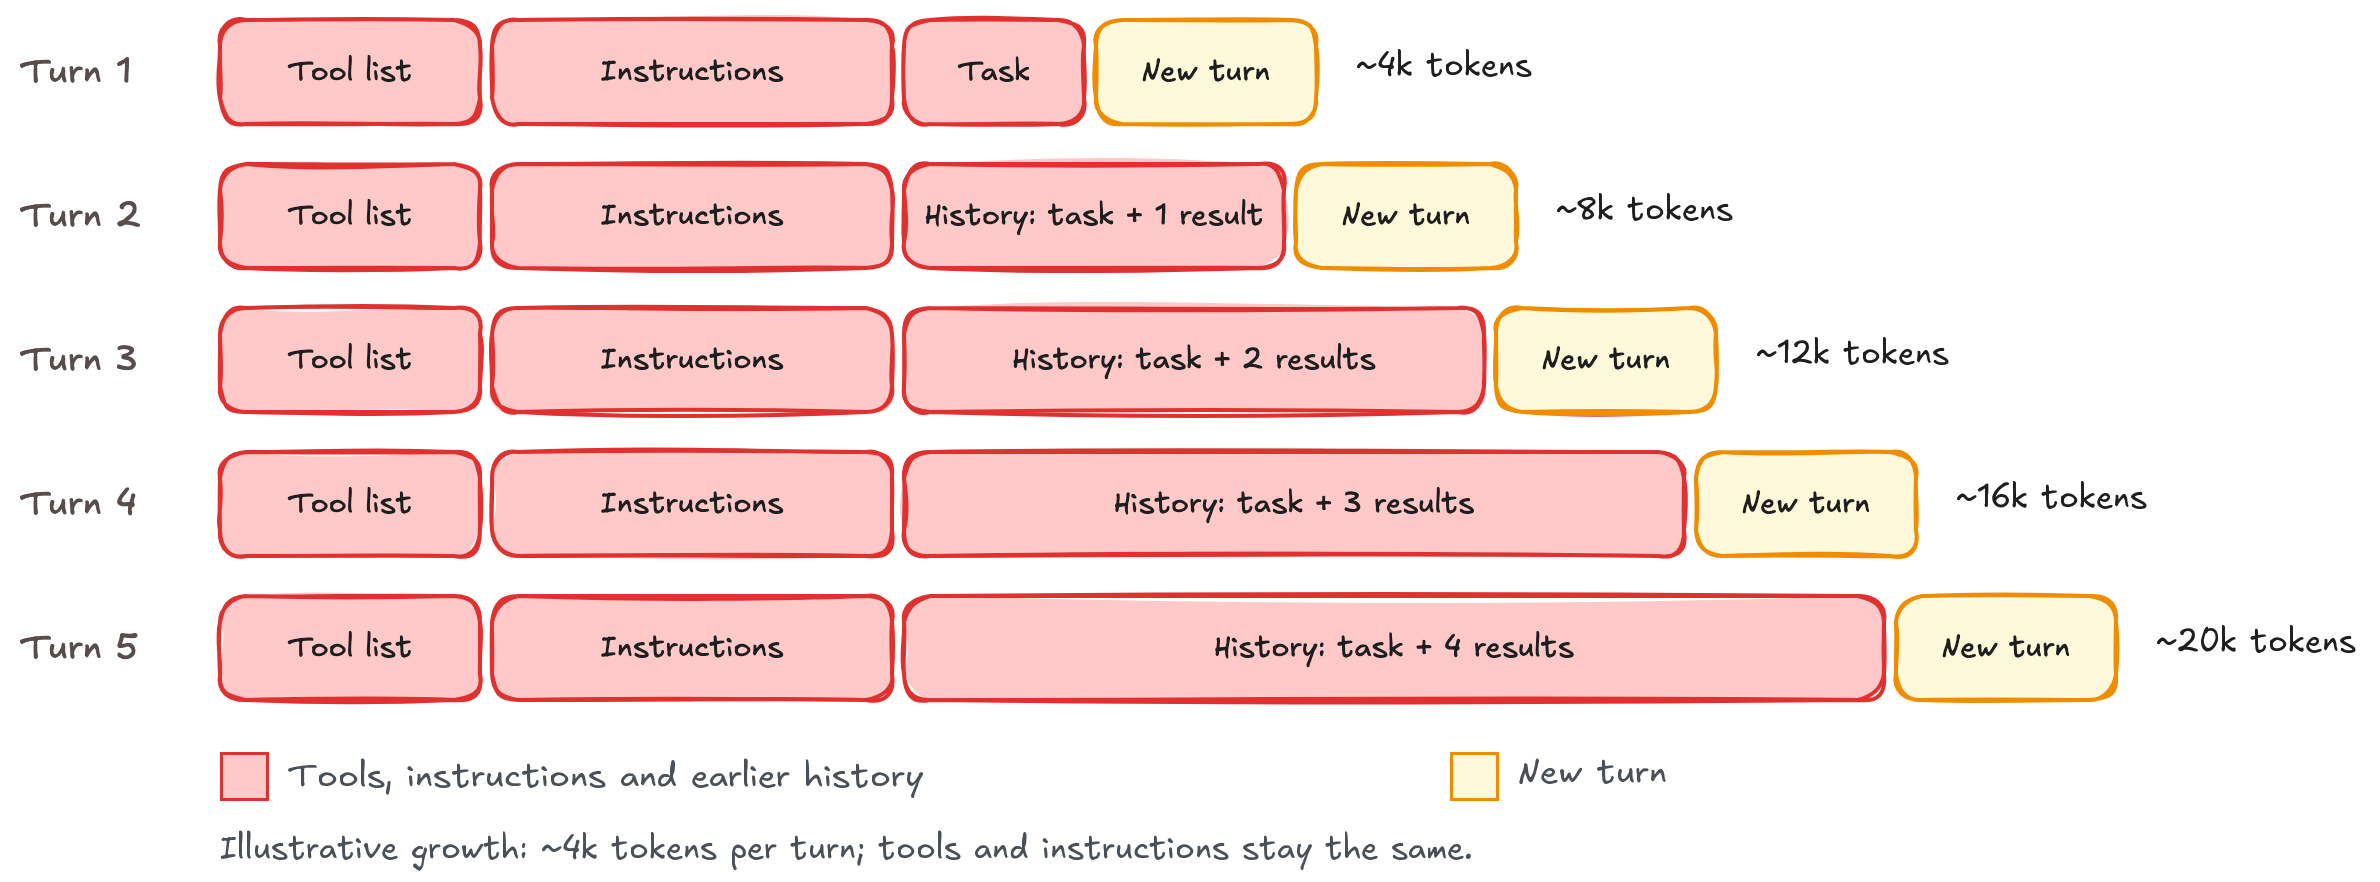
- エージェントは毎ターン全履歴を送るため、同じ入力トークンに繰り返し課金される
- Bedrockはprefillで作ったKV状態を保存し、同一プレフィックスの再計算を省く
- 明示・暗黙・併用の3通りを解説。6ターンの検証で入力コスト約62%減の例
何が公開されたのか
AWSは機械学習ブログで、Amazon Bedrock上でOpenAIのモデルを動かす際のプロンプトキャッシュの使い方を公開した。エージェントの1ターン目から、新しいツールを追加する場面、補助エージェント(サブエージェント)を起動する場面までを順に追う構成になっている。冒頭では映画「Groundhog Day」を引き合いに、毎回同じコンテキストを読み直すエージェントの姿をたとえている。
記事はまず、エージェントがLLMに送る内容を4つに分解する。ツール一覧、指示(開発者プロンプト)、これまでの履歴、そして最新のツール結果やユーザーメッセージだ。履歴はターンごとに伸びるため、20ターン目には1〜19ターン分を毎回読み直すことになり、そのトークン代は利用者が負担する。記事はこの構造がコスト増の根本だと説明している。
仕組みはprefillの再利用
モデルがプロンプトを読むとき、最初にprefillと呼ばれる処理で全入力トークンを処理し、key/value(KV)ベクトルという作業状態を組み立てる。プロンプトキャッシュはこの状態を保存しておき、後続リクエストの先頭が同じトークン列であれば、計算し直さずに読み込んで差分だけを処理する。これにより、毎ターン同じ前置きを読み直す費用が抑えられる。
方式は2つある。暗黙(implicit)キャッシュでは、Amazon Bedrock側が再利用できるプレフィックスの終端を選ぶ。明示(explicit)キャッシュでは、コード内のprompt_cache_breakpointで終端を指定する。両者は併用でき、記事は併用を推奨している。暗黙だけでは会話の伸びに追従できる一方、セッションをまたいでツールと指示を共有したい場合は明示のマーカーが要る、という整理だ。
3つの実装パターン
1つ目は静的な部分のキャッシュだ。ツールと指示を明示モードで保存し、prompt_cache_keyでキャッシュを共有するリクエスト群を識別する。例ではTTLを30分に設定している。再利用可能なプレフィックスは1,024トークン以上に達する必要がある、と記事は条件を示している。
2つ目は会話履歴とツール結果のキャッシュだ。暗黙モードで履歴全体を渡し、Bedrockに直近の適格なメッセージまでを保存させる。ツール呼び出しの結果を履歴に追記してループを回す形で、過去のメッセージとツール定義は変更しないことが前提になる。
3つ目は明示のローリングブレークポイントで、各バッチの最後のツール結果にマーカーを付け、それ以前のマーカーは履歴に残す。記事はさらに、指示ブロックに明示マーカーを置いたうえで暗黙モードを併用する形を、共有の起点と伸びる履歴の両方を扱える構成として示している。
数値と注意点
記事には具体的な計測値が示されている。約4,000トークンのツールと指示のプレフィックスは、最初のリクエストで4,120トークンを書き込み、以降のリクエストでは同じ4,120トークンを読み込んだ。6ターンのワークロードで、GPT-6 Astraは暗黙キャッシュが約62%、明示のローリングブレークポイントが約61%の入力コスト削減になったという。一方、ツールと指示だけを固定して履歴を毎回処理する明示のみの構成は相対コスト0.61にとどまったとしている。
注意点として、キャッシュはまったく同じテキストを渡したときだけ効くと記事は強調する。指示やツール一覧のシリアライズ方法を毎回そろえ、MCPサーバーなどは索引化して一貫させる必要がある。日付、ユーザー名、リクエストIDといった変動する情報は、キャッシュ境界より後ろに置く。ブレークポイントを1つ動かすだけでも再利用が壊れ、書き込みが繰り返される可能性があるという。
なおstore=Falseは会話履歴をアプリケーション側に残す設定であり、キャッシュを無効化するものではない。キャッシュの読み書きはusage.input_tokens_detailsのcached_tokensとcache_write_tokensで確認できる。記事は、示された数値は著者のワークロードでの結果であり、自分のエージェントで計測すべきだと付け加えている。
| 方式 | 保存範囲の決め方 | 6ターン時の入力コスト削減 |
|---|---|---|
| 明示(静的1点のみ) | ツールと指示の末尾にマーカーを置く | 相対コスト0.61(履歴は毎回再処理) |
| 暗黙(implicit) | Bedrockが会話の伸びに合わせて自動で決める | 約62%削減(GPT-6 Astra) |
| 明示(ローリング) | 各バッチの最後のツール結果にマーカーを置く | 約61%削減(同モデル・同ワークロード) |
| 併用 | ブロック単位マーカー+自動保存 | 数値の記載なし |
In one of our tests using explicit caching, the roughly 4,000-token tools-and-instructions prefix wrote 4,120 tokens on the first request and read those 4,120 tokens on later requests.
明示キャッシュを使ったテストの1つでは、約4,000トークンのツールと指示のプレフィックスが、最初のリクエストで4,120トークンを書き込み、以降のリクエストでは同じ4,120トークンを読み込みました。
今後の見通し
Bedrock経由でOpenAIモデルをマルチターンのエージェントに使う構成では、モデル選びよりもキャッシュ設計がコストを左右しうる。記事の数値はあくまで著者のワークロードでの結果なので、次の判断材料は自社のタスクでの実測値になる。加えて、モデルごと・リージョンごとのキャッシュ対応状況と料金、TTLの上限、長い会話で明示ブレークポイントをどう探すかというルールが公開されれば、設計を確定できるとみられる。記事は探索ルールの詳細には触れていない。
日本の開発者・IT企業にとっての意味
Bedrock上でOpenAIモデルを動かすエージェントを内製する企業にとって、この記事は実装レベルの指針になる。ツール定義と指示を毎ターン送り直す設計は、会話が長引くほど入力トークン費用を押し上げる。prompt_cache_keyで共有範囲を切り、指示ブロックにマーカーを置き、履歴は暗黙に追従させる、という組み合わせは、サポート窓口や社内文書検索のように同じ前置きを何度も使うエージェントで効きやすい。導入時は、指示・ツール一覧のシリアライズを固定し、日付やユーザー名を後ろへ回す設計変更が要る。さらにサブエージェントを並べる構成では、共有の起点を明示的に作れるかが設計判断になる。まずは自社タスクでcached_tokensとcache_write_tokensを計測し、投資対効果を確認したい。
気になる点
- キャッシュが効かないのはどんなときですか
- 同じテキストを渡さないと効きません。日付やリクエストIDなど変動する情報をキャッシュ境界より前に置いた場合、シリアライズの順序や書式が毎回変わった場合、ブレークポイントを動かした場合も再利用が崩れます。プレフィックスが1,024トークン未満では対象外とされています。
- キャッシュの料金はどうなっているのですか
- 原文は「入力価格の一部(a fraction of the input price)」と表現するだけで、具体的な単価は示していません。書き込みと読み込みで扱いが異なる可能性はありますが、価格表は記事に含まれていないため、現時点では公表されていないと答えるほかありません。
- 日本のリージョンでも同じ設定は使えますか
- 原文はリージョン別の提供状況に触れておらず、モデルIDは「us.openai.gpt-6-astra」という形式で示されています。日本リージョンでの可用性や、同じパラメータ名が使えるかどうかは、この記事だけでは判断できません。
用語解説
- プロンプトキャッシュ
- 同じ入力プレフィックスを再計算せず再利用する仕組み。KV状態を保存し、入力トークンの課金を抑える。
- prefill
- モデルが最初のトークンを出力する前に、入力トークン全体を処理してKV状態を作る処理。
- KVベクトル
- モデルが入力を処理したとき保持する内部状態。key/valueの略で、これを再利用するのがキャッシュ。
- ブレークポイント
- キャッシュとして保存する範囲の終端位置。prompt_cache_breakpointで明示的に指定する。
- TTL
- Time To Live。保存したキャッシュを再利用できる有効期間。記事の例では30分に設定している。
- MCP
- Model Context Protocol。外部ツールをモデルに渡す仕組み。定義の一貫性がキャッシュ成立の条件になる。
出典
Groundhog Day for AI agents: Prompt caching patterns for using OpenAI models on Amazon Bedrock
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する