- データセット追加をJSONメタデータだけで行える構成
- 認証・権限・監査をMCPサーバー層に集約
- ECS Fargateで会話状態をDynamoDBに保持
何が公開されたのか
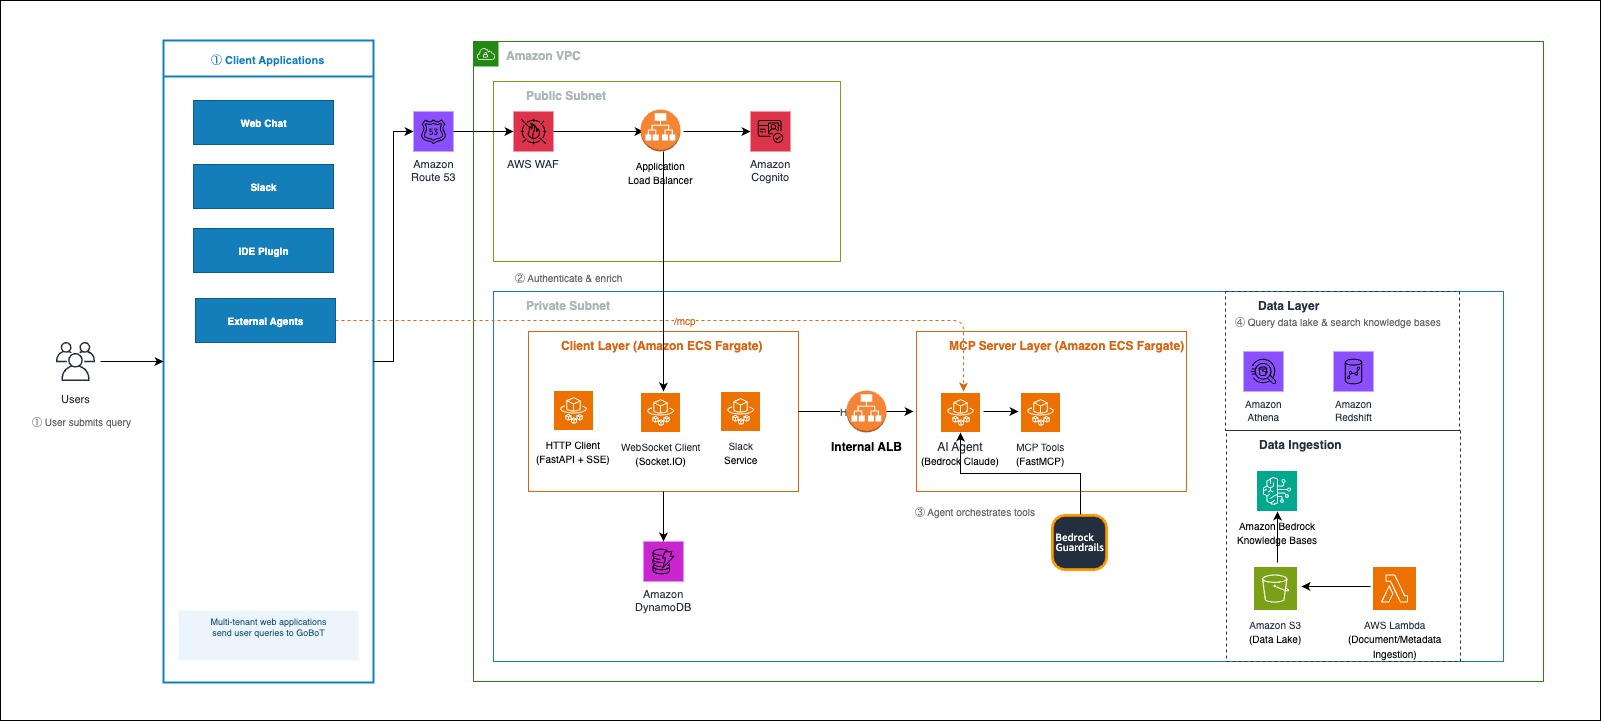
AWSの機械学習ブログで、Amazonの北米ソートセンター(NASC)ネットワークを支援するチームが、Amazon ECS Fargate上で動かすサーバーレスなMCPサーバーの構成を説明しました。これはAWSの新製品発表ではなく、AIエージェントから企業データレイクへのアクセスを共通化する実装例の共有です。複数の計画チームが運用データを会話形式で扱えるようにする目的があったとされています。
背景には、エージェントごとにデータベースやAPIへの接続を実装し、データセット追加のたびに個別コードと権限管理が必要になる問題がありました。MCPサーバーを中央のゲートウェイとして置くことで、接続ロジックとアクセス制御を1カ所に寄せる狙いです。NASCのデータレイクには数千のデータセットがあると説明されています。
4層のアーキテクチャ
構成はクライアント、MCPサーバー、ツール、ナレッジベース更新の4層に分かれます。クライアント層はRoute 53、HTTPSとAWS WAF付きのApplication Load Balancer、Cognito、DynamoDBを使い、認証とセッション状態を担当します。MCPサーバー層は別のECS Fargateクラスタで動き、BedrockのエージェントがFastMCPで構築したツールを呼び出します。
ツール層ではAthenaとRedshiftがデータレイクにSQLを実行し、Bedrock Knowledge Basesがセマンティック検索を担います。S3へのデータ取り込みとナレッジベースの更新はLambdaが処理します。MCPサーバーのタスクはステートレスで、会話状態はDynamoDBに保存するため、タスクを交換・拡張しても状態を失わない設計です。
JSONでデータ追加
新規データセットの追加は、スキーマ説明、列の意味、テーブル関係などを記したJSONメタデータファイルで行います。サーバーは次回のパイプライン同期でファイルを自動検出し、Amazon Titan Text Embeddingsでベクトル化してBedrock Knowledge Basesに登録します。データセットごとのツールコードや再デプロイは不要と説明されています。
業務コンテキストを指定する任意のマッピングを追加すると、エージェントが検索するテーブルを絞り込めます。原文では、この絞り込みによりエンドツーエンドの対話遅延が15〜20秒程度に収まったとされています。外部のMCP対応クライアントは、FastMCPによるJSON-RPCインターフェースの/mcpエンドポイントを通じ、同じツールを直接検出・呼び出せます。
従来手法との違い
従来は各エージェントがSQL生成、スキーマ知識、接続処理を個別に持ち、スキーマ変更のたびに修正が必要でした。アクセス制御もエージェントごとに分散し、監査点が一本化されない問題がありました。MCPサーバーに集約すると、SELECTのみを許可する制御やBedrock Guardrailsを全クライアントに共通適用できます。
一方、原文は特定の製品や料金、導入までの期間を比較したものではありません。示されているのはNASC向けの実装と設計意図であり、他の企業が同じ効果を得られるかは、データの種類やメタデータの品質、利用するAWSサービスに左右されるとみられます。
現時点の注意点
原文では、導入・運用コストや各サービスの利用料金、SLA、対応リージョンは示されていません。また、既存のデータカタログやBI環境からメタデータを移行する手順にも触れていません。MCPサーバーはSELECTのみを許可し、書き込み操作はツール層で拒否する設計です。
Bedrock Guardrailsは有害コンテンツのフィルタやグラウンディング確認、プロンプトインジェクションの抑制を目的とすると説明されていますが、具体的な検知率や誤検知率は公表されていません。多テナント環境での分離方式や監査ログの詳細も、原文だけでは判断できません。
| 項目 | 直接接続 | MCPサーバー経由 |
|---|---|---|
| 新規データセットの追加 | データセットごとにカスタムコードが必要 | JSONメタデータファイルを追加 |
| アクセス制御 | エージェントごとに実装され、監査点が分散 | MCPサーバー層で集中管理 |
| スキーマ変更時 | 各エージェントを個別に修正 | メタデータを更新し、再デプロイ不要 |
| クライアント対応 | エージェントごとに接続実装が異なる | MCP対応クライアントから共通ツールを利用 |
Exposing a new dataset requires only a JSON metadata file that the server discovers automatically on the next pipeline sync.
新しいデータセットの公開は、サーバーが次回のパイプライン同期時に自動検出するJSONメタデータファイルを用意するだけで済みます。
今後の見通し
今回のブログは、MCPサーバーをデータアクセスの共通ゲートウェイとして使う実装例を示しました。今後は、メタデータの記述品質がSQL生成の精度や運用負荷にどう影響するか、エージェント数やデータセット数が増えた際のスケーリング特性、実際の運用コストが明らかになると判断材料が増えます。多テナント分離や監査ログの設計、Guardrailsの実効性に関する追加情報も待たれるところです。
日本の開発者・IT企業にとっての意味
日本のIT企業が複数のAIエージェントを社内データに接続する場合、個別実装と権限管理の重複が大きな負担になります。今回の構成は、MCP対応の共通ゲートウェイに認証、監査、クエリ生成、ガードレールを寄せる一案として参考になります。データセット追加をメタデータ管理に寄せられるため、アプリケーション側の開発量を抑えつつ、データ利用の統制を強められる可能性があります。ただし、実務ではメタデータの設計・更新が新たな工程になり、AthenaやRedshift、Bedrockなどへの依存も生じます。15〜20秒程度の対話遅延が業務要件に合うか、コストと監査要件を満たせるかを検証してから採用を判断するのが現実的です。
気になる点
- 日本企業でも同じ構成を利用できますか
- 個別のAWSサービスを組み合わせた構成で、国・地域限定という記述はありません。利用できるかは、ECS Fargate、Bedrock、Athena、Redshiftなどが対象リージョンで提供されているかに依存するとみられます。原文には対応リージョンの記載はありません。
- 導入コストはどのくらいですか
- 原文には料金の記載がありません。ECS Fargate、Bedrock、Athena、Redshift、DynamoDB、Lambda、S3などの利用量に応じた課金が想定され、データ量やクエリ回数で変動します。具体的な試算には追加情報が必要です。
- 既存のデータカタログを再利用できますか
- 原文では、データセットごとにJSONメタデータファイルを用意する方式です。既存カタログから自動変換する機能や移行手順は示されていません。既存のスキーマ情報をJSONに落とせるかは、別途検証が必要です。
用語解説
- MCP
- AIアプリと外部ツール・データを接続するためのプロトコル。ツールの検出・呼び出しを共通化する。
- FastMCP
- PythonでMCPサーバーを実装するためのフレームワーク。
- Amazon ECS Fargate
- コンテナをサーバー管理なしで実行できるAWSのコンピューティングサービス。
- Amazon Bedrock Knowledge Bases
- 基盤モデル向けのマネージドRAG機能。文書を検索して回答生成に利用する。
- RAG
- 検索拡張生成。外部データを検索し、その結果を基にLLMの回答を生成する手法。
- Amazon Bedrock Guardrails
- LLM入出力に安全性やグラウンディングの制御を適用する機能。
出典
Serverless MCP server for AI agent data lake access on Amazon ECS Fargate
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する