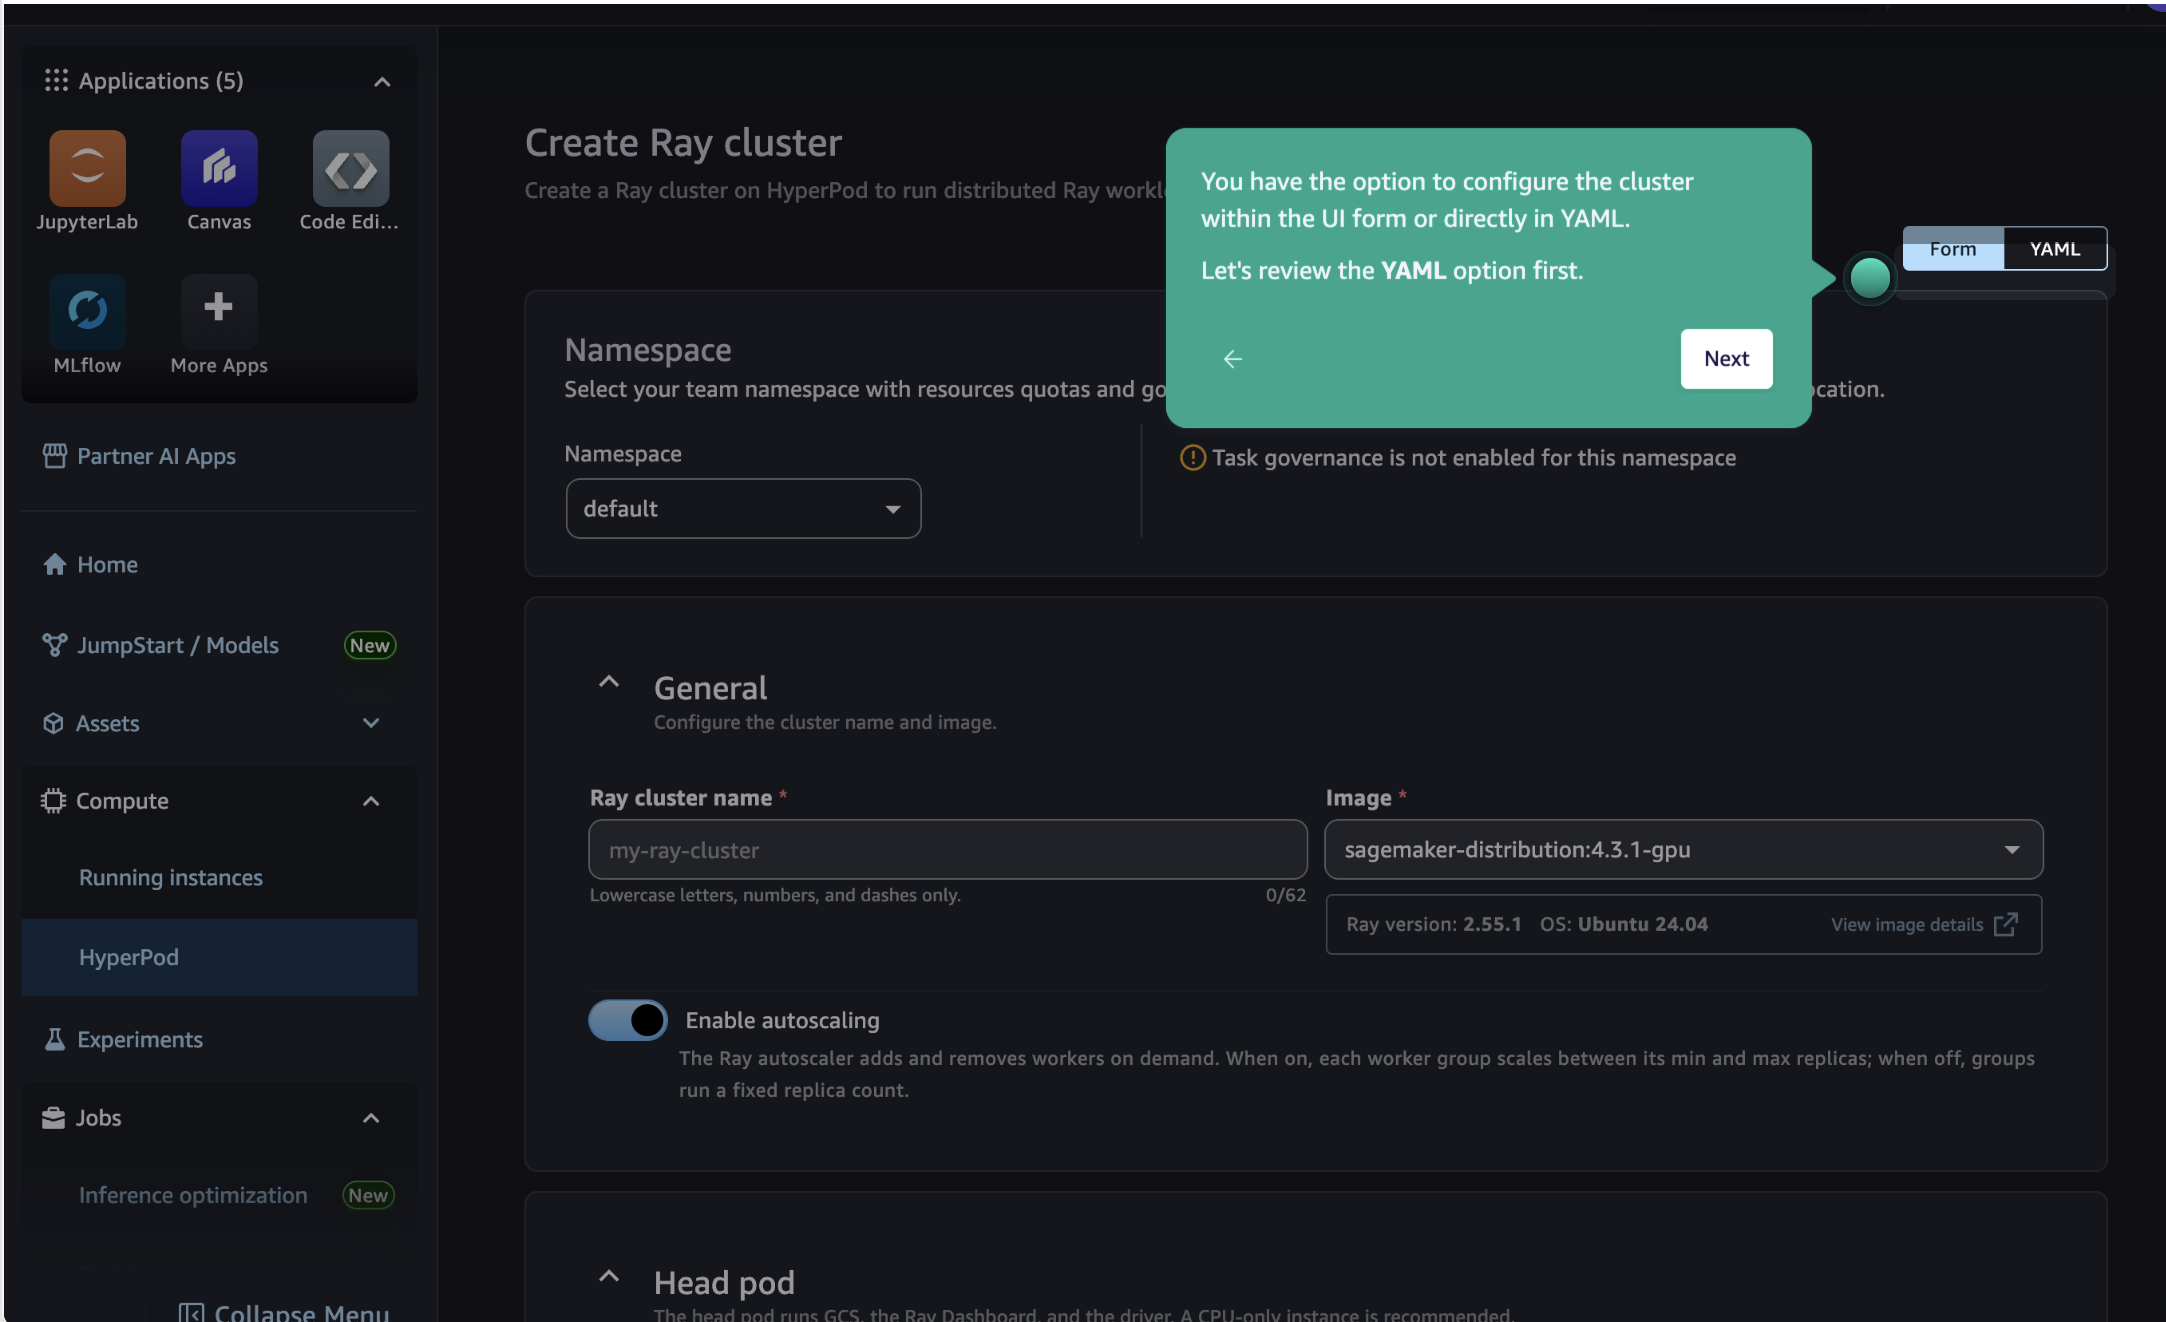
- Rayクラスタの作成・管理がSageMaker StudioのGUIから可能に
- ノード障害時の自動回復とハングジョブ検出で学習の信頼性向上
- 既存のRay APIやKubeRayと互換性を維持し、スクリプト変更は不要
発表の概要
AWSは2026年8月24日、Amazon SageMaker HyperPodでRayの新機能を発表しました。RayはPythonの分散ワークロードをGPUクラスタで実行するためのオープンソースフレームワークで、分散学習とモデル推論の両方に対応します。HyperPodはEKS上で大規模なML基盤を提供し、ノード監視と自動回復を備えています。今回の統合により、Rayのクラスタ管理と運用の多くがSageMaker Studioから行えるようになります。
従来はKubernetes上でRayを動かす際、YAMLマニフェストの記述やDockerイメージの再ビルド、kubectl port-forwardによるダッシュボードへの接続、PrometheusとGrafanaの手動設定が必要でした。新しい機能では、Rayクラスタの作成、ダッシュボードやGrafanaへのアクセス、JupyterLabやCode Editorのワークスペース接続、分散ジョブの投入、ハングしたジョブの検出がすべてSageMaker Studioから可能になります。標準のRay APIとオープンソースのKubeRayが使えるため、既存のスクリプトは変更せずに動作します。
Studioから完結するRay運用
SageMaker StudioのHyperPodコンソールでは、RayClusterの一覧が表示され、ステータスやインスタンスタイプ、利用可能なアクションを確認できます。新しいクラスタを作成する際は、クラスタ名、ヘッドとワーカーのインスタンスタイプ、ワーカー数、コンテナイメージを指定します。デフォルトではSageMaker Distributionイメージが使われ、RayがプリインストールされてAWSがパッチ適用とアップグレードを管理します。カスタムイメージにも対応しており、追加の依存関係が必要なワークロードにも柔軟に対応できます。
リモートエンドポイントを有効にすると、Ray Dashboardを開いたり、ジョブを投入したり、ログを取得したりすることが、kubectl port-forwardなしで可能になります。生成されるURLはIAM認証付きの短時間有効なものとなり、クラスタ作成者にスコープされます。さらに、toolkit-for-ray-on-sagemaker-aiパッケージを使えば、Studioや手元のラップトップ、CI/CDパイプラインから標準のRayジョブAPIを使ってリモートジョブを投入できます。アドレス解決にはsagemaker_ray://プレフィックスを使用します。
SageMaker SpacesのJupyterLabやCode EditorをRayクラスタに接続することもできます。接続したスペースはゼロコンピュートワーカーとしてクラスタに参加し、ノートブックからRay Driverを直接利用できます。ray.init(address="auto")で接続し、ランタイムに依存関係を注入するruntime_envを使ってコンテナイメージの再ビルドなしで開発を進められます。例えば、1ワーカーでプロトタイプを動かし、ScalingConfigの1行を変更するだけで4つのGPUワーカーにスケールできます。
学習の信頼性を高める3つの仕組み
SageMaker HyperPodはRay学習ワークロード向けに3つの回復性の層を提供します。1つ目は自動ノード回復で、ノードのヘルスを継続的に監視し、故障したノードを自動で置き換えます。Rayは置き換えたノードにワーカーポッドを再スケジュールします。学習コードがチェックポイントを定期的に保存し、最新のチェックポイントから再開するロジックを持っていれば、ジョブは中断された場所から再開します。RayJobのFailureConfigで再試行回数を設定しておく必要があります。
2つ目はハングしたジョブの検出です。分散学習では、1つのポッドが失敗しても他のポッドが集合通信で待ち続け、エラーも出ずにGPUを占有する状態が発生し得ます。HyperPod EKSに含まれるJob Monitoring Agentが、ノードレベルとジョブレベルの複数のシグナルを監視して、トレーニングが停止したことを自動的に検出します。検出結果はCloudWatchロググループやRay TrainのGrafanaダッシュボードに通知されます。カスタム検出ルールをtoolkit-for-ray-on-sagemaker-aiライブラリで定義し、キャンセルアクションを設定すると、ハングしたワーカープロセスを終了し、Ray TrainのFailureConfigで最後のチェックポイントから再開します。
3つ目は階層型チェックポイントです。amzn-sagemaker-checkpointingライブラリがHyperPodの管理型階層ストレージと統合し、チェックポイントをローカルディスクに書き込み、非同期でS3にアップロードします。ジョブ再開時には、まずHyperPod Tiered Storageを確認し、チェックポイントが残っていればS3からリストアするよりも高速に復旧できます。大規模モデルでは回復時間の短縮につながります。
可観測性と推論の強化
HyperPod Observability EKS add-onは、Rayヘッドとワーカーポッドのメトリクスを自動検出して収集し、Amazon Managed Grafanaに4つのダッシュボード(Ray Core、Ray Data、Ray Train、Ray Serve)を用意します。これまでPodMonitorの作成やIAMロールの設定、ダッシュボードJSONの手動インポートが必要でしたが、その作業が不要になります。既存のHyperPodインフラダッシュボード(GPU、EFA、タスクガバナンス)と同一の場所で、Rayワークロードのメトリクスとクラスタの健全性を確認できます。
推論では、Ray ServeをHyperPod上で実行でき、vLLMなどのサービングエンジンと組み合わせて使用できます。SageMaker JumpStartの統合により、トレーニング済みモデルの重みをRay Serveエンドポイントに直接ロードできます。KVキャッシュのオフロードを階層ストレージに設定すれば、長いコンテキストのリクエストを処理する際のメモリ負荷を軽減できます。モデル重みのダウンロードもtoolkit-for-ray-on-sagemaker-aiライブラリのJumpStartモデルローダーで行えます。
| 項目 | 従来のRay on Kubernetes | SageMaker HyperPod統合 |
|---|---|---|
| クラスタ作成 | YAMLマニフェスト記述 | StudioのGUIから作成 |
| ダッシュボードアクセス | kubectl port-forward | IAM認証付きURLを自動生成 |
| 可観測性 | Prometheus/Grafanaの手動設定 | add-onが自動設定、4つのダッシュボード |
| 障害回復 | 手動でのノード交換 | 自動ノード回復、ハング検出、階層チェックポイント |
These capabilities work with open-source KubeRay and standard Ray APIs, so existing scripts and workflows run without modification.
これらの機能はオープンソースのKubeRayと標準のRay APIで動作するため、既存のスクリプトとワークフローは変更なしで実行できます。
今後の見通し
今回の発表により、Rayを利用した分散学習の運用はHyperPod上で大きく簡素化される見通しです。ただし、実際の性能やコスト、リージョンごとの利用可否は本稿では明らかにされていません。今後のガイドや事例を通じて、ノード障害時の回復時間やハング検出の精度、JumpStart統合によるモデル配備の手順がどの程度実用的かを評価することが、採用判断の次のステップになるでしょう。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この統合はRayを使った大規模分散学習のハードルを下げるものです。これまでKubernetes上でRayを運用するには、YAMLやkubectl、監視基盤の構築といったインフラ知識が必須で、データサイエンティストが直接扱うのは容易ではありませんでした。SageMaker StudioからRayクラスタを扱えるようになれば、MLエンジニアはモデル開発に集中し、運用はプラットフォーム側に任せられます。また、ノード障害の自動回復やハングジョブ検出は、GPUリソースの無駄な消費を防ぎ、学習コストの削減につながります。既存のEKS環境に導入する場合、KubeRayやRay APIの互換性があるため、移行時の書き換えも最小限で済むとみられます。
気になる点
- 既存のRayスクリプトはそのまま使えますか?
- はい。標準のRay APIとオープンソースのKubeRayを使用しているため、既存のスクリプトやワークフローは変更せずに動作します。ただし、リモートジョブの投入時にはsagemaker_ray://アドレスに置き換える必要があります。
- 利用するにはどのような前提条件が必要ですか?
- Amazon EKSでオーケストレーションされたSageMaker HyperPodクラスタに、SageMaker Spaces EKS add-on、HyperPod Observability EKS add-on、KubeRay operator、HyperPod Ray Endpoint Operator(Helmチャート)をインストールしていることが前提です。SageMaker Studioドメインも必要です。
- 監視ダッシュボードを自分で作る必要はありますか?
- HyperPod Observability EKS add-onが自動で4つのGrafanaダッシュボードを用意するため、手動での設定は不要です。Ray Core、Ray Data、Ray Train、Ray Serveのメトリクスをクラスタごとにフィルタリングできます。
用語解説
- Ray
- Pythonの分散ワークロードを実行するためのオープンソースフレームワーク。分散学習(Ray Train)とモデル推論(Ray Serve)を提供する。
- KubeRay
- Kubernetes上でRayクラスタを管理するためのオープンソースのオペレーター。RayClusterやRayJobなどのカスタムリソースを提供する。
- SageMaker HyperPod
- Amazon SageMakerの機能の1つで、大規模な機械学習基盤を提供する。EKS上に構築され、ノードの監視と自動回復を備える。
- 階層型チェックポイント
- チェックポイントをローカルディスクとS3の複数の階層に保存し、再開時には高速なローカルストレージから読み込むことで復旧を早める仕組み。
出典
Introducing new Ray capabilities on SageMaker HyperPod
https://aws.amazon.com/blogs/machine-learning/introducing-new-ray-capabilities-on-sagemaker-hyperpod
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する