- 知識ファイルと推論手順の「レシピ」を分離し、再学習なしで専門家の知見を反映する
- 高密度な知識はWiki、状況依存の情報はRAGに分け、トークン消費を約80%削減
- チェックポイントとエスカレーションで人間の専門家が制御を維持する
発表内容と解決する課題
メタは2026年9月2日付の公式エンジニアリングブログで、組織の専門知識を蓄積・共有するAIエージェントの新しい設計を公開した。記事では、このエージェントが特定領域の「副次的な専門家」として機能すると説明している。専門家の深い知識を、組織の誰もがアクセスして共有・発展させられる形で保存するのが目的だ。
背景には、大企業で専門知識が個人の頭の中にとどまり、文書化されずに失われる問題がある。コンプライアンス領域では、数百件の製品レビューで同じ種類の質問が繰り返し生じる。専門家の評価に数日かかる上、評価の不整合が組織リスクになると記事は指摘する。
こうした課題に対し、専門家の推論方法を構造化して知識として蓄積する仕組みを設計した。知識はモデルの重みではなくテキストとして管理される。このため、金融やセキュリティ、エンジニアリングなど、文書化された専門知識を持つ領域に一般化できるとしている。
4層アーキテクチャと知識ファイル
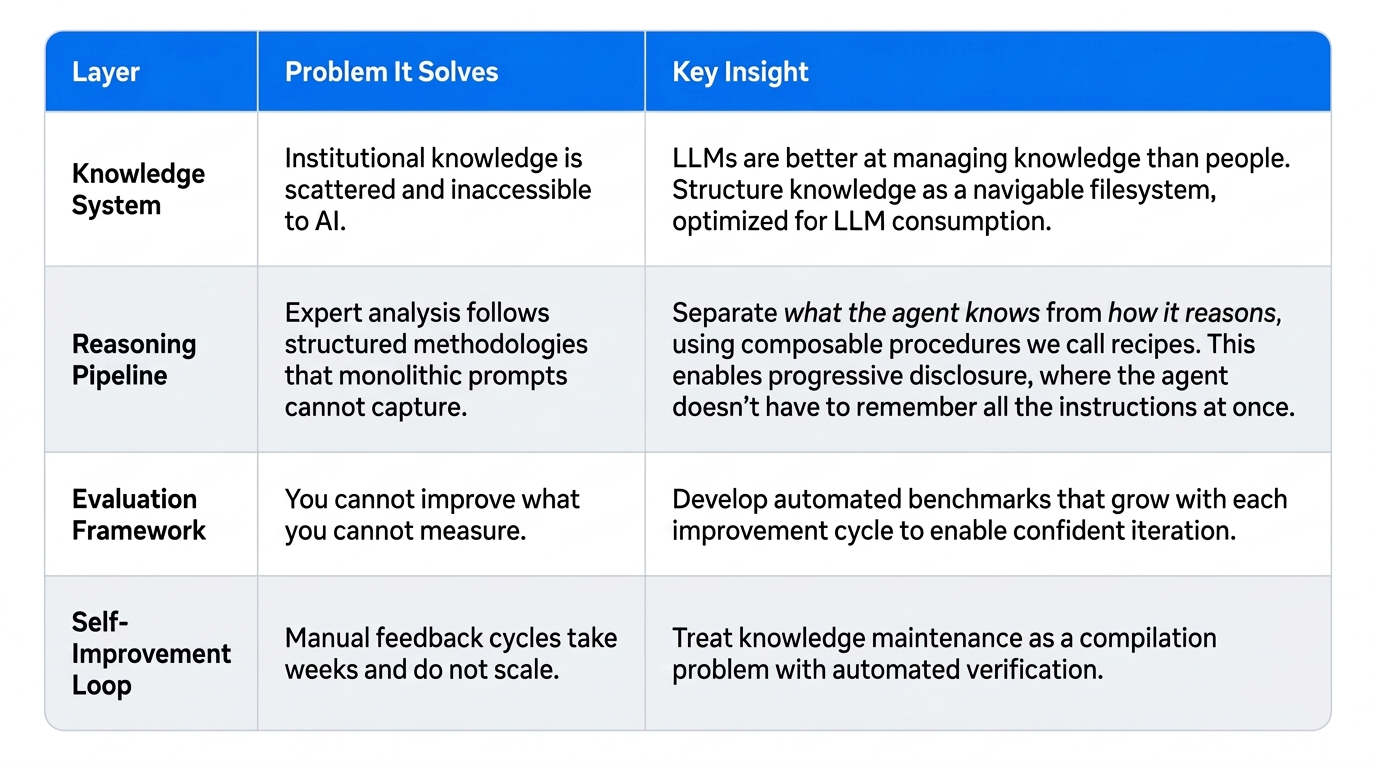
システムは4つの層で構成される。知識システムはファイル構造によって自動編集を可能にし、推論層は明示的な手順を持つため失敗の原因を特定しやすい。評価フレームワークはすべての変更を検証し、自己改善ループは知識と推論の両方にフィードバックを返す。層が互いに依存しており、1つを取り除けばほかも劣化する設計だと説明する。
知識システムの中核は、オフライン処理でソース文書を読み、構造化された知識ファイルへ蒸留する仕組みだ。200以上のファイルが厳格な分類で整理される。具体的には、組織の解釈を示すポジションファイル、用語の定義を集めたタクソノミー・語彙ファイル、入力を適切なファイルへ振り分けるルーティングインデックス、領域に進入してよいかを判定するゲートウェイファイルの4種類がある。
各ファイルはYAMLフロントマターで依存関係(depends_on)と参照元(referenced_by)を宣言し、双方向の依存グラフを形成する。1つのファイルが変わったときの影響範囲を追跡できるので、自己改善ループによる自動編集の安全性を確認できる。同じような発想は業界にもあり、Andrej Karpathy氏のLLM WikiやGoogleのOpen Knowledge Formatも、知識を事前に抽出・構造化して開示する方式を共有している。
レシピによる推論手順と知識の分離
知識だけでは専門家の判断を再現できない。専門家は事実を思い出すだけでなく、財務分析の評価モデルやセキュリティの脅威モデリングのような構造化された手順で分析する。そこで「レシピ」と呼ばれる合成可能な手続き群を導入し、複数段階の分析ワークフローを手順書として記述する。
知識ファイルとレシピの分離が重要な設計判断だと記事は説明する。知識ファイルは事実や方針を宣言的に示し、レシピは手順を命令的に示す。方針を追加するときは知識ファイルとルーティングインデックスの更新だけで済み、手順の欠陥を直すときはレシピの編集だけで済む。失敗が起きたときも、知識が間違っていたのか手順が間違っていたのか切り分けやすい。
レシピは上位のレシピが下位のレシピを呼び出すパイプライン構造を持つ。これは、料理長がソースやタンパク質の下請けレシピへ作業を委譲するような構成だ。各段階に必要な知識だけを渡すプログレッシブ・ディスクロージャーにより、初期バージョンと比べてクエリごとのトークン消費を約80%削減したと報告している。
人間の監視と自己改善ループ
人間の専門家が制御を維持するために、チェックポイントとエスカレーションの2つの仕組みを備える。チェックポイントは分析の途中で中間的な推論を提示し、専門家が確認・修正・方向転換をできるようにする。エスカレーションは入力が不十分だったり複数の解釈が可能だったりするときに、判断を専門家へ委ねる仕組みだ。これらの修正や委譲の記録は、すべて自己改善ループへの学習材料になる。
自己改善ループは、記事がもっとも特徴的だと説明する部分で、専門家のフィードバックを正確なファイル編集に変換する。依存グラフ全体を理解しながら手動で編集すると数週間かかるため、自動編集の仕組みが必須だと指摘する。記事の導入部では、専門家のフィードバックを、検証され回帰テストされた更新としてまとめ、モデル再学習なしで知識に反映するとされている。
ただし、公開された記事は設計の説明が中心で、自己改善ループの実装詳細や回帰テストの枠組み、専門家の時間削減効果を示す定量的なデータは含まれていない。記事はメタの専門家の時間を「大幅に節約している」と言及するが、裏付けとなる数値は示されておらず、評価は今後の情報公開を待つ必要があるとみられる。
| 項目 | キュレーションWiki | 補助RAG(検索拡張生成) |
|---|---|---|
| 対象となる知識 | 組織の解釈や判断枠組みを示す蒸留ファイル | 詳細な参照資料、製品仕様、判断記録など |
| 情報密度と利用頻度 | 高密度でほぼ毎ターン参照 | 低頻度で該当する状況でのみ参照 |
| 実行時の扱い | ほぼ毎回推論の際に参照 | セマンティック検索や字句検索で取得 |
A structured, auditable knowledge architecture separates what the agent knows from how it reasons.
構造化され監査可能な知識アーキテクチャは、エージェントが何を知っているかと、どのように推論するかを分離する。
今後の見通し
現時点で公開されているのは技術設計の紹介が中心で、外部向けサービスやオープンソース化の予定は示されていない。今後、自己改善ループが生み出す自動編集の回帰テストの枠組みや、専門家の時間削減効果を数値化した検証結果が示されれば、この方式の実運用可否を判断しやすくなるとみられる。コンプライアンス以外の領域での導入事例が報告されることも、設計の一般化可能性を評価する材料になる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この設計は専門家の暗黙知をAIに組み込む1つのモデルケースになる。モデル再学習なしで知識と手順を更新できる点は、企業システムでの運用コストを抑える手段として有望だ。依存関係を宣言して影響範囲を追跡できる構造は、金融や製造などで求められるガバナンスや監査の要件と親和性が高い。一方、200以上のファイルを維持するキュレーション作業と変更の検証コストは無視できず、知識管理者と更新プロセスを組織に置けるかが導入の分かれ目になりそうだ。
気になる点
- この仕組みはメタ以外の企業でも使えるのか。
- 現時点ではメタ社内のコンプライアンス領域への適用例として紹介されており、外部提供やオープンソース化の予定は公表されていない。設計は一般的なLLMと構造化ファイルで構成されるため、技術的に再現できる可能性はあるとみられる。導入には、自社の文書を知識ファイルへ蒸留する仕組みと運用体制が必要になるだろう。
- なぜモデルの再トレーニングが不要なのか。
- 専門家の知識はモデルの内部ではなく、ポジションファイルなどの知識ファイルとレシピという手順書として外部管理される。実行時にモデルへ渡すファイルを差し替えれば知識を更新できるため、モデルの再学習は不要だと説明されている。ただし、フィードバックを反映する際には回帰テストなどによる検証が必要とされる。
- 通常のRAGとの違いは何か。
- 通常のRAGがクエリのたびに文書を検索して回答を組み立てるのに対し、この方式は事前に文書を構造化ファイルへ蒸留し、推論の各段階で必要な知識だけを開示する。ファイル更新が可能なので、専門家のフィードバックを蓄積できるのが違いとみられる。低頻度の参照情報を補うためにRAGも併用する。
用語解説
- 知識ファイル
- 組織の解釈や方針を構造化して記述したファイル。エージェントの推論手順とは分離して管理される。
- レシピ
- 専門家の分析手順を複数段階のワークフローとして定義した実行手続き。知識ファイルと独立して編集できる。
- YAMLフロントマター
- ファイルの冒頭にYAML形式でメタデータを記述する構文。ここでは知識ファイルの依存関係の宣言に使われる。
- プログレッシブ・ディスクロージャー
- LLMに必要な情報を段階的に渡す設計。情報量を絞り、コンテキストの劣化を防ぐ効果がある。
- RAG
- 検索拡張生成。外部文書を検索して取得し、LLMの回答生成に組み込む手法。
出典
An Organizational Second Brain: Building an AI That Learns From Experts
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する