- アリババが初めてQwen-Max級のオープンウェイトモデルを公開
- 2.4T総パラメータ/95B活性パラメータのMoEモデルを1ノードに搭載する量子化手法を解説
- vLLMの各種フラグで推論制御・ツール呼び出し・MTP投機的デコードを有効化
Qwen3.8の概要と特徴
アリババのQwenチームは2026年8月12日、最大級のモデル「Qwen3.8-2.4T-A95B」をオープンウェイトとして公開した。Qwen-Maxクラスのモデルがオープンウェイトで提供されるのは初めてとされる。総パラメータ数は2.4兆で、トークンごとに活性化されるパラメータは約950億。エージェント型のコーディングや長期的な計画立案、自律的なツール利用といった高度な推論ワークロードを想定している。
アーキテクチャの特徴は、線形注意機構を持つ「Gated DeltaNet層」69層と、通常のフルアテンションを持つ「Gated Attention層」23層を組み合わせたハイブリッド設計だ。これにより、従来のようにコンテキスト長に比例してKVキャッシュが増えるのを抑え、最大100万トークン規模まで拡張可能としている。また、MoEは512個の小規模エキスパートで構成され、フォワードパスで使うパラメータは全体の一部に限られる。
デプロイに必要なGPUと量子化
このモデルを単一ノードで動かすには、大容量のGPUメモリが必要である。BF16精度では重みだけで約4.8TBに達し、8枚のNVIDIA B300 Blackwell Ultra GPUを搭載するp6-b300インスタンスの総メモリ約2.1TBに収まらない。そこで、AWSのブログではNVFP4量子化(W4A4)を使い、重みを約1.2TBまで圧縮している。これにより、KVキャッシュや活性値の分の余裕を残して1ノードに搭載可能になる。
量子化後のモデルは、コミュニティによってHugging Faceで公開されている。AWSのブログでは、SageMaker HyperPod上のvLLMでこの量子化モデルを読み込むための具体的なコマンド例が示されている。テンソル並列数を8にし、--quantization nvfp4などのフラグを指定する。
SageMaker HyperPodの利点とvLLM設定
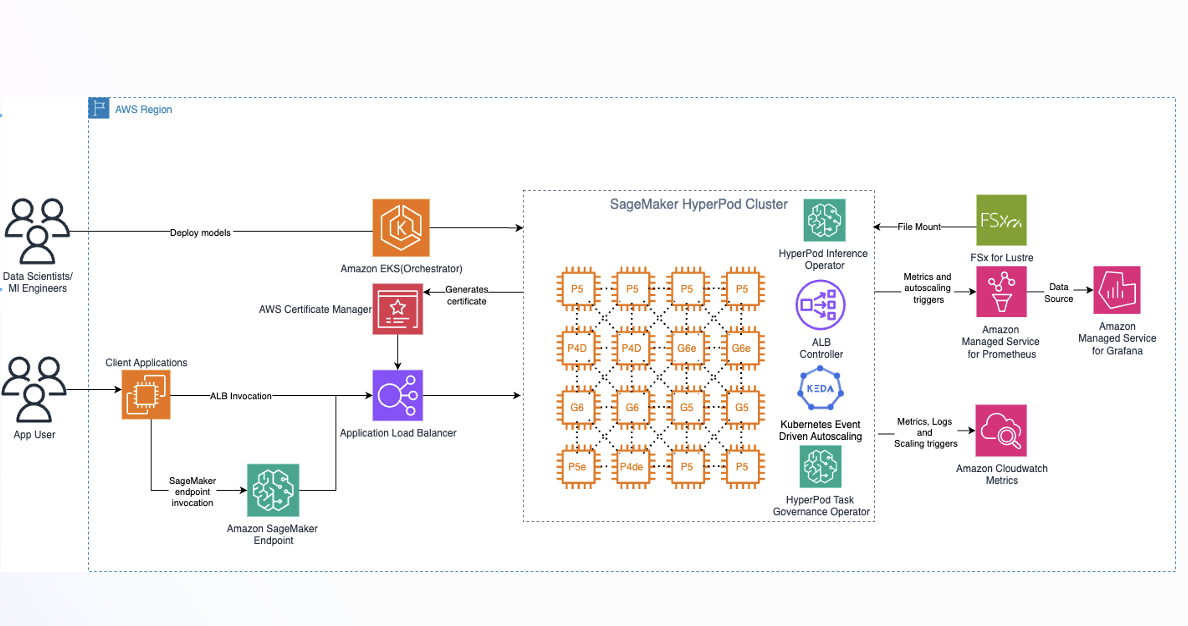
SageMaker HyperPodは、Kubernetesを制御プレーンとして使い、モデル配布やコンテナスケジューリング、ヘルスチェックなどを自動化する。推論オペレータと呼ばれるCRDを使えば、モデルの指定やGPUリソース要求、vLLMの起動引数を宣言的に管理できる。クラスタノードの障害時には自動交換が行われるため、24時間運用の負荷を下げられる。
vLLMの構成では、推論時の思考プロセスを抽出する--reasoning-parser qwen3や、関数呼び出しのための--enable-auto-tool-choice、モデル内蔵のドラフトヘッドを使う投機的デコード(MTP)を有効にする--speculative-configなどが紹介されている。これらを使えば、OpenAI互換のAPI経由で推論・ツール呼び出しを行える。
現時点での制約
このモデルを確実に稼働させるためには、ml.p6-b300.48xlargeの容量をFlexible Training Planで予約する必要がある。オンデマンドで利用できない点は注意だ。また、ベンチマーク結果はベンダー側の公表値であり、単一ノード構成での実際のスループットは示されていない。Day-0ベンチマークの数値はGB300 NVL72という異なる構成に基づく。
さらに、オープンウェイトといっても利用条件やライセンスは確認が必要だ。実際のエージェント業務に耐え得るかは、自社のワークロードで検証することが求められる。
| 項目 | BF16 | NVFP4 (W4A4) |
|---|---|---|
| 重みのメモリ占有量 | 約4.8TB | 約1.2TB |
| 単一p6-b300ノードへの搭載 | 不可(約2.1TB超過) | 可(余裕あり) |
今後の見通し
今後は、Qwen3.8-2.4T-A95Bを実際に運用した際のスループットやコストの報告が待たれる。AWS以外のクラウドやオンプレミスでのデプロイ事例が増えれば、価格や性能の比較が可能になる。また、モデルのライセンス条件や量子化の精度影響が明らかになれば、自社導入の判断に役立つ。現時点ではAWSのベンチマークを参考にしつつ、実環境での検証が不可欠とみられる。
日本の開発者・IT企業にとっての意味
日本のIT企業が自社で大規模AIモデルを運用する文脈では、オープンウェイトのフロンティアモデルをクラウド上でホストする選択肢が具体的に示された点は意義がある。API依存が避けられ、データの社外送出を抑えたい場合に有効だ。一方で、B300クラスのGPU予約やvLLMの詳細な設定など、十分なGPU運用の専門知識が求められる。SageMaker HyperPodのようなマネージドサービスを利用すればオペレーション負荷は下がるが、コストやベンダーロックインへの考慮も必要となる。
気になる点
- Qwen3.8-2.4T-A95Bを動かすにはどのGPUが必要か。
- 原文では、Amazon SageMaker HyperPod上のml.p6-b300.48xlargeインスタンス(8×NVIDIA B300 Blackwell Ultra GPU)を使う方法が紹介されている。NVFP4量子化を前提とすると、B300クラスのGPUで1ノードに収められる。
- 量子化するとモデルの性能はどの程度変わるのか。
- 原文ではNVFP4(W4A4)量子化で約1.2TBになることや、vLLMでの設定例は述べられているが、精度への具体的な影響は記載されていない。自社の用途で十分な品質かを検証する必要がある。
- このインスタンスは必要なときにすぐ使えるのか。
- ml.p6-b300.48xlargeはオンデマンドでは利用できず、Flexible Training Planによる予約容量が必要と原文にある。予約の際は、割り当てターゲットのアベイラビリティーゾーンを合わせる必要がある。
用語解説
- MoE (Mixture of Experts)
- 入力を複数の専門化されたサブネットワークに振り分け、一部のパラメータだけを活性化する方式。計算コストを抑えつつ大規模化できる。
- KVキャッシュ
- トークン生成時に過去のキーとバリューを保持するメモリ領域。コンテキストが長くなると単調に増える問題がある。
- NVFP4
- NVIDIAが提案するFP4精度の量子化形式(W4A4)。モデル重みを4ビットに圧縮し、メモリ使用量を大きく削減する。
- 投機的デコード
- 小さな補助ヘッドで複数のトークンを予測し、検証を1回のフォワードで行うことで生成速度を高める技術。
出典
Deploying Qwen3.8-2.4T-A95B on Amazon SageMaker HyperPod with vLLM
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する