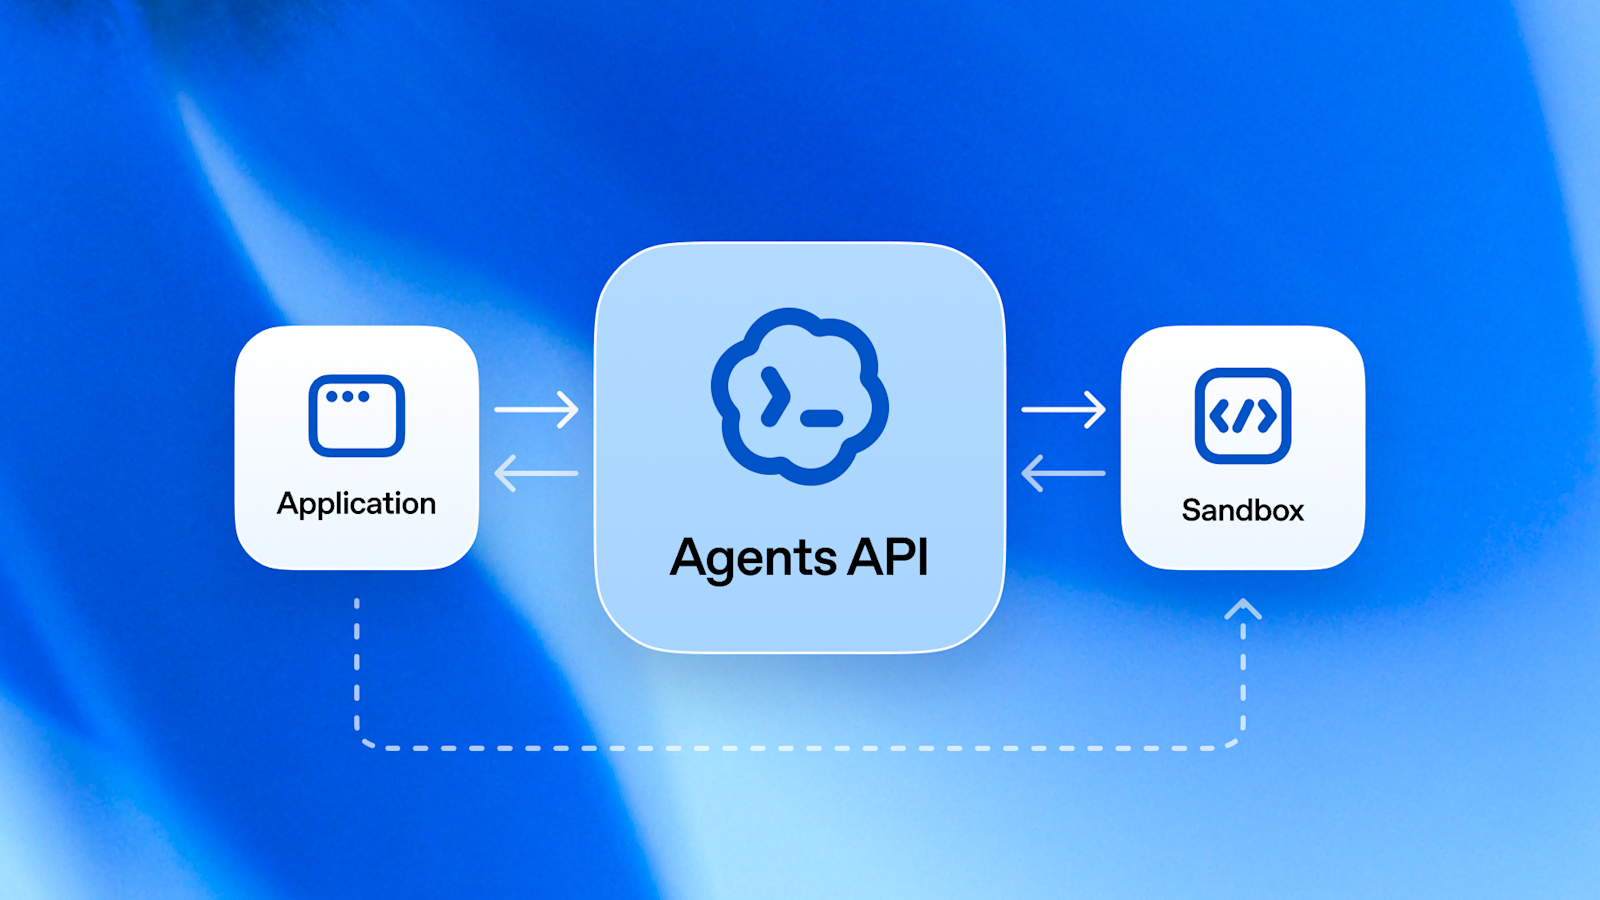
- OpenAIが「Agents API」をパブリックベータで公開し、Codexを支えるハーネスと実行基盤を提供
- 実行環境はOpenAIホスト型サンドボックス、自社インフラ、パートナー製の3通りから選択可能
- コンテキスト圧縮、ツール検索、サブエージェント並列実行をハーネス側が担い、自前実装が不要に
何が発表されたのか
OpenAIは2026年9月10日、「Agents API」をパブリックベータとして公開しました。これはCodexやChatGPT for Workを支えてきたエージェント用の「ハーネス」と実行基盤を、API経由で開発者が使えるようにするものです。ハーネスとは、モデル呼び出しやツール利用、コンテキスト管理、サブエージェント間の調整をまとめて面倒を見る仕組みを指します。
タスク、モデル、ツール、実行環境を指定すると、1回のAPI呼び出しで本番利用を想定したエージェントを作成できます。OpenAI側がハーネスをホストして保守するため、開発者はエージェント固有のツールやナレッジ、ワークフローの作り込みに集中できると説明されています。
原文のコード例では、MCP(外部ツールをモデルにつなぐ規格)経由のツール、サブエージェントの並列実行設定、保管領域のID、実行環境の種類などを指定する形が示されています。
ハーネスが担う機能
長時間のセッションを支えるため、コンテキストが上限に近づくと古いコンテキストを自動で圧縮(compaction)します。開発者が自前で圧縮ロジックを実装しなくても、複数のコンテキストウィンドウにまたがるワークフローを組めるとしています。
ツール検索(Tool search)は必要なツール定義だけを読み込み、トークン消費とコストを抑えつつモデルのキャッシュを保持します。プログラムからのツール呼び出し(programmatic tool calling)では、並列実行や連鎖、結果のフィルタ・結合をコードで行い、大量データのうち必要な結果だけをコンテキストに戻せます。ツールはMCP、カスタム関数、ウェブ検索などの組み込みツールに対応します。
マルチエージェント機能では、複雑なタスクを独立した部分に分解してサブエージェントに委任し、それぞれが自分のコンテキストを保ったまま並列で作業します。原文のコード例では gpt-6-astra というモデル名と、同時実行サブエージェント数の上限3が示されています。
実行環境は選べる
エージェントを動かす計算環境は、OpenAIが用意するホスト型サンドボックス、自社インフラ、パートナー企業のサンドボックスから選べます。OpenAIホスト型はCodexやChatGPTと同じサンドボックス基盤を利用し、ファイル、パッケージ、スキル、プラグインを柔軟に設定できるとしています。
パートナーにはBlaxel、Cloudflare、Daytona、DigitalOcean、E2B、Modal、Oracle、Runloop、Vercelが名を連ねます。VPC内へのデプロイ、ファイルやシークレットの保管方式、CPU・GPU・メモリ構成などを、性能やコールドスタート、コスト特性を含めて選べると説明されています。
料金と利用者の評価
料金について、Agents API自体の追加費用はなく、エージェントが使ったトークンとツールの分を支払う仕組みだと説明されています。パブリックベータの間はフィードバックをもとに素早く改善を重ね、一般提供を目指すとしています。
原文では複数の利用企業のコメントが紹介されています。評価スコアが0.71から0.85に上がりレイテンシが4分の1になったという声、事例レビューの移行で1件あたりのコストが60%減ったという声、ハーネスとサンドボックスを分離して失敗応答が86%減ったという声などが挙げられています。物流企業Nashは数千規模の長時間稼働エージェントを運用していると述べています。
現時点で分かっていないこと
一般提供(GA)の時期や、ベータ期間中の仕様変更の範囲については原文に記載がありません。パブリックベータである以上、APIの形や対応モデルは変わり得るとみられます。
ハーネスはオープンソースのCodexハーネスを基にしており、開発者は公開コードベースを確認できるとされています。ただしAgents API側でOpenAIが運用・保守する部分との境界や、公開されている範囲の詳細は原文では触れられていません。
利用企業のコメントはいずれも導入企業によるもので、測定条件や比較対象は原文に示されていません。示された数値をそのまま自社環境に当てはめられるものではない点は注意が必要です。
| 項目 | OpenAIホスト型 | 自社インフラ | パートナー製サンドボックス |
|---|---|---|---|
| 運用主体 | OpenAI | 開発者自身 | 各パートナー企業 |
| 主な特徴 | CodexやChatGPTと同じサンドボックス基盤。ファイルやパッケージ、スキル、プラグインを設定可能 | 原文では「自社インフラ上」とのみ記載 | VPC内デプロイ、ファイル・シークレット保管、CPU・GPU・メモリ構成を選択可能 |
| 向くケース | 素早く始めて効率的にスケールしたい場合 | 自社の基盤で動かしたい場合 | 性能・コールドスタート・コスト特性を自社ワークフローに合わせたい場合 |
By separating the agent harness from the sandbox, we reduced failed agent responses by 86%.
エージェントのハーネスとサンドボックスを分離することで、エージェントの失敗応答を86%削減できました。
今後の見通し
今後の焦点は、パブリックベータから一般提供(GA)へ移る時期と、その際にAPIの仕様や料金体系がどう変わるかです。OpenAIはベータ期間中にフィードバックをもとに素早く改善するとしているため、ハーネスの機能追加やサブエージェント周りの調整が続くとみられます。また、パートナー各社のサンドボックスが日本国内リージョンや国内データ保管に対応するかが明らかになれば、データの置き場所に制約のある案件で採用を判断できるようになります。GA時の利用条件と、実際のトークン消費量・レイテンシの測定例が公開されれば、自前実装との比較もしやすくなるでしょう。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この発表は「エージェントの配管を自前で作るか、外部に預けるか」を判断する材料になります。これまで多くのチームが、モデル呼び出しのループ、ツール定義の読み込み、会話履歴の圧縮、複数エージェントの調整といった部分を自作してきました。Agents APIはそこをマネージドで提供し、基盤はオープンソースのCodexハーネスだとされています。自社インフラやパートナー経由でVPC内にエージェントを置ける選択肢がある点は、データの保管場所に制約のある金融・医療・公共系の案件で特に影響が大きいと考えられます。一方で、サブエージェントの並列実行はトークン消費を増やしやすく、コスト設計と権限管理をこれまで以上に見直す必要があります。
気になる点
- 料金はどうなっているのか
- 原文によれば、Agents API自体の追加費用はなく、エージェントが使用したトークンとツールの料金を支払う形です。単価はOpenAIの料金ページに記載されているとされています。サブエージェントを並列で動かすほどトークン消費は増えるため、実運用では消費量の見積もりが重要になります。
- 自社インフラや既存環境でも使えるのか
- 実行環境として、OpenAIホスト型サンドボックスのほか、自社インフラ、パートナー製サンドボックスが選択肢として明記されています。パートナー経由ではVPC内へのデプロイも挙げられています。ただし自社インフラでの具体的な導入手順や要件は原文に記載がなく、現時点では公表されていない部分です。
- 既存のエージェント実装から移行できるのか
- プロンプトチェーンや自前のツール呼び出し管理からAgents APIに移行した例が、利用企業のコメントとして紹介されています。移行によってコストやレイテンシが改善したという声もあります。ただし具体的な移行手順や互換性の範囲は原文に記載がなく、個別の検証が必要です。
用語解説
- ハーネス
- モデル呼び出し、ツール利用、コンテキスト管理、サブエージェントの調整などをまとめて制御する仕組み。エージェントの土台となる部分。
- サンドボックス
- エージェントがコードを実行したりファイルを扱ったりするための、隔離された実行環境。
- サブエージェント
- 親エージェントから委任された個別タスクを担当し、それぞれ独立したコンテキストを持つ下位のエージェント。
- MCP
- Model Context Protocol。外部のツールやデータをモデルから使えるようにするための規格。
- コンテキストの圧縮
- 会話履歴がモデルの入力上限に近づいたとき、古い情報を要約・削減して保持する処理。原文ではcompactionと呼ぶ。
出典
Introducing the Agents API
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する