- 同じコンテキストの再送時、キャッシュヒットで入力トークンコストを最大90%削減
- Converse APIのcachePointマーカーで、モデルを変えずにプロンプトキャッシュを利用
- TTLは既定5分、チェックポイントには最低1,024トークンなどの条件がある
何が示されたか
AWSは公式ブログで、Amazon Bedrockの「プロンプトキャッシュ」機能を使ってコストとレイテンシを最適化する方法を解説した。同じコンテキストを基盤モデルに繰り返し送る場合、キャッシュヒット時のキャッシュ済み入力トークンのコストを最大90%削減できるとしている(Amazon Bedrockのプロンプトキャッシュ料金に基づく)。キャッシュを使わない場合、10,000トークンの契約書と50件の質問を送ると、モデルがすでに処理した内容に対して50万入力トークン分の料金が満額で発生するという例が示されている。
記事は、Converse APIを使った6つの実装シナリオを基礎から応用へと順に紹介する構成になっている。具体的には、メッセージ内容のキャッシュ、システムプロンプトのキャッシュ、ツール定義のキャッシュ、TTLを分ける混合キャッシュ、マルチテナントでのテナント分離、LangChain統合の6つである。
キャッシュの仕組み
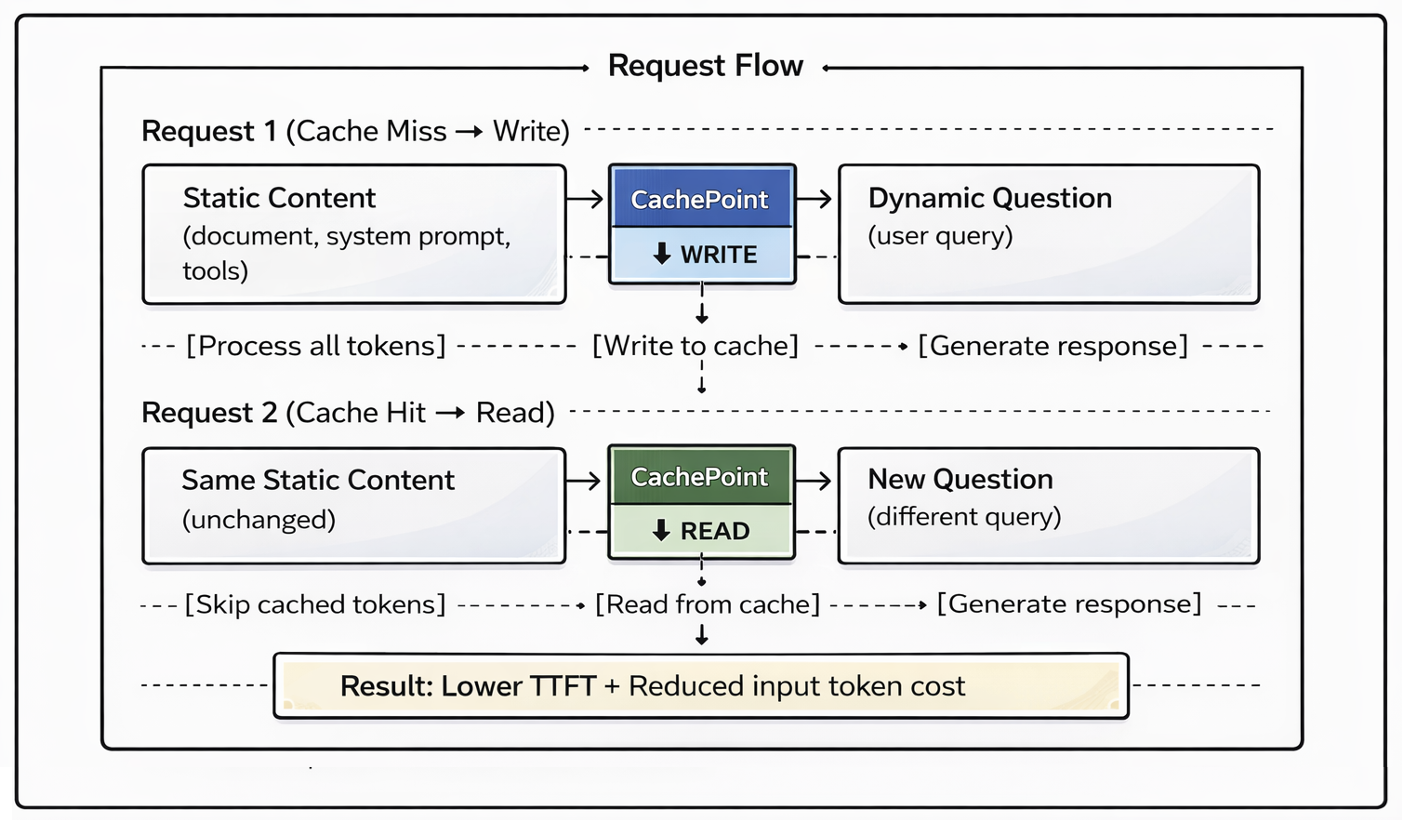
プロンプトキャッシュは、部分的に処理済みの入力をスナップショットとして保存し、同じプレフィックスを持つ後続リクエストで再計算を省く仕組みである。リクエストにcachePointマーカーを含めると、Bedrockはそのマーカーより前の内容が既存のキャッシュエントリと一致するかを評価する。一致すれば(キャッシュヒット)トークンの再処理をスキップし、キャッシュ状態から生成を始める。一致しなければ(キャッシュミス)全体を処理し、その結果を将来のリクエストのためにキャッシュへ書き込む。
実運用での挙動を決める要点は4つある。キャッシュのスコープはAWSアカウントとAWSリージョン単位であること、各チェックポイントには最低トークン数(Anthropic Claude Sonnet 4.5とSonnet 4.6は1,024トークン、Opus系は4,096トークン)が必要なこと、TTLの既定は5分で一部モデルは最大1時間まで対応すること、そしてConverse APIのcachePoint構文はAnthropic ClaudeやAmazon Novaを含む対応モデル間で共通であることだ。
コスト削減の考え方
料金面では、標準の入力・出力トークンに加えて「キャッシュ書き込み」と「キャッシュ読み取り」の2カテゴリのトークンが生じる。同じコンテキストを繰り返し使うワークロードでは、入力トークンのコスト削減はおよそ75%に達すると説明されている。10,000トークンの文書に10件の異なる質問を送る例では、最初のリクエストでキャッシュ書き込みのコストが発生し、残り9件は90%削減されたコストでキャッシュから読み取るため、正味で約75%の削減になるという計算である。
ただし、これは後続のリクエストがすべてTTL内に収まる場合の前提である。TTLを過ぎたリクエストは新たなキャッシュ書き込みを発生させ、正味の削減幅は小さくなる。実際のアプリケーションで削減効果を見積もる際には、この条件が効いてくるとみられる。
記事では、キャッシュ以外の手段とそのトレードオフも整理されている。プロンプトの短縮はトークン数を減らせるがコンテキストの品質が下がる可能性があり、コンテキスト窓の縮小は完全な情報に対する推論能力を犠牲にし、レスポンスキャッシュは同一クエリには有効でも同じコンテキストに異なる質問を組み合わせる場合は効果がない。プロンプトキャッシュはこの課題をインフラ側で緩和する位置づけである。
6つのシナリオ
記事の中心は、Converse APIを用いた6つの実践シナリオである。長い文書を複数の質問で使い回すメッセージ内容キャッシュ、ペルソナ定義や指示を会話間で再利用するシステムプロンプトキャッシュ、エージェント型ワークフローのツールスキーマをキャッシュするツール定義キャッシュが基礎編にあたる。応用編として、コンテンツ層ごとに異なるTTLを割り当てる混合TTLキャッシュ、マルチテナントアプリでのテナント分離、LangChainフレームワークとの統合が示されている。
試す際の前提条件も明記されている。Bedrockが利用できる対応リージョン(例:us-west-2)のAWSアカウント、対象モデルへのアクセス有効化、Python 3.10以降、boto3 1.43.0以降やlangchain-aws 0.2.12以降などの依存関係が必要である。例ではAnthropic Claude Sonnet 4.5(global.anthropic.claude-sonnet-4-5-20250929-v1:0)が使われており、これはクロスリージョン推論プロファイルでリクエストがリージョン間で自動ルーティングされるため、キャッシュ書き込みの頻度が上がることがあると注意されている。
現時点で不明な点
原文は最新のモデル対応状況についてBedrockのドキュメントを参照するよう案内しており、対応モデルやリージョンの全リストは記事内には示されていない。キャッシュ書き込み・読み取りの具体的な単価も記載はなく、価格ページへの参照にとどまる。TTLを最大1時間まで延長できる「一部のモデル」がどれを指すかも明示されていない。
したがって、個別のワークロードでどれだけ削減できるかは、TTL内に何件のリクエストが収まるか(ヒット率)と、利用するモデルやリージョンの条件次第で変わるとみられる。導入を検討する際は、実際のトラフィックでヒット率を計測したうえで判断するのが現実的である。
| 手法 | 得られる効果 | トレードオフ |
|---|---|---|
| プロンプトの短縮 | トークン数を削減できる | コンテキストの品質が下がる可能性 |
| コンテキスト窓の縮小 | コストを抑えられる | 完全な情報に対する推論能力を犠牲にする |
| レスポンスキャッシュ | 同一クエリの繰り返しに有効 | 同じコンテキストと異なる質問の組み合わせでは効果なし |
| Bedrockのプロンプトキャッシュ | キャッシュヒットで入力トークンコストを最大90%削減、TTFTを短縮 | TTL経過後は新たなキャッシュ書き込みが必要 |
This can reduce time-to-first-token (TTFT) and lower costs for cached input tokens by up to 90 percent on cache hits, without changing your model or prompt quality.
これにより、モデルやプロンプトの品質を変えることなく、キャッシュヒット時にtime-to-first-token(TTFT)を短縮し、キャッシュ済み入力トークンのコストを最大90%削減できる。
今後の見通し
今後は、対応モデルと対応リージョンの拡大、TTL上限の延長、キャッシュ書き込み・読み取りの価格体系の明確化が焦点になるとみられる。特に、クロスリージョン推論プロファイルを使う場合にキャッシュヒット率がどう変わるかは、実運用のコストを左右する。判断材料としては、Bedrockのドキュメントで最新の対応モデル・リージョン一覧と単価が更新されるか、また他社の基盤モデルサービスが同種のキャッシュ機能をどう価格設定するかが挙げられる。自社のトラフィックでヒット率を計測できれば、削減効果の見積もり精度は上がるとみられる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この機能はLLMアプリのランニングコストと応答速度に直結しうる。RAGで同じ社内文書に多数の質問を投げる用途、コードベースを参照するコーディング支援、ツール定義を伴うエージェント、テナントごとにデータを分けるSaaSなどは「同じコンテキストと異なる質問」という形になりやすく、レスポンスキャッシュでは効果が出にくい領域である。プロンプトキャッシュはインフラ側でこれを処理するため、プロンプトを短くして品質を落とす、コンテキスト窓を削って推論能力を犠牲にするといった妥協を避けられる。一方で、TTLの既定が5分であること、キャッシュがアカウントとリージョン単位でスコープされること、クロスリージョン推論ではキャッシュ書き込みが増えうることは設計上の制約になる。料金はキャッシュ書き込みと読み取りの2カテゴリが加わるため、移行時にはコスト試算の前提を見直す必要がある。
気になる点
- プロンプトキャッシュを使うと、コストはどれくらい下がりますか。
- 原文によれば、キャッシュヒット時のキャッシュ済み入力トークンのコストは最大90%削減されます。10,000トークンの文書に10件の質問を送る例では、正味で入力トークンの約75%削減になると説明されています。ただし、後続のリクエストがTTL(既定5分)内に収まることが前提です。
- 日本のリージョン(東京など)でも使えますか。
- 原文は対応リージョンの一例としてus-west-2を挙げ、最新の対応状況はBedrockのドキュメントを参照するよう案内しています。東京リージョンでの提供有無は記事内では明示されておらず、現時点では公表されていないとしか言えません。導入前にドキュメントで確認する必要があります。
- 既存のLangChainアプリに組み込めますか。
- 原文のシナリオ6でLangChain統合が扱われており、langchain-aws 0.2.12以降が必要とされています。Converse APIのcachePoint構文は対応モデル間で共通なので、モデルを替えても同じ書き方を使える点が移行時の利点です。具体的な手順は記事の各シナリオのコード例で示されています。
用語解説
- プロンプトキャッシュ
- 入力の一部を処理済みの状態で保存し、同じ内容の再送時に再計算を省く仕組み。TTFTと入力トークンコストを削減する。
- TTFT (time-to-first-token)
- リクエストを送ってから最初のトークンが返るまでの時間。利用者が体感する応答速度に直結する指標。
- TTL (time-to-live)
- キャッシュエントリが有効な期間。Bedrockの既定は5分で、一部モデルは最大1時間まで指定できる。
- cachePoint
- Converse APIでキャッシュの境界を示すマーカー。マーカーより前の内容がキャッシュ対象になる。
- Converse API
- Amazon Bedrockでモデル共通の対話処理を行うAPI。モデルごとの差異を吸収し、同じ構文で呼び出せる。
- RAG
- 外部文書を検索して回答に利用させる手法。同じ文書へ複数の質問をする形になりやすく、キャッシュが効きやすい。
出典
Optimizing cost and latency with Amazon Bedrock prompt caching
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する