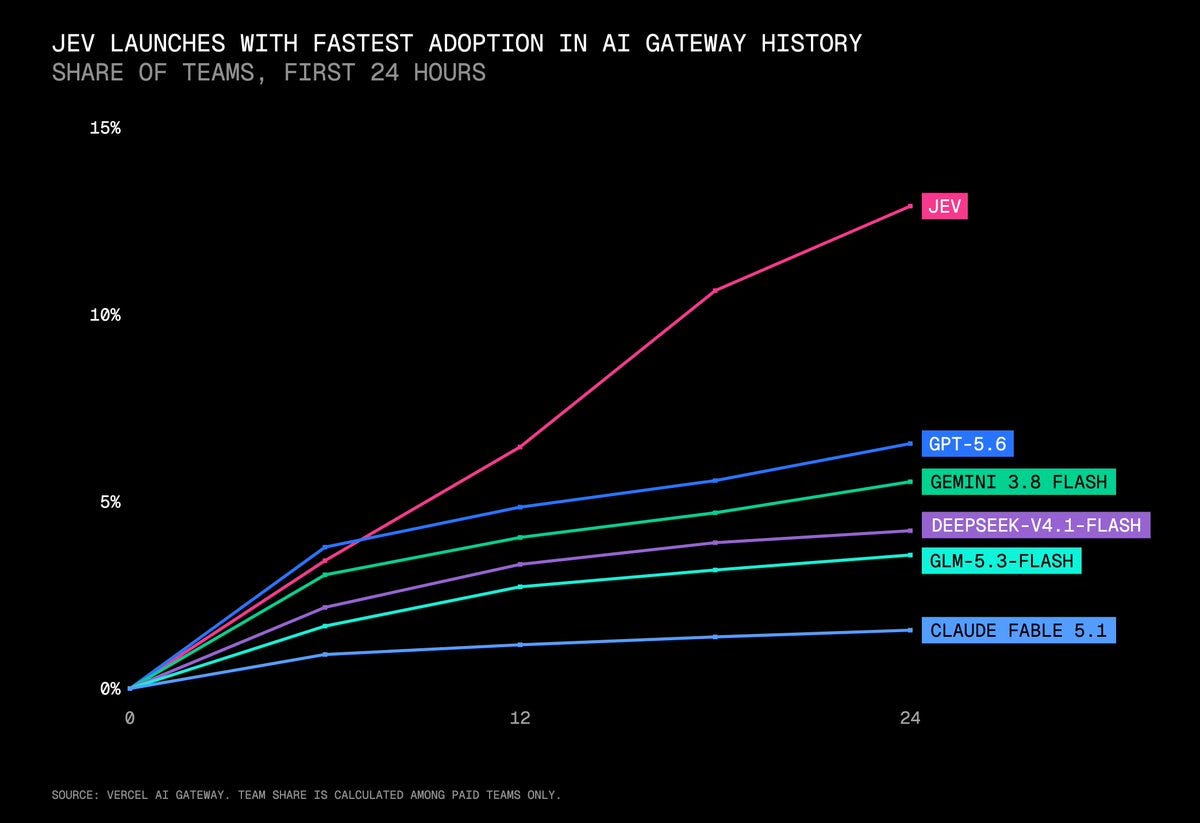
- Jevは生成を行わない判別型の「決定モデル」で、LLMを補完する高速なSystem 1として提案された
- 発表動画は2日で3600万回再生。非オープンソースだったため、再現実装が短期間に集中した
- 2日で6つのクローンが登場。ただし標準ベンチマークはなく、学習データは100%合成とされる
何が起きたのか
Jevは水曜日に発表された、生成を行わない判別型の「決定モデル」です。LLMを補完する高速な「System 1」として位置づけられています。AINewsによれば、発表動画は2日で3600万回再生され、比較としてOpenAIのNavier Stokesの結果が7400万回、AnthropicのFable 5が5700万回と紹介されています。Jevはオープンソースではなかったため、多くの推測やデモ、議論を呼びました。
実務面では、Braintrustで評価モデルとして利用できるようになったことが報告されています。ある投稿者によれば、従来の構成に比べてスコアリングコストが約400分の1になります。校正された確率を出力できる点を生かし、ルーティング、引用の選択、エスカレーション、法務オペレーションの判断といった用途が挙げられています。
技術的な位置づけ
判別型モデルは、文章を生成するのではなく、入力に対してラベルやスコアを直接出力するモデルです。Jevはこのタイプで、候補の中からどれを選ぶか、どの程度確からしいかを確率として返す用途に向きます。AINewsは、これが新しいシステムの基本部品として注目されたとまとめています。
構造に関する議論も出ています。@hxiaoは、ツール呼び出しやルーティング、MCP(Model Context Protocol)的な判断を、小さな生成LMから判別型モデルに戻せる可能性を指摘しました。@signulllはさらに踏み込み、通知やUIの適応、センサーに基づく判断など、限界費用がほぼゼロのオンデバイス判断レイヤーになると位置づけています。
再現実装が相次いだ
2日間で6つの再現実装が公開されました。ベンチマークでJevに近いとされるのはDiffusionGemmaJevで、拡散モデルをベースにしています。Bespoke NimbleはQwen3.5-9BをLoRAでファインチューニングしたもので、独自の評価ではベースのQwenが66%から90%に改善し、Jevの93%に迫ったと報告されています。H100で100msという数値も示されています。
小型の実装も登場しました。Kev-0.5BはQwen2.5-0.5BにLoRAアダプタと小さな読み出しヘッドを載せたもので、MacBook Proで動作します。Layaは421Mパラメータで、ModernBERT-largeのエンコーダに2層のトランスフォーマーを追加し、PPOで学習する構成です。SemIfはQwen3.5をバックボーンに3クラスの分類器を載せ、Jevlikeは40Kバイトの埋め込みを使う軽量な選択肢アテンション方式を採っています。
反応は経験によって分かれたとされます。ChatGPT以降のユーザーは画期的だと受け止め、GPT以前からの機械学習関係者は熱狂に懐疑的だったという指摘があります。Layaについては、認識されなかったことへの不満や、根拠を示さないままRLCDを主張している点、確信度がエントロピー基準で校正されていない点が批判として挙がっています。
まだ分かっていないこと
最大の論点は評価です。AINewsは、多くのデモが品質よりも速度を強調しており、このカテゴリの標準ベンチマークがまだ存在しないと指摘しています。各実装が出している数値は、それぞれが用意した評価での結果です。
学習データについては、100%合成であることが認められていますが、データ側の議論は十分ではないとされています。Jev自体はオープンソースではないため、内部の構成や学習方法は公開されていません。クローンの一部は「Jevに近い」とされていますが、同じ方式であることを示す情報はありません。
| 名称 | ベース・方式 | 規模・特徴 |
|---|---|---|
| Laya | ModernBERT-largeエンコーダ + 2層のトランスフォーマー | 421Mパラメータ、PPOで学習 |
| DiffusionGemmaJev | 拡散モデルをベース | ベンチマークでJevに近い |
| Bespoke Nimble | Qwen3.5-9BのLoRAファインチューニング | 評価で90%(Jevは93%)、H100で100ms |
| SemIf(旧OpenJev) | Qwen3.5(4B/35B)+ 3クラスNLI分類器 | 因果モデルのバックボーン構成 |
| Kev-0.5B | Qwen2.5-0.5B + LoRAアダプタ + 読み出しヘッド | MacBook Proで動作 |
The biggest technical conversation was around Jev, a non-generative decision model being positioned as a fast “System 1” complement to LLMs.
最大の技術的議論はJevを中心に起きた。Jevは生成を行わない決定モデルで、LLMを補完する高速な「System 1」として位置づけられている。
今後の見通し
今後は、Jevと再現実装を同じ条件で比べられる標準ベンチマークが整うかどうかが焦点になるとみられます。現時点では各実装が独自の評価で数値を出しており、横並びの比較はできません。学習データが100%合成である点や、Jev自体の構成が非公開である点も、再現性を判断するうえでの制約になります。判断材料としては、標準ベンチマークの登場、ブラウザ操作以外の用途での実運用報告、オンデバイス実行時の精度と遅延のデータが揃うかどうかが挙げられます。日本企業としては、自社の判断タスクで精度とコストを測ったうえで導入を検討する形になるとみられます。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっての意味は、LLMに任せていた「判断」を別の部品に切り出せる可能性が示された点にあります。ルーティングやエスカレーション判定、引用の選択といった処理は、生成モデルに毎回テキストを出力させるよりも、判別型モデルで確率を返す方が速く安く済む場合があります。AINewsでは評価用途で約400分の1というコスト削減が報告されており、大量のリクエストを処理するシステムでは影響が大きいと考えられます。加えて、0.5B規模やMacBook Proで動く実装が登場しているため、端末上やオンプレミスに判断レイヤーを置く選択肢も現実味を帯びます。ただし標準ベンチマークがなく、公開実装の精度は独自評価に基づくため、導入前に自社データで評価することが前提になります。
気になる点
- Jevはオープンソースですか。自社環境で動かせますか。
- 原文によればJevはオープンソースではありません。そのため内部の構成や学習方法は公開されておらず、そのまま自社環境に持ち込めるかは不明です。一方で、Qwen3.5-9BをLoRAで学習したBespoke Nimbleや、MacBook Proで動くKev-0.5Bなど、公開された再現実装が短期間に複数登場しています。
- 導入するとコストはどの程度下がりますか。
- Braintrustで評価モデルとして使う場合、従来の構成に比べてスコアリングコストが約400分の1になると報告されています。ただしこれは評価用途での報告であり、本番推論のコストや精度要件によって変わるとみられます。再現実装側ではH100で100msという数値も示されています。
- どのような用途に向いていますか。
- 確率付きの判断を返す用途が中心です。ルーティング、引用の選択、エスカレーション判定、法務オペレーションの判断などが挙げられています。加えて、LangChainやClineと組み合わせたブラウザ・コンピュータ操作のデモが注目されており、チャットボットよりもワークフローの制御に向くという見方が示されています。
用語解説
- 判別型モデル
- 入力に対してラベルやスコアを直接出力するモデル。文章を生成せず、選択肢の評価や分類に向く。
- LoRA
- 大規模モデルの重みの一部を低ランクの行列で追加学習する軽量なファインチューニング手法。
- ModernBERT
- 双方向に文脈を読むエンコーダ型のBERT系モデル。分類や埋め込み表現の生成に使われる。
- PPO
- 強化学習のアルゴリズムの一つ。報酬をもとに方策を更新し、出力の傾向を調整する。
- キャリブレーション
- モデルが出力する確率が実際の発生頻度と一致している度合い。判断のしきい値を決める際に重要になる。
- MCP
- Model Context Protocol。AIモデルと外部ツールやデータ源をつなぐための仕様。
出典
[AINews] Here are 6 Clones of Jev in 2 days
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する