- Grok 4.7がAmazon Bedrockで利用可能になり、推論effortで品質とコストを調整できる
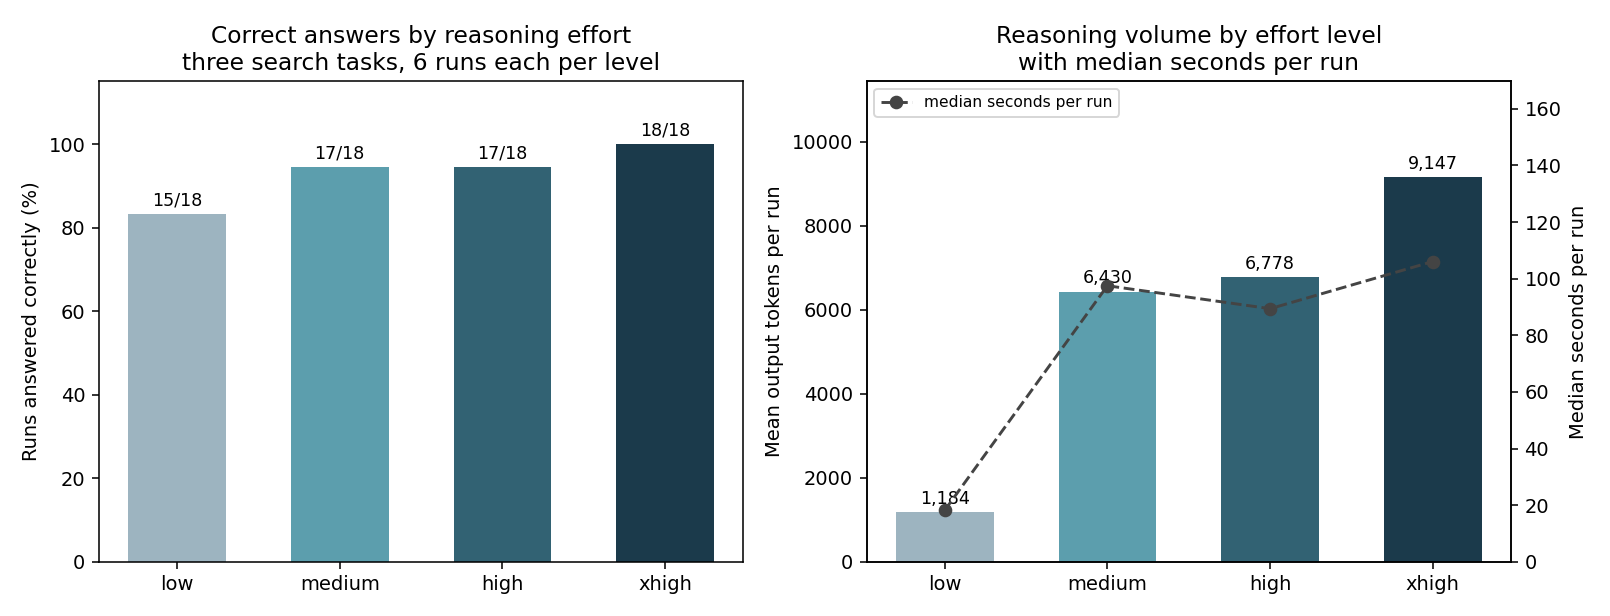
- 72回のエージェント実行のうち67回が正解、xhighは18回すべて正解だった
- lowは出力トークンがxhighの約8分の1で、18回中15回正解という結果だった
Grok 4.7がBedrockで提供開始
Amazon Web Services(AWS)は、SpaceXAIのGrok 4.7がAmazon Bedrockで利用可能になったとブログで報告しました。Amazon Bedrockは、複数のプロバイダが提供する基盤モデル(FM)を選んで使えるサービスです。SpaceXAIによると、Grok 4.7はより難しいタスクに長く取り組めるように学習され、自分の作業を検証すべきタイミングを判断できるとされています。多数の手順をたどりながら途中の結果を確認する必要があるエージェントにとって、この性質が重要になります。
SpaceXAIが公表した説明では、Grok 4.7はGrok 4.6より大きなベースモデルを使い、より難しいタスクを混ぜた長めの強化学習で訓練されています。このタスク構成は、完了までに何時間もかかる問題に重点を置いているとされます。公表されたベンチマークでも、単発の回答ではなく継続的な作業を測るカテゴリでGrok 4.6からの改善が最も大きく出ていると報告されています。コンテキストウィンドウは50万トークンで、入力はテキストと画像、出力はテキストです。
72回の実行で測ったeffort差
ブログでは、エージェントの性能を測る実験も行われています。20のサービスを7つのツールで操作できる合成環境を用意し、その上に3つのタスクを載せました。2つのサービスで起きた障害をアラートから診断するタスク、互いに影響し合う制約の下で保守スケジュールを組むタスク、予算内で最適な移行の組み合わせを選ぶタスクです。いずれも正解は1つだけで、総当たりで確認したうえで作られています。
実験は各effortレベルにつき6回、3タスク分で合計72回実行されました。エージェントは72回中67回で正解しています。レベル別ではxhighが18回すべて正解、mediumとhighがそれぞれ17回、lowが15回でした。lowは出力トークンがxhighの約8分の1で、1回あたりの中央値は18秒だったと報告されています。ツール呼び出し回数はどのレベルでも17.2〜18.7回とほぼ変わらず、effortが変えるのは探索量ではなく推論量だと説明されています。
ただし、各条件の実行回数は6回であり、レベル間の差は統計的に確定したものではなく傾向を示すものだと原文は断っています。それでも3つのタスクすべてで同じ方向の差が出た点が、結果の読み方として示されています。出力トークンはlowの1,184からxhighの9,147まで増加しました。
推論量が効くタスクの種類
移行の最適化タスクでは、候補を一つずつ順位づけする方法だと最適解に9ポイント届かない答えが出ます。medium以上では18回すべてで最適な組み合わせが見つかりました。
障害診断タスクは、候補の組み合わせを両方向から確認する必要があります。すべてのアラートが説明でき、かつ沈黙していたサービスも矛盾しないことが条件です。medium以上では18回すべてで正しい組み合わせを特定しました。
スケジュール作成は10個の制約に、参照が必要なチーム規則を組み合わせるタスクで、xhighだけが毎回正しい日程を出しました。原文は、複数の候補を比較検討する必要がある場面で追加の推論が最も役立つとまとめています。
Bedrockでの接続方法
Grok 4.7はbedrock-runtimeエンドポイントで動作し、クロスリージョン推論プロファイル経由でアクセスします。原文ではus.xai.grok-4.7と、global.相当の2つのプロファイルが示されています。APIはOpenAI互換のChat CompletionsとResponses、およびAmazon BedrockのConverse APIに対応します。Converseでは推論の内容がreasoningContentブロックとしてテキストと並んで返ります。
推論に使われたトークンは出力トークンとして数えられ、回答テキストが生成される前にmax_completion_tokensを消費します。上限に達すると回答テキストなしで応答が返るため、エージェントのコードでは空のcontentを確認する必要があります。実験では上限を32,768トークンに設定していました。
権限面では、推論プロファイルとアカウントの既定プロジェクトの両方に対してbedrock:InvokeModelが必要です。本番ではIAM IDに紐づく短期のベアラトークンを生成し、長期間有効な秘密情報を保存しない方法が推奨されています。effortレベルはモデルのバージョンによって変わりうるため、一覧をハードコードせずサービスに問い合わせて確認すべきだとされています。
現時点で分かっていないこと
原文はコストを通貨ではなくトークン数で報告しています。トークンの価格は変動するため、自社のコストはトークン数から計算するほうが測定として有効だという考え方です。具体的な単価やサービスティア、対応リージョンの一覧はAmazon Bedrockのモデルカードと価格ページを参照するよう案内されており、本文中には示されていません。
また、effortレベルごとの差は6回ずつの実行に基づくもので、統計的な裏付けは十分ではありません。日本のリージョンで利用できるかどうか、レート制限や待ち時間の実測値も原文には記載がありません。
| 項目 | low | xhigh |
|---|---|---|
| 正解した実行数(各18回中) | 15回 | 18回 |
| 平均出力トークン数 | 1,184 | 9,147 |
| 1実行あたりのツール呼び出し回数 | 17.2〜18.7でほぼ一定 | 17.2〜18.7でほぼ一定 |
Effort changes how much the agent reasons, not how much it explores. Tool calls were essentially flat, between 17.2 and 18.7 per run at every level.
effortが変えるのは、エージェントがどれだけ探索するかではなく、どれだけ推論するかである。ツール呼び出しはどの水準でも1実行あたり17.2〜18.7回でほぼ一定だった。
今後の見通し
推論effortの水準はモデルのバージョンによって変わりうると原文は指摘しており、実際にどの水準が使えるかはサービス側で確認する必要があります。今後は、低いeffortで足りるタスクと高いeffortが必要なタスクを自社のワークロードで測り、本番ではトークン数とツール呼び出し回数を監視する進め方が現実的とみられます。6回ずつの実行では統計的な裏付けが弱いため、各条件の回数を増やした追試が有効です。日本のリージョンでの提供状況やトークン単価、レート制限といった導入判断に必要な情報は、原文ではAmazon Bedrockのモデルカードと価格ページを参照する形になっており、そこが明らかになれば判断しやすくなります。
日本の開発者・IT企業にとっての意味
Bedrock経由でGrok 4.7が使えるようになったことは、日本のIT企業にとってモデル選定とコスト調整を同じIAM、同じ課金の枠内で行えることを意味します。長期のAWS利用者であれば、既存のbedrock:InvokeModel権限と短期トークンによる認証を流用でき、別ベンダーのAPIキーを新たに管理する必要はありません。実務上の最大の論点はreasoning effortの選択です。測定ではlowが出力トークン約8分の1で18回中15回正解しており、回答を後段でレビューする処理ならlow、一発の正解が求められる処理なら高いeffortという使い分けが考えられます。また、正解が1つに定まるタスクを用意して総当たりで検証する評価手法は、モデルを問わず自社エージェントの評価に流用できます。
気になる点
- 日本からも利用できますか。
- 原文ではクロスリージョン推論プロファイルとしてus.xai.grok-4.7とglobal.相当の2種類が示され、対応リージョンの一覧はAmazon Bedrockのモデルカードを参照するよう案内されています。日本のリージョンが含まれるかどうかは、この記事では明示されていません。導入前にモデルカードで確認する必要があります。
- コストはどのくらいかかりますか。
- 原文は通貨ではなくトークン数で報告しており、価格は変動するためAmazon Bedrockの価格ページを確認するよう案内しています。測定ではlowがxhighの約8分の1の出力トークンで18回中15回正解しました。推論に使われたトークンも出力トークンとして上限と課金の対象になる点に注意が必要です。
- 既存のエージェント実装をそのまま移せますか。
- Grok 4.7はOpenAI互換のChat CompletionsとResponses、およびBedrockのConverse APIに対応しています。Converseでは推論過程がreasoningContentブロックで返り、モデル固有のパラメータはadditionalModelRequestFieldsに置きます。標準的なツール呼び出しループは流用できる一方、effortの水準はハードコードせず確認が必要です。
用語解説
- reasoning effort
- モデルが回答前にどれだけ推論するかを指定する設定。低いほど出力トークンが減り、速く安くなる。
- ツール呼び出し
- モデルが外部の関数やAPIを呼び出して情報を得る仕組み。多段階で動くエージェントの基本動作になる。
- クロスリージョン推論
- 複数のAWSリージョンにリクエストを振り分け、リージョンごとの容量管理なしでスループットを高める仕組み。
- 推論プロファイル
- モデルIDの代わりに指定するルーティング用の識別子。原文ではus.xai.grok-4.7などが示されている。
- 出力トークン
- モデルが生成したトークン数。推論過程のトークンも含まれ、上限やコストの基準になる。
- 構造化出力
- JSONなど決まったスキーマに沿った形式でモデルに出力させる機能。後続処理に渡しやすくなる。
出典
Build long-horizon agents with Grok 4.7 on Amazon Bedrock
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する