- AWS SMGSチームが本番マルチエージェントシステムの品質評価基盤を構築
- 従来の監視は応答の有無しか示さず、誤った回答を検知できない
- 初回コミットから本番までの9段階の評価ループをAgentCore Evaluationsで実装
何が報告されたのか
AWSのSales, Marketing, and Global Services(SMGS)Operationsチームは、AWS Field Sales向けの本番マルチエージェントシステムを開発し、その品質評価の仕組みをブログで紹介した。このシステムは、営業担当者とリーダーという2つの利用者層に向けて、自然言語の質問に答える形でビジネスインテリジェンスを提供する。回答の範囲は担当者のテリトリーとロールレベルのセキュリティで制限される。
システムの背後では複数の専門サブエージェントが協調して動作する。Performance Insights Agentは売上データから自然言語の分析ナラティブを生成し、Customer Insights Agentは製品利用状況やサポート履歴、契約状況などを統合して顧客の360度ビューを組み立てる。Data Insights AgentはSQLを書かずに自然言語で構造化データを照会するテキストto SQLエージェントである。
品質評価の中核にはAmazon Bedrock AgentCoreのAgentCore Evaluationsが据えられ、安全性にはAmazon Bedrock Guardrails、メトリクスとアラームとトレーシングにはAmazon CloudWatch、評価結果の保存にはAmazon S3とAmazon Redshiftが使われる。ダッシュボードはAmazon Quick、カスタム評価器はAWS Lambdaが担う。
エージェント特有の難しさ
従来のソフトウェアは決定的で、同じ入力からは同じ出力が得られる。機械学習モデルは確率的な出力を持ち込み、MLOpsがその学習・バージョン管理・監視・再学習を扱うようになった。AIエージェントはさらに自律的な多段推論という第3の層を加え、問いは「何か壊れたか」から「推論の連鎖全体で妥当な判断をしているか」へと変わる。
エージェントは同じ入力でも異なる推論経路をたどり、ルーティングやツール選択、統合にわたって連鎖的に判断する。ある一段が静かに失敗すると、後続のすべてを壊しうる。最も厄介なのは、レイテンシもエラー率も平常のまま品質だけが劣化する「静かな失敗」である。原文は、エージェントが自信ありげで流暢に読めるが誤った回答を返す点を、従来ソフトウェアとの違いとして挙げている。
5つの評価軸と3つの階層
評価は5つの次元で行われる。安全性(定義された境界内で振る舞っているか)、品質(正しく一貫性があり根拠に基づく回答か)、性能(十分に速く信頼できるか)、コスト(大規模に効率よく動いているか)、運用統制(問題を迅速に検知・診断・修復できるか)である。安全性が最優先とされ、安全性の基準を満たせないエージェントは出荷も運用継続もされない。
フレームワークはエージェント階層のすべてのレベルに適用される。ツールレベルでは、顧客の曖昧性解消ツールやグラフ検索ツールといった各機能が独自の評価契約を持つ。エージェントレベルでは各サブエージェントがエンドツーエンドで評価され、マルチエージェントレベルではエージェント境界をまたぐルーティングや統合の正確性が評価される。各レベルがそれぞれ独自のゴールデンセット、評価器、昇格基準を持つ。
9段階の評価ループ
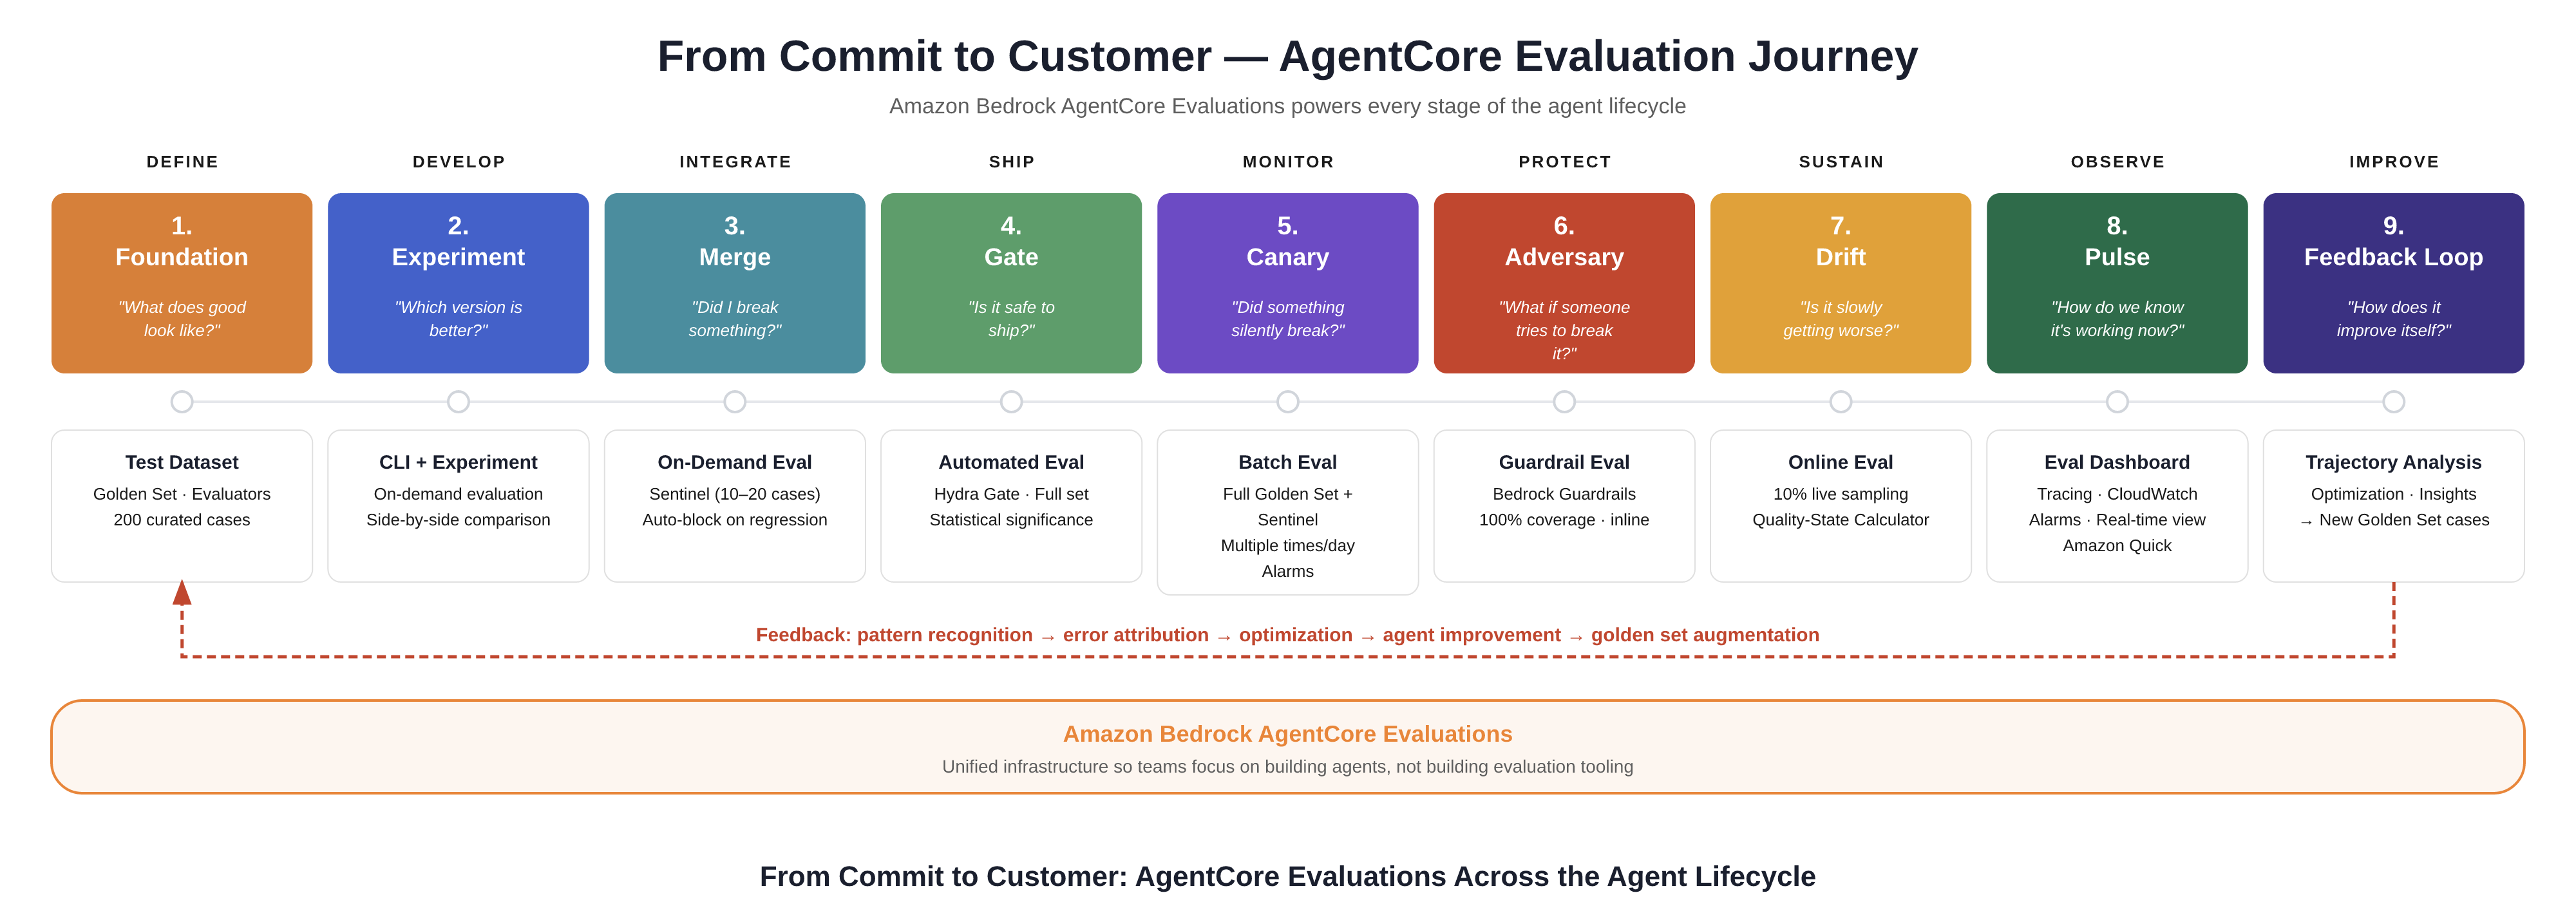
9つの段階は、初回コミットから本番応答までをたどる。各段階はチームがエージェントの成熟に伴って直面する問いに対応する。基盤では「良い状態とは何か」、実験では「どのバージョンが良いか」、マージ(CI)では「何かを壊していないか」、ゲート(CD)では「本番投入して安全か」を問う。
さらにカナリアでは「静かに壊れていないか」、敵対的検証では「誰かが壊そうとしたらどうか」、ドリフトでは「本番で品質がずれていないか」、パルスでは「今動いているかをどう知るか」、フィードバックループでは「どう自動的に良くなるか」を問う。これらは後からつなぎ合わせた別々のツールではなく、単一の連続した評価面の9つの点として位置づけられる。
実装パターンとしては、CI/CDの回帰ゲート、カナリアスコアリング、ドリフト検知、自動フィードバックループが挙げられている。原文ではシステム構成図も示されているが、各段階の詳細な手順の記述は参照した範囲には含まれていない。
本番前に見つかった誤り
ローンチ前にCustomer Insights Agentを評価したところ、いくつかの誤りが見つかった。ある顧客の3か月の売上410.08ドルを「410.08 Million(4億1,008万ドル)」と報告し、調整を除く売上高とラベルされた値を売上高として報告した。データのどこにも存在しない年間経常収益(ARR)の推計を提示し、さらに自身の計算を出典に基づく事実として提示していた。
これらの実行を通じて監視はグリーンのままだった。監視が示していたのは「システムが応答したか」であり、「回答が正しいか」ではなかった。原文は、こうした誤りが出荷されていれば現場が代償を払っていたとし、水増しされた数値を繰り返す営業担当者は顧客への信頼を失いかねないと指摘している。
リスクはローンチで終わらない。上流のパイプラインが毎週データを更新するため、リリースがなくてもリスクは増える。データ変更・ツール変更・ペアとなるプロンプト更新が同時に出荷されるべきなのにずれて着地すると、すべてが追いつくまでシステムは不整合のまま動く。ある本番前テストでは、この不整合の期間だけで合格率が78%から38%に落ちたという。
| 観点 | 従来の監視 | エージェント評価 |
|---|---|---|
| 主な指標 | レイテンシ、エラー率、稼働率 | 安全性・品質・性能・コスト・運用統制 |
| 示せること | システムが応答したか | 回答が正しいか・根拠があるか |
| 静かな品質劣化 | グリーンのまま検知しにくい | 継続測定の対象 |
Where traditional software fails loudly, agents fail softly. They return an answer that looks confident, reads fluently, and is wrong.
従来のソフトウェアが大きく失敗するのに対し、エージェントは静かに失敗する。彼らは、自信ありげに見え、流暢に読めるが、誤った回答を返す。
今後の見通し
今回の記事は、AgentCore Evaluationsを中核とした評価フレームワークの全体像と、本番前に見つかった具体的な誤りを報告するものだが、参照した範囲では各段階の詳細な実装手順は示されていない。9段階の具体的な評価器やゴールデンセットの作り方、CI/CDへの組み込み方法が公開されれば、自社エージェントへの適用可否を判断しやすくなる。また、他クラウドや独自基盤との比較、日本リージョンでの提供状況が明らかになれば、導入検討の材料になるとみられる。
日本の開発者・IT企業にとっての意味
日本のIT企業・開発者にとって、この事例はAIエージェントを本番運用する際の評価設計を考える材料になる。エージェントは従来のソフトウェアと違い、レイテンシやエラー率が正常でも回答だけが静かに誤る。社内業務エージェントや顧客対応エージェントを展開する企業は、応答の有無を監視するだけでは品質を守れない可能性がある。ツール・エージェント・マルチエージェントという3階層で評価を設計し、CI/CDの回帰ゲートやカナリア、ドリフト検知を組み合わせる考え方は、AWS以外の基盤でも参考になる。一方で、9段階を自前で実装するには相応のコストがかかるとみられ、どこまでをAgentCore Evaluationsに任せるかの見極めが実務上の論点になる。
気になる点
- 従来の監視とAgentCore Evaluationsはどう使い分けるのですか?
- 原文では両者は対立ではなく補完として扱われている。Amazon CloudWatchがメトリクス・アラーム・トレーシングを担い、従来の監視は「システムが応答したか」を示す。一方で品質の評価は、回答が正しく根拠に基づくかを継続的に測る役割を担う。原文の事例では監視がグリーンのまま誤った数値が返っていたため、応答の有無だけでは品質を守れないと説明している。
- どのような誤りを検知できるのですか?
- 原文で挙げられた例は、3か月の売上410.08ドルを「410.08 Million」と桁を誤る、調整を除く売上高としてラベルされた値を売上高として報告する、データに存在しないARR推計を提示する、自身の計算を出典に基づく事実として提示する、の4つである。いずれも文面上は流暢で、監視上は正常に見えていた点が特徴として述べられている。
- 日本リージョンでも利用できますか?
- 参照した原文の範囲では、AgentCore Evaluationsの提供リージョンや日本での利用可否、料金については言及されていない。AWSのリージョン別提供状況は公式ドキュメントで確認する必要がある。現時点では公表されていないため、導入可否は別途最新の情報で確認するのが妥当である。
用語解説
- AIエージェント
- 自律的に多段の推論を行い、ツール選択や統合を経てタスクを遂行するソフトウェア。同じ入力でも経路が異なり、失敗が静かに起きやすい。
- AgentCore Evaluations
- Amazon Bedrock AgentCoreの機能で、エージェントの品質を継続的に評価するための仕組み。本記事では9段階の評価ループの中核として使われている。
- ゴールデンセット
- 正解や期待される振る舞いをあらかじめ定めた評価用の入出力の集合。各階層が独自に持ち、昇格判断の基準として使われる。
- ドリフト検知
- 本番運用中に品質が徐々にずれていく現象を検知する取り組み。データ更新などリリースを伴わない変化でも品質は劣化しうる。
- テキストto SQL
- 自然言語の質問をSQLクエリに変換し、構造化データを照会する技術。Data Insights Agentがこれを用いている。
- カナリアスコアリング
- 新しい変更を一部にだけ適用して評価する手法。本記事では評価の実装パターンの一つとして挙げられている。
出典
Building trust in AI agents: A production-ready evaluation framework with Amazon Bedrock AgentCore
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する