- vLLMに双方向KV転送を追加、decodeが保持するKVをprefillが再利用
- EFA接続のP5en 1P1D構成で、TTFTをQwen3-32Bで約1.6倍、GLM-5-FP8で最大3.3倍削減
- ブロック保持TTL(既定480秒)と再計算しきい値(既定64トークン)で制御
vLLMに双方向KV転送を追加
AWSはMachine Learningブログで、vLLMに双方向KVキャッシュ転送(bi-directional KV transfer)の仕組みを追加したと報告しました。マルチターンのエージェント型ワークロードで、会話が長くなるほどTTFTが伸びる問題を抑える狙いです。AWSはまずTrainiumインスタンスクラスタとEFA接続の環境で構築・検証し、アクセラレータ非依存の機能としてvLLMにcontributeしたとしています。今回公開された性能データは、EFA接続のAmazon EC2 P5en GPUクラスタ上で取得したものです。
対象となるのは、prefillとdecodeを別ノードに分けるP-D分離(Prefill-decode disaggregation)構成です。prefillノードがプロンプトを処理してKVキャッシュを構築し、decodeノードがそのKVブロックを受け取って応答を生成します。従来はこの転送がprefillからdecodeへの一方向に限られていました。
一方向転送が生む2つの無駄
一方向の転送には2つの非効率があると記事は説明します。第一に、応答生成後のdecodeノードはプロンプトと生成済みトークンの両方のKVエントリを保持しますが、次のターンでprefillノードはそれを取得できず、前回応答分のKVを再計算します。
第二に、セッション状態を保持するのはdecodeノード側で、prefillノードは保持しません。そのためprefillノードでキャッシュが破棄されやすく、フルキャッシュミスになるとシステム指示・過去のプロンプト・ツール結果・モデル応答を含む会話履歴全体のKVを再計算することになります。会話が伸びるほどこの冗長な計算がアクセラレータの容量を消費し、TTFTを押し上げます。
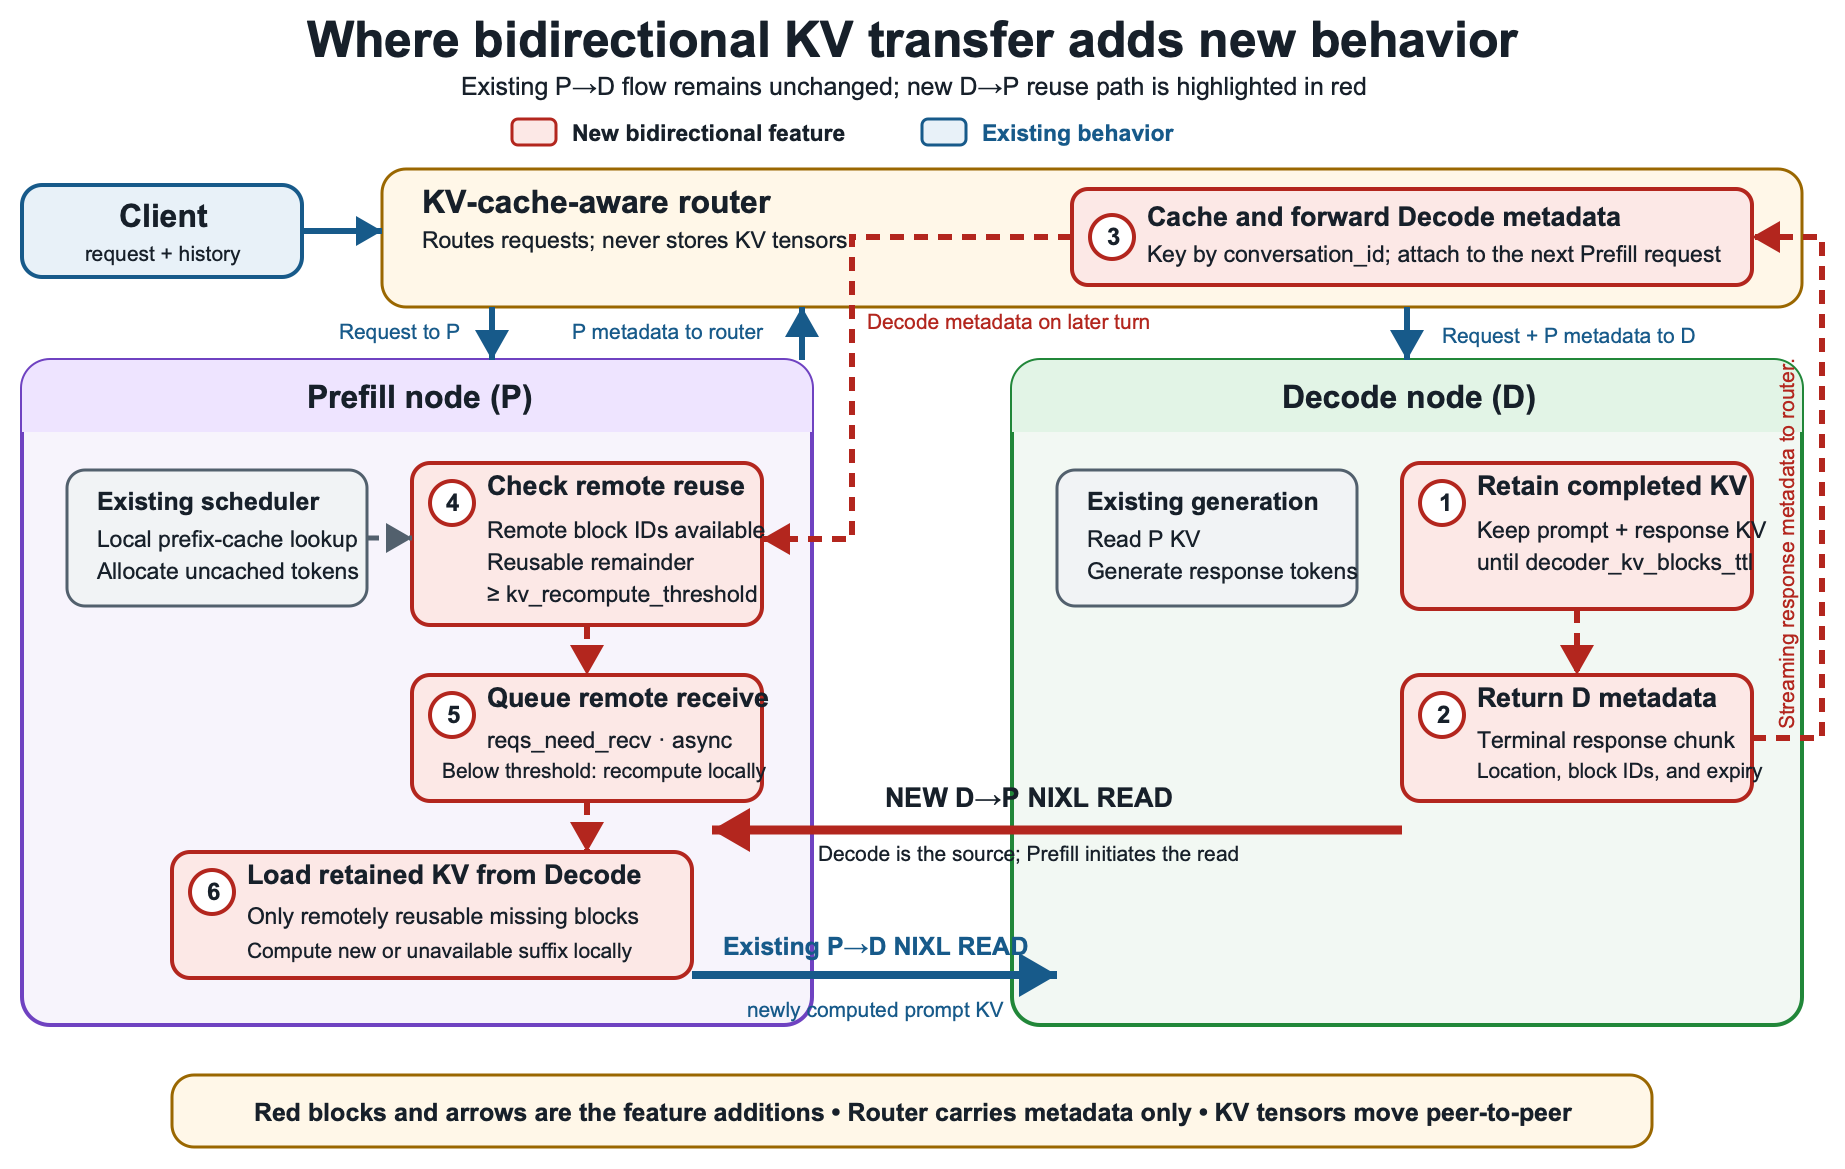
双方向化では、decodeノードが生成後に再利用可能なKVブロックを保持し、そのメタデータをストリーミング応答で返します。ルーターがそれを次のprefillリクエスト用にキャッシュし、prefillノードはローカルキャッシュ一致を適用した後に再利用可能なKVを確認します。再利用トークン数がしきい値を満たせば非同期受信をキューに入れ、残りのサフィックスを計算する前にD→PのNIXL READを実行します。転送自体はNIXL READで、P→DとD→Pに共通の仕組みを使います。
ルーターと2つの調整パラメータ
ターンをまたいだKV再利用をまとめるのが、KVキャッシュ対応ルーター(KV-cache-aware router)です。クライアント・prefill・decodeノードの間に置く軽量なステートフル制御プレーンで、クライアントが渡すconversation_idとdecodeのkv_transfer_paramsの対応をメモリ上に保持します。保持するのはブロック位置のメタデータだけでKVテンソルは持ちません。またメタデータは応答ストリームから取得し、decodeノードへ別途問い合わせることはないとしています。vLLMのGitHubには、この記事で使ったフローを実装したサンプルプロキシが公開されているということです。
調整用のパラメータは2つあります。decoder_kv_blocks_ttlはブロック保持期間でデフォルト480秒、固定値で更新されません。ターン間隔の想定に合わせて調整し、KV再利用とアクセラレータメモリ使用量のバランスを取ることになります。もう1つのkv_recompute_thresholdはデフォルト64トークンで、計算対象のトークン数がこれ未満ならprefillで再計算し、以上ならdecodeからKVを取得します。短い再利用プレフィックスでは、相互接続と調整のオーバーヘッドが再計算時間を上回り得るためです。
P5enクラスタでの性能データ
評価はAmazon EC2 P5enインスタンスをEFAで接続した1P1D構成(prefill 1台、decode 1台)で、Qwen3-32Bとzai-org/GLM-5-FP8を使いました。prefillノードのローカルキャッシュが破棄された状況や、別のprefillノードが選ばれた状況を再現するため、prefill側のプレフィックスキャッシュは無効化しています(--no-enable-prefix-caching)。
機能OFFではprefillが毎ターン拡大した文脈全体を再計算するため、TTFTが急上昇します。Qwen3-32Bは2kで158msから24kで778msへ、GLM-5-FP8は2kで500msから20kで2,334msへ上昇しました。ONではdecodeが保持するKVを再利用し、Qwen3-32Bは122msから460msへ、GLM-5-FP8は358msから702msへと抑えられています。最長プロンプト時点で、Qwen3-32Bは約1.6倍、GLM-5-FP8は最大3.3倍のTTFT削減です。
内訳を見ると、双方向転送はKV転送時間を追加します(Qwen3-32Bで約30〜130ms、GLM-5-FP8で約29〜110ms)。ただし削減されるprefill計算の方が大きく、prefill実行時間の合計はONでQwen3-32Bが128〜414ms、GLM-5-FP8が316〜541msとなり、再計算のみの経路(Qwen3-32B 153〜744ms、GLM-5-FP8 500〜2,331ms)を下回ります。トークンあたりの再計算コストが大きいGLM-5-FP8の方が差が大きい、と記事は説明しています。
現時点での留意点
性能値は特定の構成での結果であり、ハードウェア・モデル・ワークロード・ネットワーク構成によって変わると明記されています。今回の数値はEFA接続のP5en GPUクラスタのもので、Trainiumでの検証結果が今回の記事のデータとして示されているわけではありません。
TTLが固定で更新されない点も運用上の論点です。記事は、ハートビートで更新されるリースをdecode側にも広げれば、会話がアイドルになった時点でブロックを回収できるようになる、という次の改善方向を示しています。ルーターはサンプルプロキシとして提供されている段階で、本番運用には自環境向けの適応が必要とみられます。
| 項目 | Qwen3-32B | zai-org/GLM-5-FP8 |
|---|---|---|
| TTFT(機能OFF、2k→最長) | 158ms→778ms(24k) | 500ms→2,334ms(20k) |
| TTFT(機能ON、2k→最長) | 122ms→460ms | 358ms→702ms |
| 最長プロンプト時のTTFT削減 | 約1.6倍 | 最大3.3倍 |
| KV転送にかかる時間 | 約30〜130ms | 約29〜110ms |
| prefill実行時間(ON) | 128〜414ms | 316〜541ms |
Under bi-directional KV transfer mode, it holds them for a configurable lifetime (decoder_kv_blocks_ttl, default 480 seconds) and publishes their location and expiry.
双方向KV転送モードでは、デコードインスタンスは設定可能な保持期間(decoder_kv_blocks_ttl、デフォルト480秒)の間ブロックを保持し、その位置と有効期限を公開します。
今後の見通し
今回の結果は1P1D構成かつプレフィックスキャッシュを無効化した条件での計測であり、prefillノードが複数ある構成や実際のエージェント負荷でどこまで効くかは今後の検証が必要とみられます。次に判断材料になるのは、マルチprefill構成でのKV再利用のヒット率、会話のターン間隔の分布、そしてkv_recompute_thresholdをワークロードごとにどう決めるかの指針です。記事が示唆するハートビート型リースが実装されれば、固定TTLによるメモリ保持のトレードオフも変わる可能性があります。Trainiumを含む他のアクセラレータでの詳細な比較データが公開されれば、GPU以外の選択肢を検討している企業にとって判断しやすくなるでしょう。
日本の開発者・IT企業にとっての意味
マルチターンのエージェント用途では、会話履歴の再送によるprefillの再計算がレイテンシとアクセラレータ消費の主要因になりやすい状況でした。今回の変更は、広く使われる推論サーバーであるvLLMにアクセラレータ非依存の形で双方向KV転送が入ることを意味します。自前でP-D分離構成を組む企業は、prefillノードのキャッシュミスを前提にした容量設計を見直せる可能性があります。一方で、ルーターというステートフルなコンポーネントが構成に加わり、conversation_idの管理やTTL設計といった運用側の作り込みが必要になります。EFAのような低遅延インターコネクトを前提とした性能値である点も、オンプレミスや他のクラウドで構成する際の判断材料になるでしょう。
気になる点
- 自社のvLLM環境ですぐに使えますか。
- vLLM側にコネクタのサポートが入り、アクセラレータ非依存の機能としてcontributeされたとされています。ただしターンをまたぐKV再利用にはKVキャッシュ対応ルーターが必要で、vLLMのGitHubにあるサンプルプロキシを自環境に合わせて適応させる形になります。対応バージョンや导入手順の詳細は原文では明示されていません。
- どの程度の性能改善が見込めますか。
- EFA接続のAmazon EC2 P5enインスタンスによる1P1D構成で、最長プロンプト時にQwen3-32Bで約1.6倍、zai-org/GLM-5-FP8で最大3.3倍のTTFT削減が報告されています。ただしハードウェア・モデル・ワークロード・ネットワーク構成によって結果は変わると明記されており、自社環境の値は別途計測が必要です。再現手順はReproducing our resultsガイドで公開されています。
- 保持期間やしきい値はどう決めればよいですか。
- decoder_kv_blocks_ttlはデフォルト480秒の固定値で、想定されるターン間隔に合わせて調整し、KV再利用とアクセラレータメモリ使用量のバランスを取ります。kv_recompute_thresholdはデフォルト64トークンで、モデルの計算時間・KVサイズ・相互接続性能に応じてチューニングするとされています。具体的な推奨値は原文には示されていません。
用語解説
- KVキャッシュ
- 生成モデルが過去トークンの注意計算のキーと値を保持し、再利用するためのもの。再計算を省いて推論を速くする。
- P-D分離
- prefill(プロンプト処理)とdecode(トークン生成)を別ノードに分ける推論構成。それぞれに適したハードウェアを割り当てやすい。
- TTFT
- Time to First Token。リクエストを送ってから最初のトークンが返るまでの時間。対話の体感速度に直結する指標。
- NIXL
- NVIDIA Inference Xfer Library。ノード間でKVブロックなどのデータを転送するためのライブラリ。今回はREAD操作を双方向で使う。
- EFA
- AWS Elastic Fabric Adapter。AWSのサーバー間で使われる低遅延のRDMAネットワーク。GPUDirect RDMAなどに対応する。
- RDMA
- 遠隔ノードのメモリをCPUを介さず直接読み書きする通信方式。低遅延・高スループットが特徴で、KV転送の土台になる。
出典
Improve TTFT for multi-turn agentic workloads with bi-directional KV transfer in vLLM
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する