- Reflection AIがエージェント型コーディング向けのオープンウェイトモデルBeamを公開
- 総パラメータ5010億・アクティブ230億のMoEで、有効コンテキスト長は100万トークン
- Apache 2.0で公開され、SageMaker JumpStartとHyperPodの2経路でデプロイ可能
Beamとは何か
Reflection AIが公開した「Beam」は、エージェント型コーディングと長期タスク向けのオープンウェイトモデルです。コードの保守、ツールの使用、結果の解釈、複数ステップにわたるワークフローの完遂といった用途を想定しています。オープンウェイトとして提供されるため、開発者や研究者はランタイム、デプロイ環境、カスタマイズの工程を自分で制御できます。
Reflection AIは、オープンなモデル重み、公開された研究、オープンソースソフトウェアを通じて、知能を誰もが使えるようにすることを目標に掲げています。同社のAIスタックは、モデル、コアソフトウェア、本番インフラ、アプリケーションにまたがると説明されています。Beamはこの方針を、ソフトウェアエンジニアリングやエージェント型システムを手がける開発者向けに持ち込む位置づけです。
技術的な特徴
Beamは、ソフトウェアの問題解決、コードの修正、ツールの呼び出し、中間結果に基づく処理を行うスパースなMoE(Mixture-of-Experts)モデルです。総パラメータは5010億、アクティブパラメータは230億で、Reflection AIは有効コンテキスト長を100万トークンと報告しています。MoEでは入力に応じて一部のパラメータだけを使うため、総パラメータの大きさに比べて1トークンあたりの計算量を抑えられる仕組みです。
重みはHugging FaceでApache 2.0ライセンスのもと公開され、Beam 1.0としてBF16、FP8、NVFP4の3種類のチェックポイントが提供されます。これらの形式はメモリ使用量と対応ハードウェアが異なります。AWSが管理するJumpStartコンテナ設定でデプロイする方法のほか、SGLangやvLLMを使ってモデルを確認・カスタマイズする方法も用意されています。
AWSでの2つのデプロイ経路
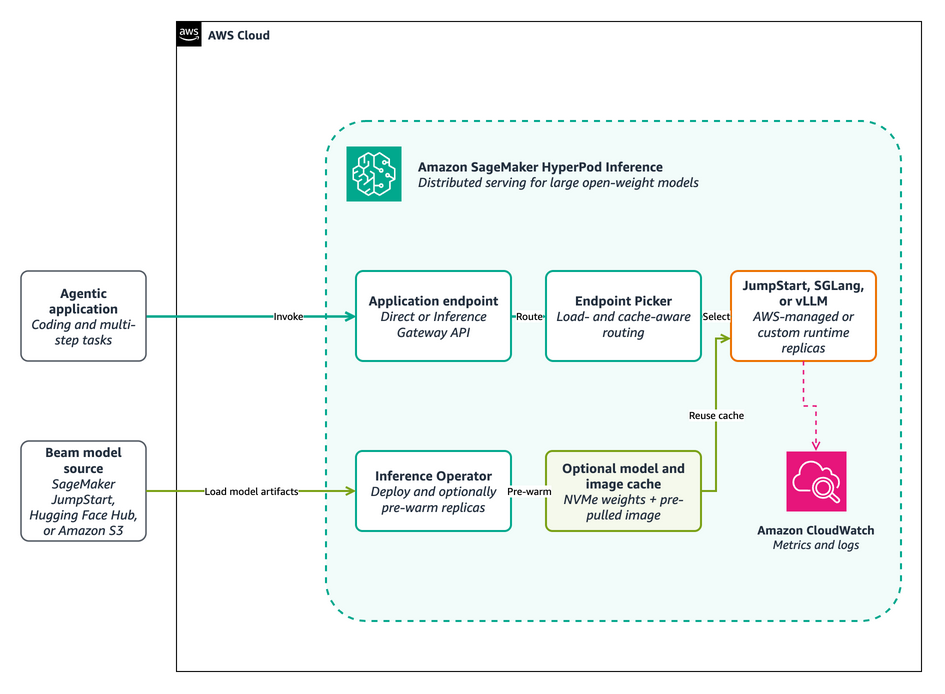
AWSはBeamのデプロイ経路として2つを挙げています。1つはAmazon SageMaker JumpStartのリアルタイムエンドポイントで、Kubernetesを運用せずにマネージドなモデルパッケージ、エンドポイント、呼び出しAPIを利用できる最短の経路です。もう1つはSageMaker HyperPod Inferenceで、Amazon EKSでオーケストレーションされたクラスタ上で、AWS管理のJumpStartコンテナかSGLang・vLLMを選んで動かします。
HyperPod経由では、サービングイメージ、ランタイム引数、量子化、分散実行などを制御できます。HyperPod Inference GatewayはOpenAI互換のインターフェースを提供し、レプリカ間でリクエストを振り分けます。モデルキャッシュを有効にすると、ノードのローカルNVMeに重みとサービングイメージを事前展開できます。管理された階層型KVキャッシュとインテリジェントルーティングにも対応しており、これらは2026年に導入されたAmazon SageMaker Inferenceの機能の一部と説明されています。
必要なGPUと注意点
5010億パラメータのBeamはマルチGPUでのデプロイが前提です。FP8ではNVIDIA H100を搭載したml.p5.48xlarge、またはH200を搭載したml.p5e.48xlargeとml.p5en.48xlarge、NVFP4ではNVIDIA B200を搭載したml.p6-b200.48xlargeが示されています。BF16は重みのメモリ要件が最も大きいため、重みとランタイムのオーバーヘッドを合計したGPUメモリを確保できるマルチノード構成を計画する必要があります。
利用には、選択したデプロイ経路の権限を持つAWSアカウント、IAM・ネットワーク・ストレージのリソース、Beamへのアクセス、モデル利用条件への同意、AWS CLI、Python 3.11以降が必要です。GPUのクォータとキャパシティの確認も求められます。起動時点でJumpStartから利用できるリージョンは米国東部(バージニア北部)と米国東部(オハイオ)の2つで、料金については原文に記載がありません。
| 項目 | JumpStart リアルタイムエンドポイント | HyperPod Inference |
|---|---|---|
| 管理範囲 | AWSがモデルパッケージ・エンドポイント・呼び出しAPIを管理 | クラスタとサービングランタイムを公開し分散実行を制御 |
| ランタイム | AWS管理のJumpStartコンテナ | JumpStartコンテナ、SGLang、vLLMから選択 |
| Kubernetes | 運用が不要 | EKSでのオーケストレーションとkubectl設定が必要 |
| 向くケース | 最短でマネージドなHTTPSエンドポイントを得たい場合 | 分散GPU基盤をKubernetesネイティブに制御したい場合 |
Reflection releases Beam's weights through Hugging Face under the Apache 2.0 license. Beam 1.0 is available in BF16, FP8, and NVFP4 checkpoint variants.
ReflectionはBeamの重みをApache 2.0ライセンスのもと、Hugging Faceを通じて公開しています。Beam 1.0はBF16、FP8、NVFP4のチェックポイント版で利用できます。
今後の見通し
BeamはApache 2.0のオープンウェイトであり、AWS上での具体的なデプロイ手順とサンプルが公開されたことで、自社環境でコーディングエージェントを動かしたい企業が検証を始めやすくなったと考えられます。一方、5010億パラメータのモデルを常時動かすにはH100/H200/B200クラスのマルチGPUが必要で、GPUクォータとキャパシティの確保が導入の最初の関門になりそうです。今後は、日本を含む他リージョンへの展開時期、推論性能やレイテンシの実測値、エージェント型コーディングでの実用性を示す評価結果が明らかになれば、導入可否を判断しやすくなります。
日本の開発者・IT企業にとっての意味
日本のIT企業にとってBeamの意味は、コーディングエージェントの基盤モデルを自社の管理下で動かせる選択肢が増える点にあります。重みがApache 2.0で公開され、SageMaker HyperPod上でSGLangやvLLMを使えば、推論環境をVPC内に閉じ込め、機密性の高いリポジトリを外部APIに送らずに済む構成を取り得ます。ただし5010億パラメータという規模は、H100/H200/B200クラスのGPUを複数ノードで確保する必要があり、小規模なチームが手軽に試せるサイズではありません。まずJumpStartのマネージド経路でPoCを行い、レイテンシとコストを測ってからHyperPodでの自前運用に進む、という段階的な進め方が現実的とみられます。提供が米国東部の2リージョンに限られる点も、日本拠点のシステムに組み込む際の検討材料になります。
気になる点
- 日本リージョンでもBeamは使えますか?
- 起動時点でBeamがAmazon SageMaker JumpStartから利用できるのは、米国東部(バージニア北部)と米国東部(オハイオ)の2リージョンです。日本国内リージョンでの提供時期は公表されていません。HyperPod Inferenceで自前のクラスタにデプロイする経路は示されていますが、原文はJumpStartの提供範囲としてこの2リージョンを挙げているのみで、国内リージョンでの可否は明記されていません。
- 利用コストはどのくらいかかりますか?
- 原文には料金の記載がありません。ただしBeamは5010億パラメータでマルチGPUが前提となり、FP8ではml.p5.48xlargeやH200搭載インスタンス、NVFP4ではB200搭載のml.p6-b200.48xlargeが例示されています。実際の費用はインスタンス種別、レプリカ数、稼働時間で決まるため、構成を決めたうえでAWSの料金表と突き合わせて試算する必要があります。
- 既存のvLLM環境にBeamを持ち込めますか?
- SageMaker HyperPod Inferenceには、SGLangまたはvLLMでBeamをデプロイする経路が用意されており、サービングイメージ、ランタイム引数、量子化、分散実行を制御できます。AWSのサンプルリポジトリにはreflection-beam-sglang.yamlやreflection-beam-vllm.yamlといったマニフェストのテンプレートが含まれています。対応するランタイムのバージョンなど詳細は、サンプルのREADMEが正とされています。
用語解説
- MoE(Mixture-of-Experts)
- 入力に応じて一部のパラメータ(エキスパート)だけを使うモデル構造。総パラメータを大きくしつつ計算量を抑えられる。
- オープンウェイト
- 学習済みのモデルの重みが公開され、自前の環境で実行・改変できる形態。学習データやコードまで公開されるとは限らない。
- Apache 2.0
- 商用利用、改変、再配布を許容する寛容なオープンソースライセンス。利用時の公開義務は限定的。
- KVキャッシュ
- 生成時に計算済みの注意機構のキーとバリューを保持して再計算を省く仕組み。コンテキストが長いほどメモリ消費が増える。
- SGLang / vLLM
- 大規模言語モデルの推論を高速化するオープンソースのサービングランタイム。サービング設定を細かく制御できる。
- SageMaker HyperPod
- 大規模な分散学習・推論向けのAWSマネージドクラスタ基盤。Amazon EKSでオーケストレーションされる。
出典
Introducing Reflection Beam: an open-weight model for agentic coding on AWS
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する