- SageMaker推論エンドポイントでNVIDIA MIGによるGPU分割が利用可能に
- パーティションごとに計算ユニットとメモリを固定割当、分離はハードウェアで強制
- 利用にはinference componentsが前提。単一モデルやサーバーレスは対象外
GPU1基単位という制約の解消
Amazon SageMaker Inferenceが、NVIDIA Multi-Instance GPU(MIG)を使ったGPUパーティショニングに対応したと発表しました。1基の物理GPUを独立した複数のパーティションに分割し、モデルごとに割り当てられるようにする機能です。これまでSageMakerのGPUエンドポイントでは、GPUの最小要求単位が1基全体でした。
各パーティションには、GPUの計算ユニットの固定された割り当てと、専用のメモリブロックが与えられます。分離はハードウェアレベルで強制されるため、ソフトウェア的な共有とは異なり、他のモデルの負荷や障害の影響を受けにくいのが特徴です。AWSは、パーティションごとに別のモデルを配置でき、旧世代・新世代のどちらでもGPU全体ではなく一部を選べる点が変わるポイントだと説明しています。
inference componentsが前提
利用には、SageMakerのinference components(1つのエンドポイントに複数モデルを載せ、それぞれに与える計算資源を指定する仕組み)を使ったエンドポイントであることが前提です。パーティションは、コンポーネントがCPUやメモリを要求するのと同じ場所で、資源として要求します。
単一モデル向けのエンドポイント、サーバーレスエンドポイント、異種インスタンスプールでは利用できません。既存のAPIに新しいオペレーションやリソース種別、IAMアクションは追加されておらず、CreateEndpointConfigの本番バリアントにAcceleratorPartitionLayouts、inference componentにAcceleratorPartitionTypeを指定する2つの任意フィールドが加わる形です。
例として、A100を搭載するml.p4d.24xlargeでmig-4g.20gb、mig-2g.10gb、mig-1g.5gbを組み合わせたレイアウトを指定すると、7つの計算スライスをすべて使い切ります。8基のA100それぞれに3パーティションができ、エンドポイント全体では各種8個ずつ、計24パーティションになります。レイアウトはインスタンス上のすべてのアクセラレータに同じ形で適用されます。
分離がもたらす効果
ハードウェア分離の利点としてAWSは、パーティションごとに専用のメモリ帯域が割り当てられるため、あるモデルのトラフィック急増が別モデルのp99レイテンシに現れないことを挙げています。クラッシュやメモリエラーもそのパーティション内にとどまり、GPU上の全モデルを巻き添えにしません。
また、各モデルが常に読み込まれた状態を保てるため、初回利用時のロード待ちが発生しません。負荷試験の結果が本番でも再現しやすく、GPUコストをモデル・チーム・テナント単位で按分しやすくなるという説明です。
制約と導入時の注意
パーティション数の上限はアクセラレータによって異なり、最大でも7です。MIGはパーティションがアイドル状態のときしかレイアウトを変更できないため、SageMaker AIではエンドポイント作成時にレイアウトを決める必要があります。1つのモデルに複数のGPUが必要な場合は、従来通りデバイス全体を使うことになります。
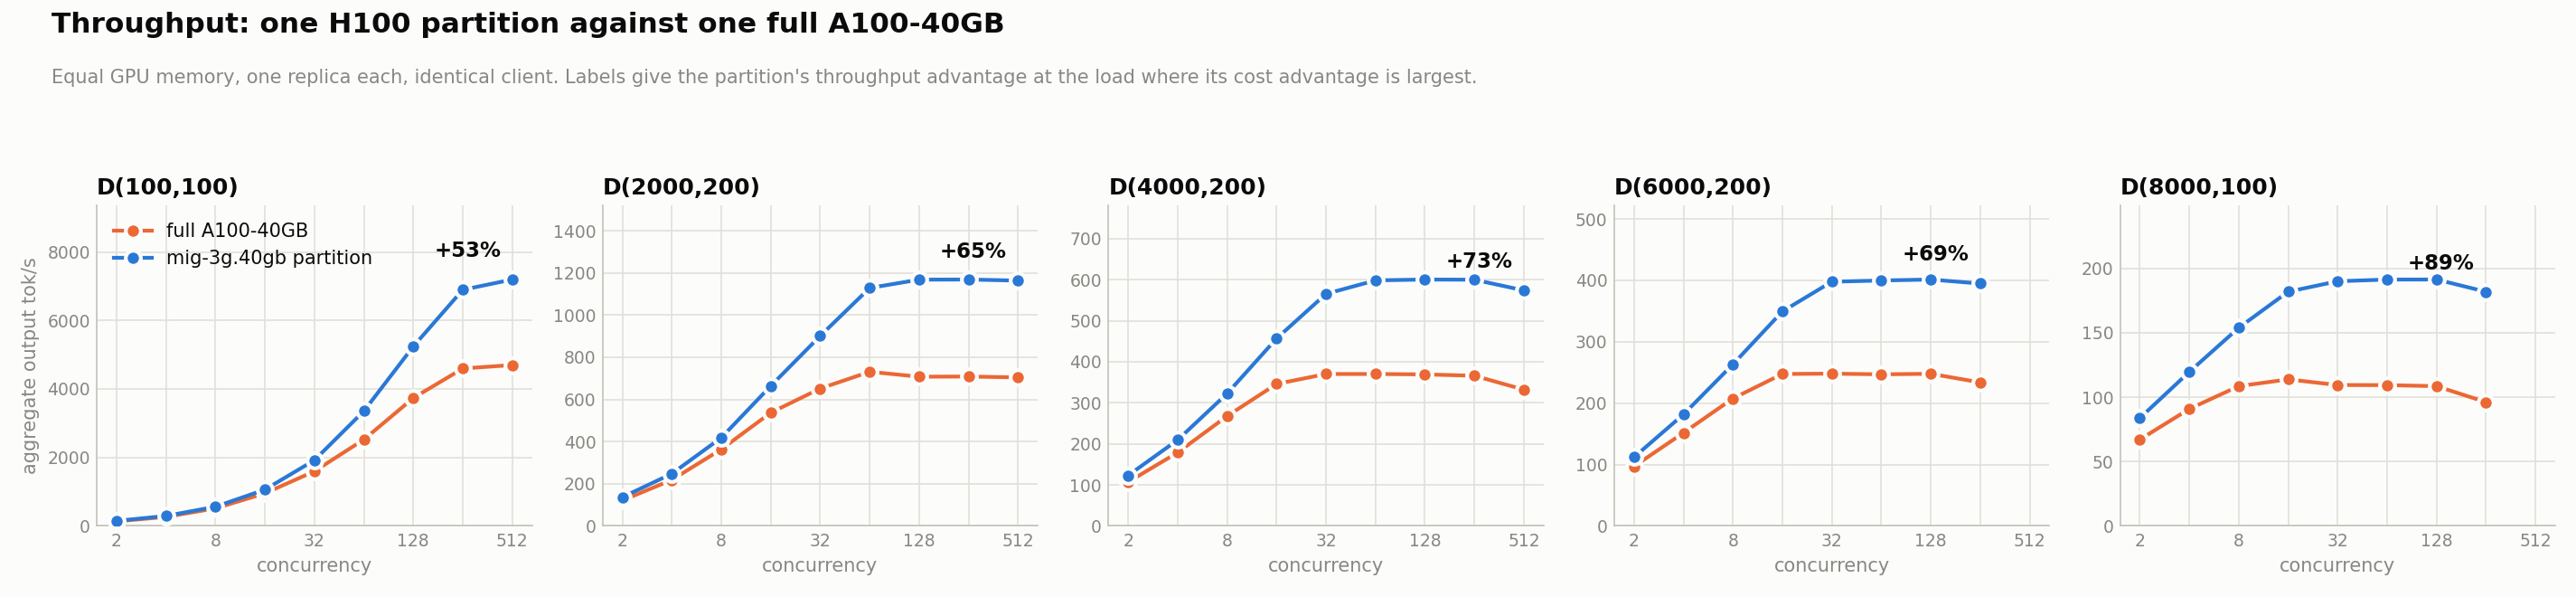
分割の粒度はGPUごとに異なります。A100とH100は計算が7分割・メモリが8分割、G7は半分、G7eは4分の1です。3gプロファイルは計算ユニット7つのうち3つ、メモリ8つのうち4つを使うため、2つ並べるとGPUを埋め尽くし、他のプロファイルを同居させられません。
P4dにはドライバの注意点があります。mig-1g.10gbはR525以降のNVIDIAドライバが必要で、P4dのデフォルトイメージは470.256.02を同梱しています。デフォルトイメージのままでは、プロファイル名を示さないエラーで分割に失敗します。本番バリアントでInferenceAmiVersionにal2023-ami-sagemaker-inference-gpu-4-1を指定すると580系のドライバが使われます。分割処理はプロビジョニング時に行われ、AWSのテストでは所要時間が約17秒増えたと報告されています。
Salesforceと運用負荷の変化
Salesforceは初期からこの取り組みに参加し、要件定義と初期実装の検証を担ったとされています。同社のRichard Chang氏(Software Engineering Architect)は、多くの推論ワークロードがGPU全体を必要としないとし、安全な統合による稼働率向上とコスト削減、予測可能な性能と強固な分離に期待を示しています。同氏によれば、現在は代表的な本番ワークロードでの検証を準備している段階です。
これまで本格的なGPU分割が必要な企業は、自前でKubernetesを運用する道を選ぶことが多く、ドライバのバージョン管理やパーティション設定、デバイスプラグイン、スケジューリングといった運用負荷を負っていました。マネージドのエンドポイントで同じ分離が得られる点が、今回の発表の実務的な意味になります。
| GPU/インスタンス系列 | 分割の粒度 | パーティション上限 |
|---|---|---|
| P4d・P5(A100/H100) | 計算は7分割、メモリは8分割 | 7 |
| G7 | 半分(2分割) | 2 |
| G7e | 4分の1(4分割) | 4 |
MIG would allow us to consolidate workloads safely, significantly improve GPU utilization, reduce inference costs, and maintain predictable performance and strong isolation.
MIGにより、ワークロードを安全に統合し、GPU稼働率を大幅に改善し、推論コストを削減し、予測可能な性能と強固な分離を維持できるようになります。
今後の見通し
現時点では、利用可能なリージョンや料金、プロファイルごとの実測性能は原文で示されていません。次に判断材料になるのは、Salesforceが予定している代表的な本番ワークロードでの検証結果とみられます。あわせて、prefillとデコードで計算資源とメモリの必要量がどう変わるかの指針が公開されれば、ワークロードに合ったレイアウトを選びやすくなるでしょう。既存の推論基盤をマネージドへ移すかどうかは、これらの情報が出そろってから検討するのが妥当と考えられます。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっては、推論基盤のコスト設計が変わる可能性があります。これまでSageMakerで複数の小規模モデルを運用する場合、GPU1基分の料金を払いながら使い切れないことがありました。パーティション単位で配置できれば、モデルごとの資源を実態に近づけられます。ただし利用にはinference componentsへの設計変更が必要で、単一モデルエンドポイントからの単純な移行はできません。既存のKubernetes上でMIGを運用しているチームにとっては、運用負荷と引き換えにマネージドへ寄せる判断材料になる一方、対応リージョンや料金体系は原文で示されておらず確認が必要です。まずはモデルごとの必要メモリとレイテンシ要件を洗い出し、どのプロファイルに収まるかを試算する作業が先に来るとみられます。
気になる点
- 日本のリージョンのSageMakerでも使えますか
- 対応リージョンについての記載は原文にありません。現時点では公表されていないため、利用を検討する場合はAWSのドキュメントやリージョン別の機能一覧で確認する必要があります。
- 既存の単一モデルエンドポイントをそのまま移行できますか
- 単一モデルエンドポイント、サーバーレスエンドポイント、異種インスタンスプールはパーティション分割の対象外と明記されています。利用にはinference componentsで複数モデルを載せる構成へ設計を変える必要があります。
- コストはどう変わりますか
- 料金についての記載は原文にありません。小型・中型モデルがGPU全体を占有せずに済むため利用率は上がると説明されていますが、実際の料金差は公表された情報では判断できません。
用語解説
- MIG(Multi-Instance GPU)
- NVIDIAのGPUを最大7つの独立インスタンスに分割する機能。計算・キャッシュ・メモリ・帯域をハードウェアで分離する。
- inference component
- 1つのSageMakerエンドポイントに複数モデルを載せ、モデルごとにCPU・メモリ・GPUなどの計算資源を指定する仕組み。
- p99レイテンシ
- 応答時間を昇順に並べたとき99%の要求が収まる値。全体の1%だけがこれを超える。裾の遅さを見る指標。
- prefill
- 推論時にプロンプトを読み込んで内部表現を構築する処理段階。計算負荷が高く、計算ユニットを多く消費する。
- プロビジョニング
- エンドポイントを構築して利用可能な状態にするまでの処理。インスタンス起動やコンテナ取得を含む。
出典
SageMaker Inference now supports Multi-Instance GPU to maximize GPU utilization for model endpoints
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する