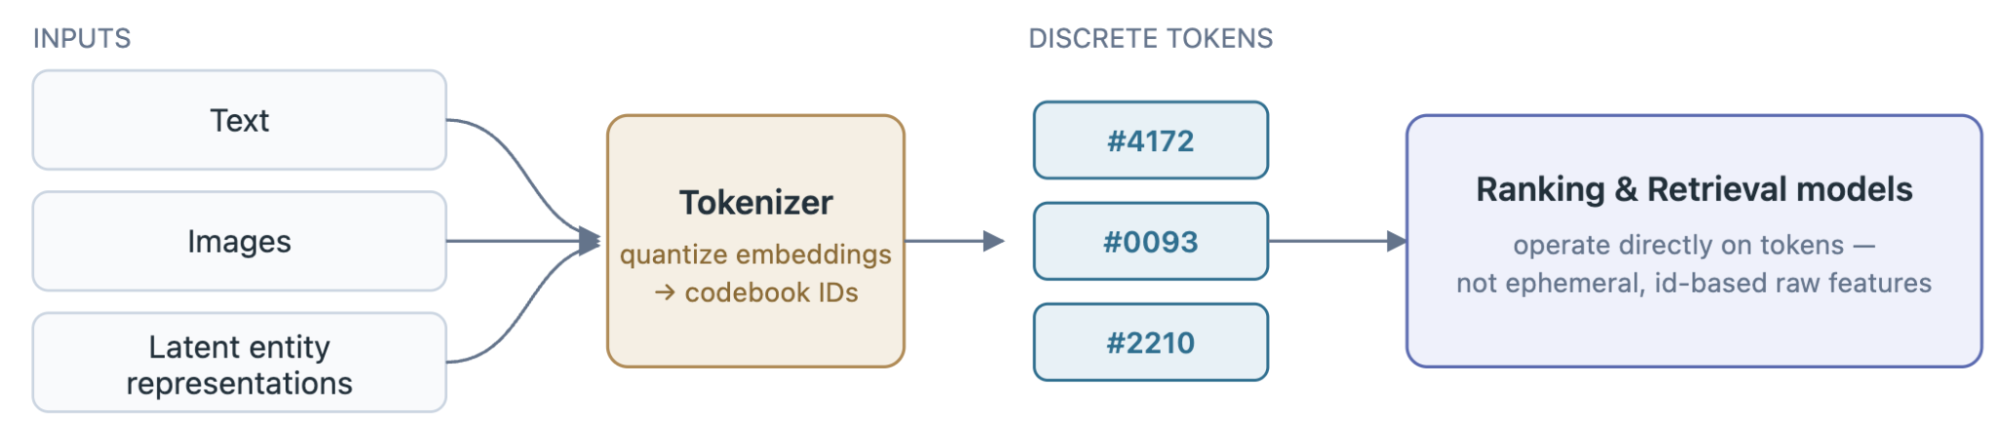
- 項目ごとの専用IDをやめ、安定した意味語彙のトークンで表現する
- GEMとAdaptive Ranking Modelの組み合わせでコンバージョン+0.35%
- 新商品やテール広告のコールドスタートを既知の概念から補完する
何が発表されたのか
Metaは2026年10月19日、エンジニアリングブログで「GenRecs Tokenization」を公表した。これは広告推薦システムにおいて、広告や商品、ページ、ピクセルといった項目をどのようなデータとして表現するかを担う基盤部分の設計である。Metaはこれを、生成型推薦モデル(GenRecs)を成立させるための土台と位置づけている。
GenRecsは、広告候補を一つずつ採点する従来の方式から、LLMのアーキテクチャを使って広告内容とユーザーの選好を同時に推論する方式への転換を指す。あわせてMetaのGenerative Ads Model(GEM)とAdaptive Ranking Modelに組み合わせたところ、面(サーフェス)全体でコンバージョンが+0.35%向上したと報告されている。この数値は2026年2月に計測されたMetaの内部データに基づくと明記されている。
トークン化の仕組み
従来は、世の中のあらゆる概念に対して専用のIDを一つずつ割り当てて保持していた。GenRecs Tokenizationではこれを使わず、LLMが少数の語彙を組み合わせて任意の概念を表すのと同じ考え方で、各項目を意味トークンの集合として表現する。トークンは「その項目が何であるか」を記述するため、まだ反応データが無い項目でも、よく知っている項目と関連付けられる。たとえば新発売の「トレイルシューズ」は、ゼロから表現を作るのではなく、そのカテゴリについて既に学習済みの内容を引き継ぐという。
処理は3段階のパイプラインで構成される。まず各項目を意味的な埋め込み空間にエンコードし、次にその埋め込みを独立した部分空間へ分解し、最後に各部分空間をコードブックのエントリに割り当てる量子化を行う。広告表現の多くでは、学習済みエンコーダ、残差分解、学習済みベクトルコードブック、トークンのパラメータ化を組み合わせた「prefix n-grams」が用いられる。項目や特徴の意味に応じて、これらの段階の組み合わせを変える必要があるとしている。
品質指標とランキング精度
Metaは、下流のランキング改善とは別に、トークナイザ自体の品質を測る指標を挙げている。共有のコードを持つ項目が同じカテゴリに寄る「クラスタ純度」、項目が少数のセマンティックIDに集中せず分散している「分布バランス」、より多くのコードが少なくとも1つの項目を保持している「コードブック利用率」の3つである。
試験した8つのトークナイザのバージョンでは、これらの指標と下流のランキング予測精度の間に強い相関が見られた。指標で良いスコアを出したバージョンは、広告モデルのCTR予測精度も良かったという。Metaはこの性質を利用し、モデル全体の学習サイクルを待たずにトークナイザを改善できるとしている。
位置づけと留意点
記事では、トークン化によってテール広告の予測が改善すると、その学習データが改善し、さらに全広告の予測が良くなるという自己強化的なループが説明されている。また、共有のLLMエンコーダを使ったtwo-tower構成で、学習データをわずかでクラシックなtwo-towerに匹敵する検索品質が得られたとしている。
一方で、+0.35%という数値はMeta内部のデータに基づくもので、比較対象や母数の詳細は示されていない。トークナイザやコードブックの実装が公開されているかどうかにも触れられていない。完全に言語化したトークン化は広告規模では実用的でない長さのコンテキストウィンドウを必要とするため、圧縮した言語化トークンとセマンティックIDを組み合わせる方向を検討中だとしている。
| 観点 | 従来のIDベース表現 | GenRecs Tokenization |
|---|---|---|
| 項目の表現 | 項目ごとに専用のIDを保持 | 安定した意味語彙のトークン集合で表現 |
| 未見の項目 | 過去の反応履歴が無く信号が乏しい | 共有する概念を通じて既知の項目と関連付け |
| 語彙の性質 | 一時的(ephemeral)なID | 安定した意味表現 |
Instead of maintaining a dedicated ID for every concept in the world, language models compose a small vocabulary of semantic tokens to represent any concept.
世の中のあらゆる概念に対して専用のIDを保持する代わりに、言語モデルは少数の意味トークンの語彙を組み合わせて任意の概念を表現する。
今後の見通し
MetaはGenRecs Tokenizationを3つの方向に進めるとしている。テール広告在庫でのコールドスタート汎化を深め、トークナイザ品質を第一級の目的関数として扱い、LLMネイティブなアーキテクチャを効率よく配信することである。さらに長期的には、テキスト・画像・音声・動画をまたぐ共有トークン空間の可能性を探るとしている。判断材料になるのは、+0.35%の計測条件(比較対象や母数)が示されるか、コールドスタート改善の定量的な結果が公開されるか、言語化トークンとセマンティックIDの併用でレイテンシがどこまで抑えられるか、とみられる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっての意味は、レコメンドの設計思想が「IDと埋め込み」から「意味トークン」へ移りつつある点にあると考えられます。商品数が多く新商品の入れ替わりが激しいECや広告配信では、反応履歴の無い項目の扱いが長年の課題でした。意味トークンで項目を表現すれば、カテゴリや内容が近い既知の項目から知識を引き継げるため、コールドスタート対策の選択肢が増えます。また、クラスタ純度やコードブック利用率といった指標でトークナイザ単体を評価できるという指摘は、モデル全体の再学習を待たずに改善を回す実務的なヒントになります。ただしMetaの閉じた実装であり、導入には自前のコードブック学習と検証が必要です。
気になる点
- この+0.35%という数字はどの程度の意味を持つのか
- Metaの内部データに基づく、面全体でのコンバージョンのリフトであると説明されています。2026年2月に計測されたとありますが、比較対象の条件や母数、統計的な有意性については原文に記載がなく、現時点では効果の大きさを外部から評価できません。
- 自社の推薦システムに同じ考え方を取り入れられるか
- 考え方自体は参考になりますが、原文には実装コードやライブラリの公開に関する記述はありません。3段階のパイプライン(エンコード、部分空間への分解、コードブックへの量子化)と、コードブック品質を改善する手法(diversity loss、dead code resets、contrastive objectives)が要点として挙げられています。
- 日本企業の広告配信でも効果は期待できるか
- 示されている効果はMetaの広告推薦システム上で計測されたもので、他の環境で同様の改善が得られるかは分かりません。特にコールドスタートやテール広告の比率が高いほど効果が出やすいというのがMetaの説明ですが、これはMetaの在庫構成に基づく主張です。
用語解説
- GenRecs
- Generative Recommendersの略。広告候補を個別に採点するのではなく、LLMのアーキテクチャで内容と選好を推論するMetaの推薦手法。
- トークナイゼーション
- 対象を小さな記号(トークン)の列に変換する処理。本記事では広告や商品を意味トークンの集合に変換することを指す。
- 埋め込み(embedding)
- テキストや画像などの内容を、意味的な近さが距離で表される数値ベクトルに変換したもの。
- コードブック
- 量子化に使う離散的なコードの集合。各項目の埋め込みをいずれかのコードに対応付ける。利用率が高いほど語彙が細かく表現できる。
- コールドスタート
- 新しい項目や履歴の少ない項目について、反応データが乏しいために予測精度が下がる問題。
- two-tower
- ユーザー側と項目側を別々のエンコーダで表現し、その近さで検索する推薦・検索の定番アーキテクチャ。
出典
GenRecs Tokenization: Transforming Ads Recommendation at Meta with Stable Model Vocabulary
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する