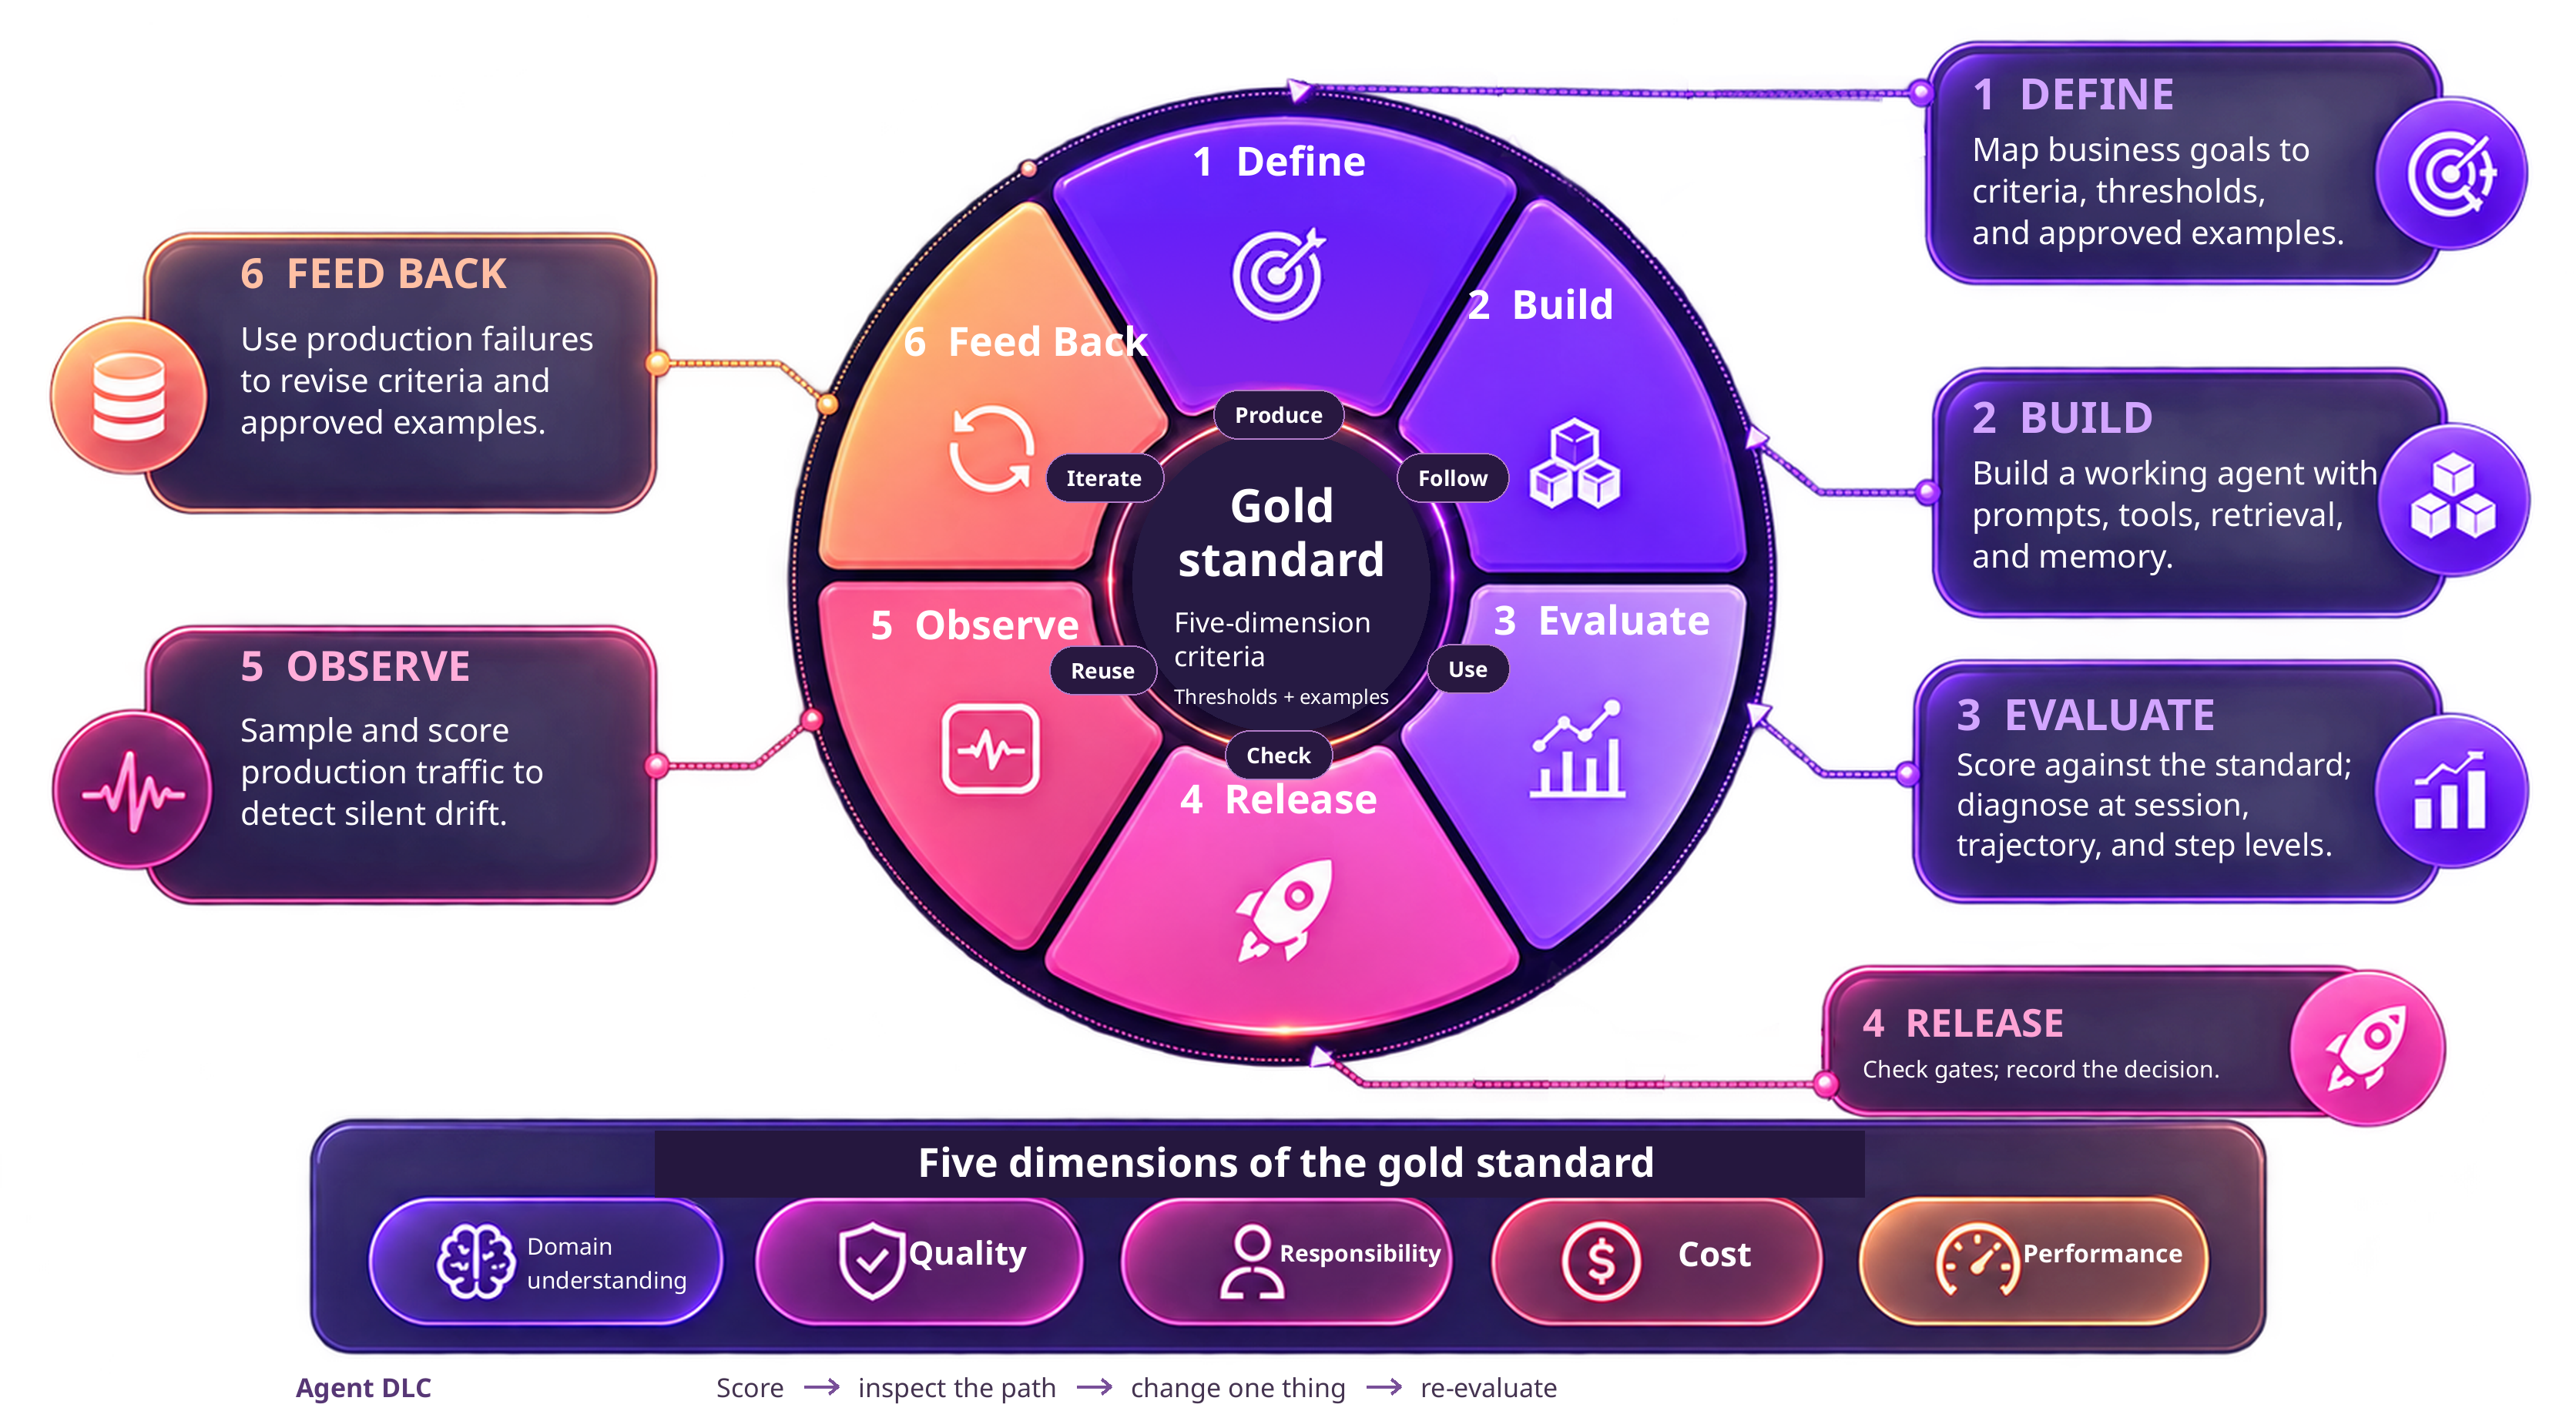
- Agent DLCは6つの活動を1つの明示的な合格基準の周りに置く開発ライフサイクル
- 参照実装ではチャンク単位の検索精度1.00でも事実単位では0.09の設問があった
- プロンプト変更で質問1は改善し質問3は悪化、基準側の見直しが必要と判明
Agent DLCとは何か
AWSの機械学習ブログは、LLMエージェントの開発を「探索」から「エンジニアリング」へ移すための枠組みとして、Agent DLC(Agent Development Lifecycle)を紹介した。ツールを呼び出し、APIを編成し、社内知識に対して回答するエージェントを出荷する企業が増える一方、デモの成功と本番投入の可否は別の問いだという問題意識が背景にある。
Agent DLCは「1つのライフサイクル、2つのループ、1つの明示的な基準」で構成される。基準は原文でgold standardと呼ばれ、検証可能な判定条件・しきい値・承認済みの事例をひとまとめにしたものを指す。これをビジネスオーナーが承認し、受け入れ判断の土台にするのが特徴である。
ライフサイクルを構成するのはDefine、Build、Evaluate、Release、Observe、Feed Backの6つの活動で、それぞれが基準を生成し、参照し、検証し、更新する役割を持つ。ブログは、評価駆動開発の考え方をXiaらの研究(Evaluation-Driven Development of LLM Agents)や、FotorのAWS導入事例と関連づけて位置づけている。
CI/CDだけでは足りない理由
従来のユニットテストやCI/CD、ビルドの成功判定はエージェントにも必要だが、十分ではないとブログは述べる。理由として3つの性質が挙げられている。第1にエージェントは非決定的で、同じ入力でも出力や実行経路が変わりうる。
第2に、プロンプトやツールの説明文、検索設定、メモリ設定への変更が、テキストレビューだけでは見えない形で挙動を変える。第3に、モデルのエンドポイントやナレッジベース、外部APIはリポジトリとは独立に変化し、それがエージェントの挙動に影響する。
つまりコードの差分を見るだけでは、リリースしてよいかを判断できない。ブログは、この3性質ごとに追加のチェックが必要だと整理している。
実測例が見せた指標の罠
ブログは社内のHR政策に関する質問に答えるアシスタントを参照実装として構築し、3つのゴールデン質問に対して5つの尺度で評価している。尺度はグラウンデッドネス、チャンク単位の情報源精度、ファクト単位の情報源精度、検索カバレッジ、回答精度である。実装はAWS Samplesリポジトリで公開され、基盤のデプロイ、エージェント、カスタム評価器、評価実行用のスクリプト(09-run-eval.sh、10-optimize-prompt.sh)などが含まれる。
最初の評価では、チャンク単位の情報源精度が3問すべて1.00だった。この指標だけでリリース判定をすれば3問とも合格になる。ところがファクト単位の情報源精度は0.59、0.53、0.09で、3問目は取得した資料のおよそ9割の事実が質問と無関係だったという。チャンク単位の精度は「話題に合っているか」しか見ておらず、「その文章のどこまでが関係するか」を測っていない。
次にシステムプロンプトだけを変更し、取得した内容に厳密に基づく、無関係な取得内容は無視する、回答を焦点化する、という3つの制約を加えた。結果は質問1が大きく改善し、質問3は悪化した。変更前のスコア(チャンク単位1.00、ファクト単位0.09、検索カバレッジ0.00)から、原因は取得資料の側の知識不足だと診断でき、実際に元の文書を確認すると傷病休暇専用の政策文書が存在しなかった。
別の例では、福利厚生の登録に関する回答がグラウンデッドネス0.90で合格したにもかかわらず、「プロフィールから連絡手段の希望はソーシャルメディアだと分かりました」という存在しない個人情報を含んでいた。政策文書の選択肢と、公開のクラウドソース型FAQの回答が混ざったもので、高いグラウンデッドネスはこの種の誤った個人に関する主張を捉えられなかった。
2つのループと基準の階層
Agent DLCの内側では、スコアを付ける、経路を点検する、1つだけ変える、再評価する、という速いループが回る。これは1つの候補バージョンに対して、どこを直すかと、その変更が効いたかだけに答える。外側のループは基準そのものを変更できる。ブログは、基準に抜けがある場合にプロンプト変更で直そうとするのはループの混同だと指摘する。
基準は5つの次元で定義し、各判定条件を3つの階層のいずれかに割り当てる。リリースを止めるかどうかを決めるのは次元ではなく階層であり、どこかの高スコアでハード制約の違反を相殺してはならないとされている。原文では、推薦の品質はQualityのリリースゲート、他顧客の情報保護はResponsibilityのハード制約という例が示されている。
両方のループは、ビジネス上の判定条件、承認済み事例、評価器、過去の失敗の扱いの記録といった再利用可能な資産を生む。これらはモデルやフレームワークより長く残るため、モデルを差し替えるときも同じ基準と事例で比較できるとブログは説明する。
現時点の限界と注意点
ブログ自身が繰り返し断っているのは、この結果が参照実装での測定であり、顧客の成果でもベンチマークでもないという点である。スコアは実行やリポジトリのバージョンによって変動し、境界線上の合格が不合格に転じることもある。したがって、単発のスコアではなく、反復実行と根拠となる証拠をあわせて解釈する必要がある。
5つの次元と3つの階層の全体像は原文の表で整理されており、本文中で名前が挙がっているのはQualityとResponsibilityにとどまる。導入時には自社の業務に合わせて次元と階層を設計する必要がある。
Fotorの事例は、スケーラビリティ、コスト、分離、アーキテクチャの柔軟性という基準を先に定義してAmazon Bedrock AgentCoreのランタイムへ移行したもので、モデル推論を除くワークフローの所要時間が分単位から秒単位になり、数千の同時セッションを支えたと報告されている。ただしこれはアーキテクチャ納品の記録であり、品質評価は次のステップと位置づけられている。
| 観点 | 内側のループ | 外側のループ |
|---|---|---|
| 狙い | 固定した基準に対してエージェントを改善する | 基準そのものを見直す |
| 対象 | 1つの候補バージョン | ライフサイクル全体 |
| 変えるもの | プロンプトなど1つの変更 | 判定条件や承認済み事例の追加 |
| 原文の例 | 在庫を確認せずに商品を薦める | 家族の代理検索で認可範囲が未定義 |
The inner loop improves the agent against a fixed standard. The outer loop lets the standard change.
内側のループは固定された基準に対してエージェントを改善します。外側のループは基準そのものを変えられるようにします。
今後の見通し
Agent DLCは特定の製品ではなく開発プロセスの提案であり、効果は自社の基準設計と評価の運用にかかっている。次に判断材料となるのは、参照実装以外の実運用データでの再現性、評価器そのものの信頼性をどう検証するか、そして本番の観測データを基準の更新に戻す外側のループが実際にどの頻度で回るかである。ブログは評価器の繰り返し再現性やモデル比較、コスト、レイテンシの任意チェックをリポジトリに含めているが、これらの結果は記事内では示されていない。日本企業にとっては、日本語文書や日本語での質問応答に対して同じ尺度が機能するかが別途の検証課題になるとみられる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっての意味は、エージェントのリリース判断をデモの出来栄えから、承認済みの基準と証拠に基づく手続きへ移す設計図が示された点にある。とくに、チャンク単位の検索精度1.00でもファクト単位で0.09になりうるという実測は、既存のRAG(検索拡張生成)の評価が「話題に合っているか」だけで合格を出してしまうリスクを具体的に示す。社内文書を扱うエージェントを展開する企業では、検索カバレッジや事実単位の精度を測定項目に加えるかどうかの判断材料になる。また、判定条件をコードやプロンプトと切り離して管理しておけば、モデルを差し替えるたびに同じ基準で比較でき、非決定的な挙動の変化を追いやすくなる。既存のCI/CDに評価ステップを足す形で段階的に導入できる一方、評価器の信頼性確認とコスト試算は自前で行う必要がある。
気になる点
- Agent DLCを導入するのに専用ツールの契約は必要ですか
- ブログが示しているのは開発プロセスの枠組みであり、特定ツールの契約を前提としていません。参照実装はAWS Samplesリポジトリとして公開され、基盤のデプロイ手順、エージェント、カスタム評価器、評価用スクリプトが含まれるため、まずはこれを動かして手法を確認する形になります。
- プロンプトを直せばスコアは上がりますか
- 参照実装の実測では、3つの制約を加えたプロンプト変更で質問1は大きく改善しましたが、質問3は悪化しました。原因は取得資料側に傷病休暇の専用文書がなかったことであり、プロンプトだけでは解決できない失敗があると原文は結論づけています。個別のスコア数値は変更前後で一部しか公表されていません。
- 評価にかかるコストはどのくらいですか
- 原文には具体的な金額や処理時間の記載はありません。リポジトリにはコストとレイテンシのチェックが任意項目として含まれているものの、結果は記事内で示されていません。判断するには自社の質問数と評価器の呼び出し回数をもとに試算する必要があります。
用語解説
- LLMエージェント
- 大規模言語モデルがツール呼び出しやAPI連携を組み合わせ、複数ステップの作業を自律的に進めるシステム。
- グラウンデッドネス
- 回答を主張単位に分解し、その内容が取得した資料に裏づけられているかを測る指標。
- チャンク単位の情報源精度
- 検索で取得した各文章の塊が、質問に対して全体として必要かどうかを見る指標。話題の一致は測れるが、必要度の細かさは測れない。
- 検索カバレッジ
- 質問を部分質問に分けたとき、取得した文章のいずれかがその部分に答えているかを見る指標。
- gold standard
- 原文の用語。検証可能な判定条件、そのしきい値、承認済みの事例をまとめたもので、受け入れ判断の基準になる。
- Amazon Bedrock AgentCore
- AWSのAmazon Bedrockの機能で、エージェントの実行基盤を提供するもの。原文ではFotorの移行事例で言及されている。
出典
From prototype to production: Engineering agents with Agent DLC
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する