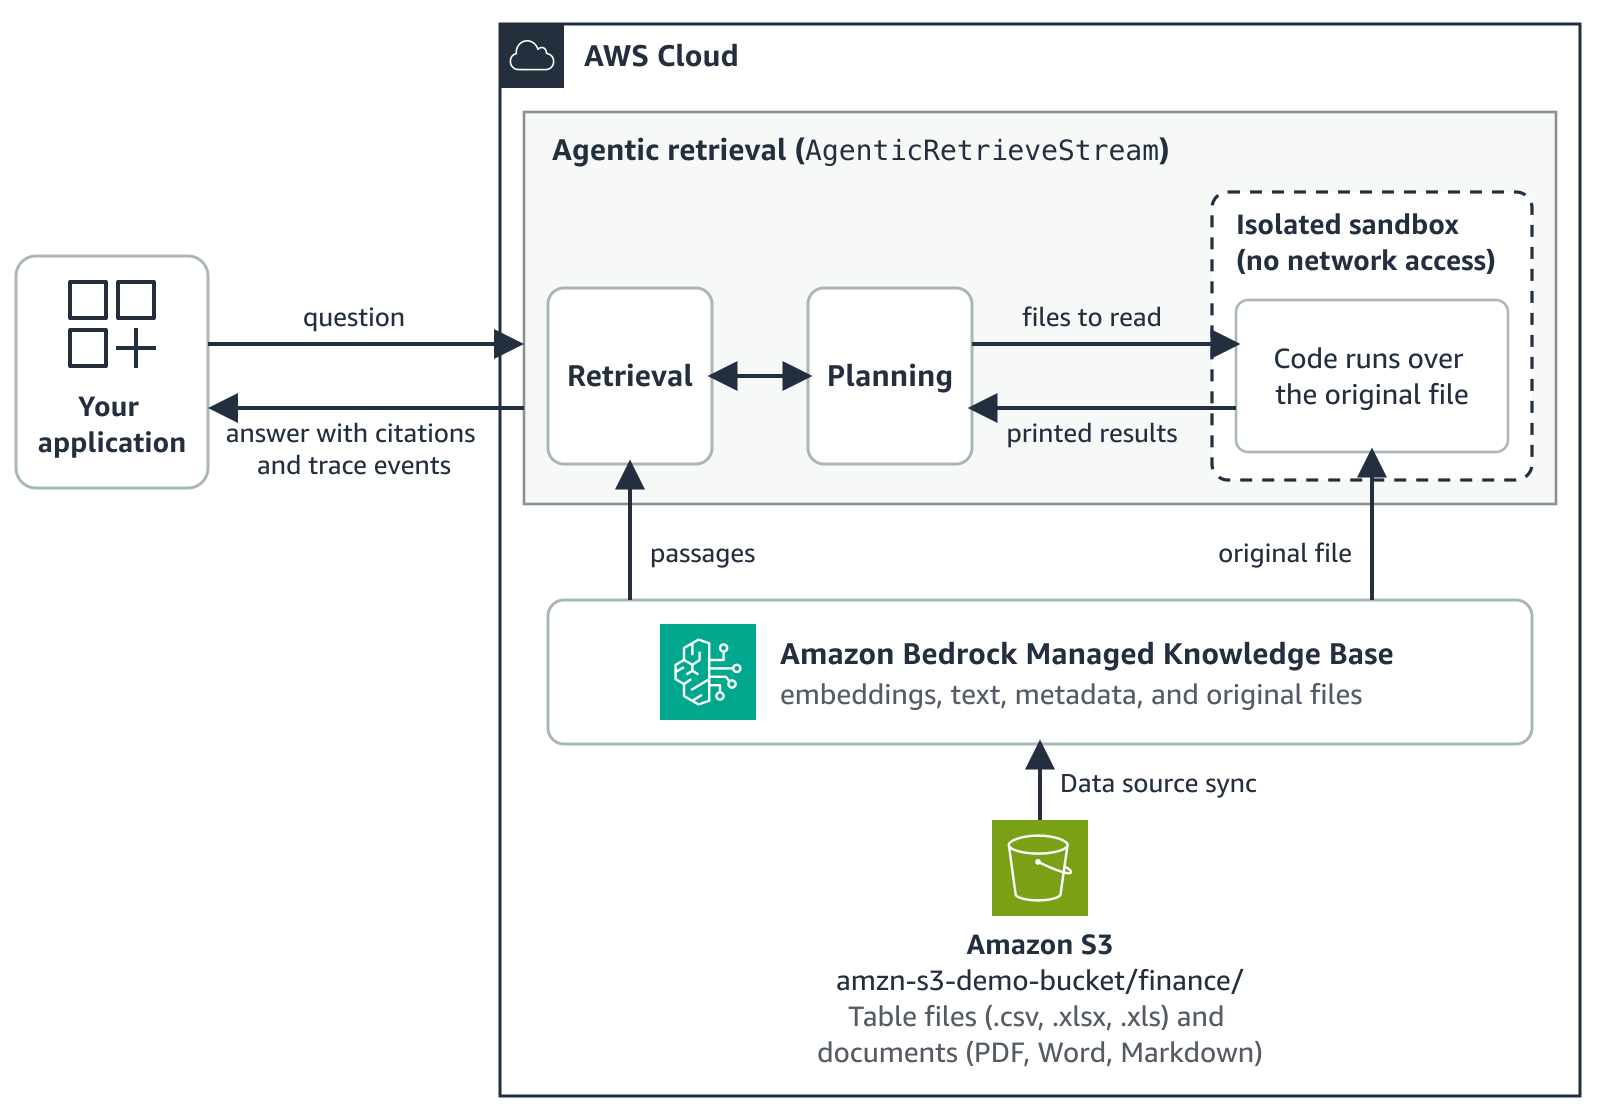
- CSV・XLSX・XLSの表への計算・照合の質問に、既存のAgenticRetrieveStreamで回答できる
- コードはネットワーク非接続のサンドボックスで元ファイル全体に対して実行され、回答に引用とトレースが付く
- 有効化の設定は不要だが、表データを使う回答はエージェントのターンが増える分だけ遅くなる
表データ検索の追加
Amazon Bedrock Managed Knowledge Baseが、表データを対象にした「tabular search」に対応しました。CSV、XLSX、XLSファイルの中身が必要な質問に対して、エージェント型検索(agentic retrieval)を通じて回答を返します。複数の表やシートの該当する行を横断して値の照合や計算を行い、その結果を関連ドキュメントから得た事実と組み合わせる仕組みです。
記事では四半期決算の財務チームを例に挙げています。「どの部門が変動理由のコメントを書く必要があるか」という問いの答えは、単一のファイルには存在しません。変動ポリシーが定める閾値、四半期決算メモに書かれた予算改訂、そして損益(P&L)ワークブックの全部門に対する計算の3つが組み合わさって初めて決まります。
こうした状況は財務部門に限りません。SharePointのサイトにワークブックとポリシーが並んで置かれていたり、S3バケットにCSVのエクスポートとPDFが同じ場所に保存されていたりするのは一般的です。tabular searchは、ドキュメント検索で使っているものと同じAgenticRetrieveStreamリクエストで、こうしたファイル群にまたがる質問に答えます。
サンドボックスでコード実行
エージェント型検索では、エージェントが検索結果を使ってどの文書が重要かを判断し、回答を組み立てます。tabular searchはその流れの一部として組み込まれており、記事によれば有効化するための設定はありません。
処理はRetrieve、Plan、Stage、Compute、Return、Answerという段階をたどります。まず検索で表ファイル由来のパッセージを含む結果が返り、次にエージェントが質問と表の構造からコードを実行すべきか判断します。実行する場合は元のファイルをネットワークアクセスのない隔離されたサンドボックスにコピーし、モデルが書いたコードを表全体またはシート全体に対して走らせます。
エージェントが受け取るのはコードが出力した内容だけです。たとえば合計値や条件に一致した行などが返り、エージェントはそれを検索で得たパッセージと合わせて回答を作ります。回答には引用が付き、トレースを見ればコードがどのワークブックを読んだかを確認できます。
表がRAGで扱いにくい理由
RAGは質問に近いパッセージを決まった件数だけ返す仕組みで、文章の検索には適しています。しかし表をパッセージに分割すると、表の形に応じて情報が失われます。数千行ある長い表では多数のパッセージに分かれ、検索はそのごく一部しか返さないため、合計や比較、閾値のチェックが不完全になり得ます。
数百列ある広い表では、1行が1つのパッセージや検索モデルの入力より大きくなることがあります。その場合、後ろの列の値はマッチしにくくなります。また広い表から切り出した長いパッセージは無関係な質問にも一致しやすく、本当に関連するパッセージを結果から押し出してしまう可能性があります。
質問と表の対応付けも難しい論点です。質問は「controllable spend」のような業務用語で書かれますが、表にはコストセンターのコードや勘定科目名、数値が入っています。数値に意味を与えるルールは別のポリシー文書にあることが多く、下書き版と確定版のワークブックは検索から見るとほぼ同じです。tabular searchはこの問題を役割の分割で扱い、検索は正しい表ファイルから1つのパッセージを返せばよく、その後のコードが表全体を読みます。ただし検索がまずファイルを見つける必要があるため、質問にファイル名を含めると助けになるとしています。
BIツールとの使い分け
tabular searchが向いているのは、取得した表ファイルに対する計算や値の照合が必要な質問です。コードを実行する分だけエージェントのターンが少なくとも1回増えるため、表データを使う回答はテキストだけで完結する回答より時間がかかります。
ガバナンスされた指標、定期的に更新するダッシュボード、ウェアハウス規模の結合、レポートの統制といった用途は、引き続きBIツールの領域だと記事は位置づけています。tabular searchはドキュメントの隣に置かれた表ファイルを対象にした機能で、スキーマを定義する必要はありません。
ファイルをナレッジベースに取り込むコネクタは問いません。Amazon S3、Microsoft SharePoint、Atlassian Confluenceなど、どのコネクタを使っていても同じように動作すると説明されています。なお、Retrieve APIは従来どおりパッセージを返すだけで、コードは実行しません。
試すための前提条件
試すには、IAMロールやS3バケット、ナレッジベースを作成する権限が必要です。AgenticRetrieveStreamを呼ぶ主体には、bedrock:GetDocumentContentを含むエージェント型検索の権限が要ります。エージェントは呼び出し元の資格情報で元の表ファイルを読むため、権限設計ではこの点を意識する必要があります。
ナレッジベースはMANAGEDタイプで作成し、データソースはMANAGED_KNOWLEDGE_BASE_CONNECTORを使います。記事ではS3のfinance/プレフィックスにファイルを置き、最大ファイルサイズ(maxFileSizeInMegaBytes)を保有する最も大きいファイルより上に設定する手順が示されています。サンプルはGitHubのsample-managed-knowledge-base-patternsリポジトリのtabular-searchフォルダにあり、AWS CDKアプリとPythonスクリプトが含まれます。
検証にはPython 3.10以降とBoto3 1.43.123以降を使います。料金はAmazon Bedrockの料金ページを参照するよう案内されていますが、具体的な金額は本文に示されていません。ファイルタイプの確認など、同期以降の詳しい手順については本記事では触れられていません。
| 項目 | 通常の検索 | 表データ検索 |
|---|---|---|
| 表の扱い | パッセージに分割し、一致した数件だけ返す | コードで表全体を読む |
| 計算の実行 | 行わない | サンドボックスでコードを実行 |
| 回答の根拠 | 取得したパッセージ | 計算結果と関連文書、引用付き |
| 向く用途 | 文章中心の質問 | 表の計算や照合が必要な質問 |
It runs code over the original file in an isolated sandbox, so the answer uses the whole table instead of only the rows that retrieval returns.
元のファイルに対して隔離されたサンドボックスでコードを実行するため、回答は検索が返した行だけでなく表全体を使います。
今後の見通し
tabular searchは既存のAgenticRetrieveStreamに組み込まれる形で提供されるため、利用者側の実装変更は比較的小さいとみられます。一方、対応リージョンや料金の詳細、表の種類や規模による精度の違いは本文だけでは判断できません。次に確認したいのは、対応リージョンの一覧、表データを使った場合の応答時間とコスト、そして長い表や広い表でどの程度正確に集計できるかという実測値です。これらが公開されれば、BIツールと使い分ける境界もより明確になると考えられます。
日本の開発者・IT企業にとっての意味
日本のIT企業では、社内の問い合わせ対応や経理・購買の照会業務で、規程のPDFと表計算ファイルが別々の場所に置かれていることが珍しくありません。tabular searchは、そうした表と文書をまたぐ質問に対して、既存のAgenticRetrieveStreamの呼び出しを変えずに回答できる点が実務上の意味を持ちます。新しいAPIやスキーマ定義を追加せずに済むため、すでにBedrockのナレッジベースを運用しているチームは影響範囲を見積もりやすいでしょう。ただし、表データを使う回答はエージェントのターンが増えて遅くなるため、対話的なUIでは待ち時間の設計が必要になります。また、bedrock:GetDocumentContentを含む権限設計と、ガバナンスされた数値はBI側に残すという役割分担を事前に決めておくことが重要です。
気になる点
- 既存のナレッジベースで追加の設定は必要ですか。
- 記事によれば有効化する設定はなく、ドキュメント検索で使っているものと同じAgenticRetrieveStreamリクエストで動作します。ただし、初回の同期後にファイルタイプが正しく割り当てられているかを確認する必要があるとされています。
- 日本リージョンでも利用できますか。
- 本文には対応リージョンの一覧は記載されておらず、tabular searchが利用可能なAWSリージョンで使うよう案内されているのみです。具体的なリージョンはSupported AWS Regionsのページで確認する必要があり、日本リージョンに対応しているかは本文からは判断できません。
- BIツールの代わりになりますか。
- 記事は、ガバナンスされた指標、定期的なダッシュボード、ウェアハウス規模の結合、レポート統制は引き続きBIツールの領域だとしています。tabular searchは、ドキュメントの隣に置かれた表ファイルに対する計算や照合の質問に向けた機能という位置づけです。
用語解説
- RAG
- Retrieval Augmented Generation。外部の文書やデータを検索し、その内容を根拠に生成AIが回答する手法。
- エージェント型検索
- 検索と推論を組み合わせ、どの文書を使うかをエージェントが判断しながら回答を組み立てる検索方式。
- ナレッジベース
- 文書や表ファイルを取り込み、検索できる形で保持するAmazon Bedrockの機能。
- サンドボックス
- 外部ネットワークに接続しない隔離された実行環境。ここでモデルが書いたコードを実行する。
- スキーマ
- 表の列名やデータ型など、データ構造の定義。
出典
Get answers from tables with tabular search in Amazon Bedrock Managed Knowledge Base
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する