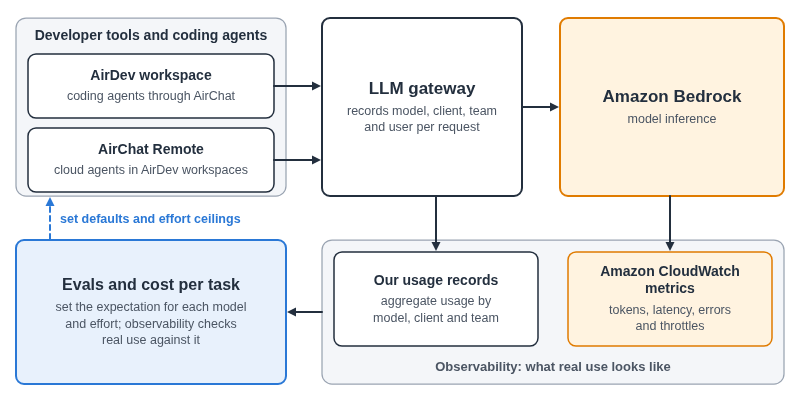
- Airbnbは社内ツールAirChatのコーディングエージェントを、LLMゲートウェイ経由でAmazon Bedrock上で運用している
- モデル選定は1リクエスト単価ではなく、タスク完了までの全トークン費用「タスクあたりコスト」で行う
- 本番ではCloudWatchのレイテンシ・スロットリング・トークン指標を突き合わせ、遅延や費用の変化を追跡する
何が示されたのか
AWSのブログで、AirbnbがコーディングエージェントをAmazon Bedrock上でどう評価し、運用しているかが公開された。Airbnb社内では数千人のエンジニアとエンジニア周辺の職種が、週次でAirChatというコーディングエージェント用ツールを使っている。エージェントのモデルリクエストは社内のLLMゲートウェイを経由してBedrockに届き、コード・プロンプト・応答はAWS内で処理される。
背景にあるのはモデル更新の速さだ。原文によれば約5週間で8つの新モデルが登場し、10月中旬の時点でエンジニアがコーディングエージェント経由で送ったリクエストの約3分の2が新しいモデルに向いていた。モデルが変わるたびに出力トークン数・コスト・レイテンシ・キャパシティが同時に変わりうる。リリース時に公開されるベンチマークのグラフだけでは自社の業務をどう処理するか分からない、というのがAirbnbの問題意識である。
タスクあたりコストとは
Airbnbはロールアウト前に自社タスクでeval(評価)を実行し、モデルごとにスコアとタスクあたりコストを測る。タスクあたりコストは、エージェントが1つのタスクを終えるまでに使った全トークンのリスト価格ベースの費用と定義されている。コーディングエージェントは1タスクを終えるのに多数のリクエストを出し、そのたびに文脈を読み直すため、リクエスト単価ではなくタスク全体で値付けする。
Bedrockはリクエストごとに、未キャッシュ入力・キャッシュ読み取り・キャッシュ書き込み・出力の4種類のトークン数を報告する。Airbnbはこの4つすべてをeval実行時点の公開リスト価格で計算し、タスク内のリクエスト分を合算する。低スコアだった試行も平均に含めるため、数値は実態に近い形になる。
reasoning effort(応答前にどれだけ推論させるかを決める設定)はスコアとコストの両方を動かす。あるモデルでは低から高へ上げるとスコアが0.8ポイント上がった一方、タスクあたりコストは2.5倍になった。Airbnbはこの結果を使い、エンジニアが別途指定しない限り使う「デフォルト」と、ゲートウェイが強制する「effort上限」を決めている。
評価を回す仕組み
新モデルが出た日の午後に、エージェントへの1リクエストで評価キャンペーンが始まる。7つのタスクスイートに数百のタスクを分散させ、複数のクラウドワークスペースで実行し、grader(採点プログラムまたはモデル)が採点した時点で結果が出る。最初の結果は数時間で届き、翌朝には全スイートのスコアとタスクあたりコストが揃って、組織全体の導入判断ができる状態になるという。
この速度は、タスクが事前に書き下されていることに依存する。各タスクは指示文、制限時間・CPU・メモリ、サンドボックス用のDockerfile、graderを走らせるスクリプト、合格必須の参照解を1つのフォルダにまとめたものだ。例として、サンドボックス内でエージェント評価を回すオープンソースフレームワークHarborの形式が挙げられている。
最も難しいのは採点基準(ルーブリック)の作成だとされる。長いタスクは複数ラウンドにわたり、ラウンド間で模擬レビュアーが指摘を返す。モデルgraderは8つの重み付き観点を0〜3で採点する。内訳は納品の正確性25、判断力10、検証品質15、根拠と報告10、自律性15、可読性10、設計と作業量の適合10、運用規律5で、レビュアーが繰り返しエージェントを救済した場合は合計が100点中25点に制限される。
本番で見る指標
ロールアウト後は、CloudWatchのAWS/Bedrock名前空間のメトリクスで調査する。レイテンシはInvocationLatency、TimeToFirstToken、OutputTokenCount、そして導出値であるOTPS(毎秒出力トークン数)。スロットリングはInvocationThrottlesと、キャッシュ書き込みトークンや出力のバーンダウン係数を含むEstimatedTPMQuotaUsage(1分あたりトークンクォータの推定消費量)。コストは入力・キャッシュ読み取り・キャッシュ書き込み・出力の各トークン数で、それぞれ単価が異なる。
一例として、レイテンシが40%上昇したのにTimeToFirstTokenとOTPSは横ばいだったケースが示されている。システムプロンプトが変更されてより丁寧な回答を求めるようになり、1リクエストあたりの出力トークンが50%増えていた。生成速度は変わらず回答が長くなっただけで、プロンプト変更をデプロイとして扱いダッシュボードに記録すべきだという教訓になっている。
Airbnbは毎週、CloudWatchの実行時メトリクスとゲートウェイの利用記録をモデルごとに突き合わせる。リクエストあたりコストとユーザーあたり平均リクエスト数も集計し、新モデルはこの両方を動かしうるため、ロールアウトのたびにevalのタスクあたりコストから期待していた値と比較する。
前提条件と注意点
再現にはAWS側と自社側の両方の準備が要る。AWS側は対象モデルへのアクセス、ストリーミングAPI(TimeToFirstTokenはストリーミングでのみ公開される)、呼び出す全リージョンでのモデル呼び出しログの有効化、呼び出し元IAMロールのタグ付けとコスト配分タグの有効化だ。モデル呼び出しログはデフォルトで無効であり、コスト配分タグは後から有効化しても過去分には遡及しないとされている。
モデル呼び出しログにはプロンプトと応答の全体、呼び出し元の識別情報が含まれうるため、閲覧権限の制限と保持期間の設定が求められる。自社側の準備としては、実際のエンジニアリング作業から作ったタスクセットと信頼できるgrader、モデル・クライアント・チーム・ユーザー・トークン数を記録するゲートウェイ、日付付きの公開リスト価格表の3つが挙げられている。
なお原文は、モデルAというモデルの本番コストを検証している途中で終わっており、その後の結論は示されていない。モデルAはコーディングタスクで従来の最良モデルを3ポイント余り上回り、タスクあたりコストはほぼ同じだったため、effort上限をhighにしたうえで大半の作業にはlowまたはmediumを使うよう案内した、というところまでが確認できる範囲である。
| 項目 | 低effort | 高effort |
|---|---|---|
| スコア | 基準 | 0.8ポイント高い |
| タスクあたりコスト | 基準 | 2.5倍 |
On one model we tested, moving from low to high effort raised the score by 0.8 points. Cost per task was 2.5 times as high.
試験したあるモデルでは、低effortから高effortに上げるとスコアが0.8ポイント上がりました。一方でタスクあたりコストは2.5倍でした。
今後の見通し
モデルの更新が続く限り、事前のevalと本番監視を突き合わせる運用は一時的な取り組みではなく常設の仕組みになるとみられる。次の判断材料になるのは、モデルAの本番コストが評価時のタスクあたりコストからどれだけずれたか、そしてキャッシュヒット率やeffort設定が実利用でどう分布したかという点だ。日本企業にとっては、利用予定のモデルが自社リージョンで提供されているか、EstimatedTPMQuotaUsageなどのメトリクスが自社アカウントで取得できるかを先に確認すると判断しやすい。
日本の開発者・IT企業にとっての意味
コーディングエージェントの費用は、APIの1リクエスト単価では把握しきれない。1タスクを終えるまでに多数のリクエストが発生し、そのたびに文脈を読み直すため、タスク単位で積み上げないと予算と品質の関係が見えない。Airbnbの手法は、モデル更新が速い環境で既定モデルを決める業務フローとして参考になる。日本のIT企業にとっては、BedrockとCloudWatchだけで評価と監視を構成できる点が現実的だ。一方で、自社タスクのセットとgrader、トークン数を記録するゲートウェイ、日付付きの価格表という3つの準備が前提になる。モデル切り替えを前提にゲートウェイを挟む設計にしておくことが、実務上の分かれ目になるとみられる。
気になる点
- この評価・監視の仕組みは日本企業でも再現できますか
- 使うAWS機能はAmazon BedrockとCloudWatchで、特定リージョンに限るという記載はありません。ただしBedrockのモデル提供状況はリージョンごとに異なり、原文もリージョン別の可用性を確認するよう案内しています。対象モデルが使えるリージョンか、必要なメトリクスが取得できるかを先に確認する必要があります。
- タスクあたりコストを測るには何を用意すればよいですか
- 原文では3つ挙げられています。自社のエンジニアリング作業から作ったタスクセット(初期リポジトリ状態・プロンプト・信頼できるgrader)、モデルやチーム、トークン数を記録するゲートウェイ、日付付きの公開リスト価格表です。タスクは指示文や実行環境、graderをまとめたフォルダ形式で用意し、Harborのようなフレームワークも選択肢として示されています。
- モデル呼び出しログを有効にする際の注意点はありますか
- デフォルトでは無効で、呼び出すすべてのリージョンで有効化する必要があります。ログにはプロンプトと応答の全体、呼び出し元の識別情報が含まれうるため、閲覧できる人を制限し、保持期間を設定することが求められています。コスト配分タグも、計測を始める前に有効化しておかないと過去分は集計されません。
用語解説
- Amazon Bedrock
- AWSの基盤モデル利用サービス。複数プロバイダーのモデルを共通APIで呼び出せ、認可や監視はAWS側で管理される。
- コーディングエージェント
- コードの調査・編集・テストを自律的に繰り返し、ひとつのタスクを完了させるAIエージェント。
- タスクあたりコスト
- エージェントが1つのタスクを終えるまでに消費した全トークンを、公開リスト価格で積み上げた費用。
- reasoning effort
- 応答前にモデルがどれだけ推論するかを制御する設定。上げるほど精度とコストが増える傾向がある。
- OTPS
- 毎秒あたりの出力トークン数。Bedrockにネイティブ指標がなく、メトリクス数学で導出して使う。
- grader
- エージェントの成果物を採点するプログラムまたはモデル。evalのスコアはこれが付ける。
出典
How Airbnb uses cost per task to operate coding agents on Amazon Bedrock
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する