- CloudWatchのDetectGroupOutliers APIでジョブ内のGPUを比較し、逸脱した個体を特定
- XID・ECC・EFA低下・熱暴走など既知の異常パターンを静的ルールで検出
- EKSはアドオン、Slurmは拡張として提供。メトリクスストアの既定はCloudWatchに変更
何が発表されたのか
AWSはAmazon SageMaker HyperPodに、インフラの可観測性を高める新機能を追加したと発表しました。対象はGPUを使った大規模分散トレーニングで、ジョブ全体の速度低下が起きたときに「どこで、なぜ詰まっているのか」を短時間で絞り込むことを目的としています。
背景として、分散トレーニングでは1基の異常なアクセラレータがジョブ全体を止めうることが挙げられています。従来は複数のツールとダッシュボードを突き合わせる必要があり、「性能が落ちた」ことは分かっても原因の特定に時間がかかっていました。新機能はこの切り分けをHyperPod側で支援します。
提供形態はオーケストレータによって異なります。Amazon EKS上のクラスタではアドオン、Slurm上のクラスタではクラスタ拡張として導入し、AWS Identity and Access Management(IAM)でインストールや変更の権限を制御できます。
2層のメトリクスと保存先
メトリクスは2段階で収集されます。デフォルトメトリクスは自動で有効になり、クラスタの健全性、CPU・ディスク・OSレベルの使用率、GPU使用率と温度、ジョブ別のリソース使用状況をカバーします。収集間隔は30秒で、CPUオーバーヘッドは約1〜2%、メモリは250〜300MBと説明されています。
詳細メトリクスはオプトインです。node exporterの一式、NVIDIA GPUのDCGMとAWS Neuronの全メトリクス、Elastic Fabric Adapter(EFA)のスループット・ドロップ・再送・エラーが含まれます。取得項目が増えるとメトリクスストアへの送信量が増え、コストに影響するため任意扱いになっています。小規模クラスタの短いジョブでは不要なことが多く、大規模クラスタで長時間動かすジョブに向くとされています。
保存先はAmazon CloudWatchとAmazon Managed Service for Prometheusから選べます。これまではPrometheusのみでしたが、CloudWatchが新しい既定になりました。Amazon Managed Service for Prometheusより低い価格で、SageMakerコンソールとの統合も密であると説明されています。
診断サマリの仕組み
診断サマリは2つの手法を組み合わせます。1つはCloudWatchのDetectGroupOutliers APIを使うGPU外れ値検出です。トレーニングジョブ内のGPUを、使用率・メモリ使用量・温度・消費電力・SMクロックの観点で比較し、集団から大きく外れたGPUをサマリ上にカードとして表示します。EKSとSlurmの両方のジョブで機能します。
もう1つは静的診断ルールで、既知の失敗パターンを種類別に整理して検出します。ハードウェア(GPUのECCメモリエラー、XIDフォールト、アクセラレータ障害)、ネットワーク(EFAスループット低下、パケットドロップ、再送)、スロットリング(熱・ボード・信頼性上限によるGPUクロック低下)、オーバーヒート(設定上限を超えるGPU温度)の4分類です。
検出された各問題は、影響を受けているジョブ、クラスタ、ノード、アクセラレータ、ランクまで特定されます。監視タブではノード数やアクセラレータ数、稼働中ジョブ数、GPU・vCPU・メモリの平均使用率といった全体像も確認でき、そこからCloudWatch SageMaker Insightsのダッシュボードへ遷移できます。
導入と注意点
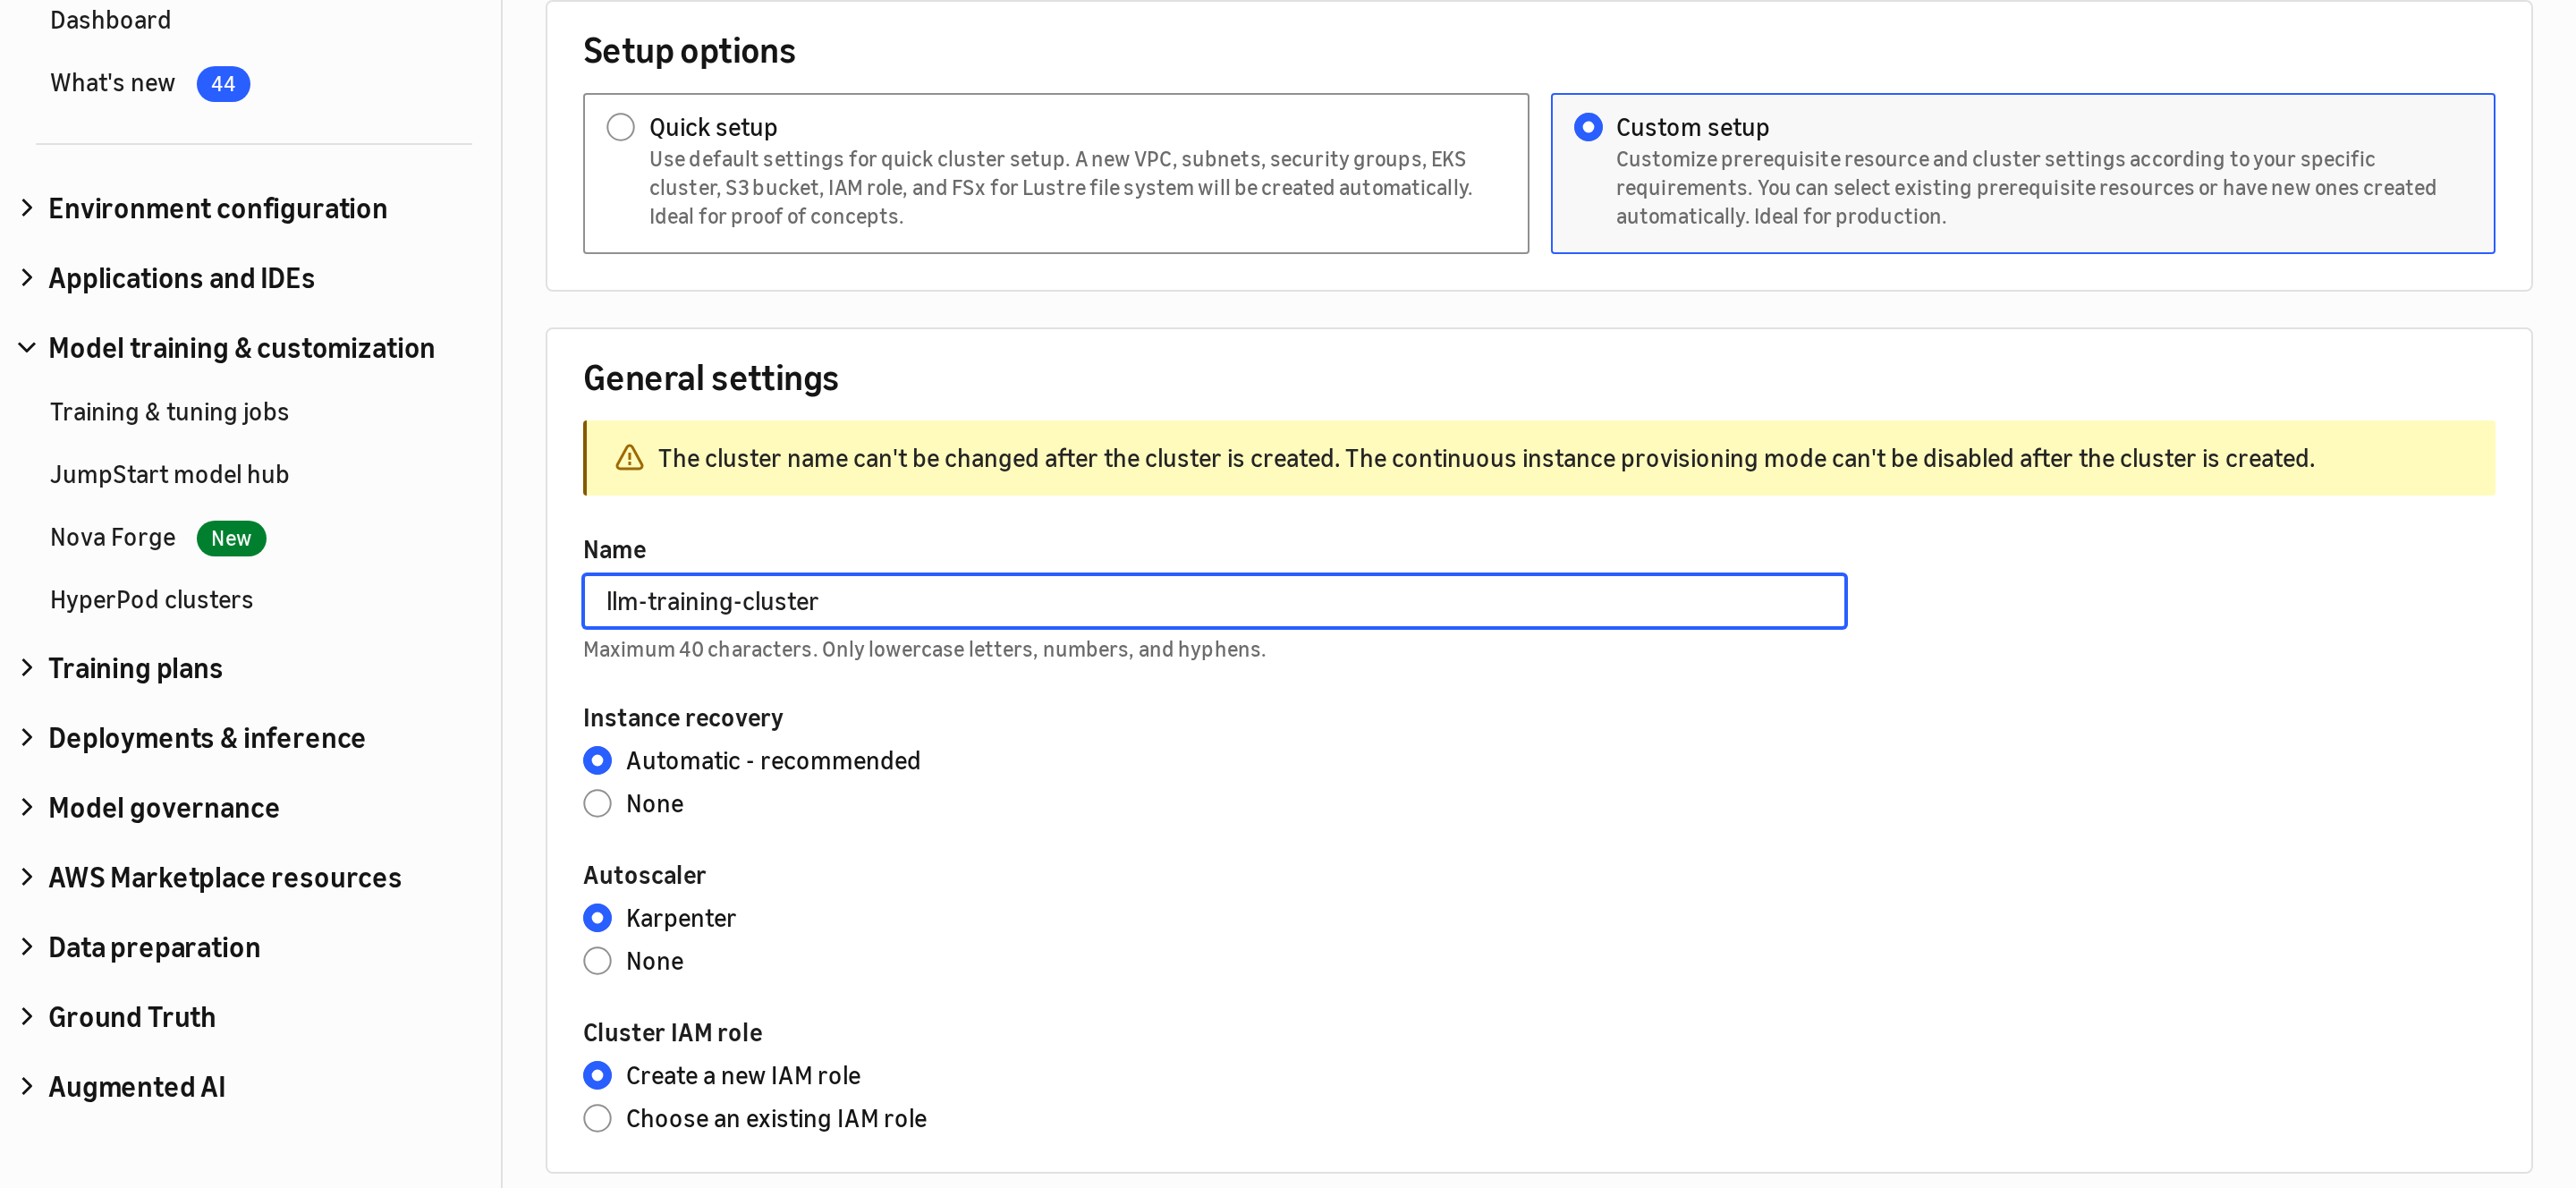
コンソールのカスタムセットアップでは、HyperPod observabilityのセクションで有効化のオン・オフ、詳細メトリクスの選択、ログ出力、メトリクスストア、Grafanaワークスペースを設定します。クイックセットアップでは可観測性は既定で有効になり、オフにできない点が異なります。
AWS CLIからも設定できます。EKSではamazon-sagemaker-hyperpod-observabilityアドオンをcreate-addonで作成し、update-addonでメトリクス階層を変更します。Slurmではsagemaker-observability拡張をcreate-cluster-extensionで作成し、update-cluster-extensionでEFAメトリクスなどを追加します。
注意点として、原文には具体的な料金や対応リージョンの記載がありません。また「3つのギャップを埋める」と説明されていますが、明示的に列挙されているのは異常なアクセラレータの切り分けに関する記述が中心です。ホストプロファイリングについては設定例に無効化の項目があるものの、詳細な説明は示されていません。
| 項目 | デフォルトメトリクス | 詳細メトリクス(オプトイン) |
|---|---|---|
| 有効化 | 自動で有効 | 任意で選択 |
| 収集間隔 | 30秒ごと | 30秒ごと(設定例) |
| 主な内容 | クラスタ健全性、CPU・ディスク・OS、GPU使用率と温度、ジョブ別リソース | node exporter一式、NVIDIA DCGM・Neuron、EFA |
| 負荷・コスト | CPUオーバーヘッド約1〜2%、メモリ250〜300MB | 送信量が増えるためコストに影響 |
Enhanced observability closes three gaps. It isolates a single bad accelerator across hundreds or thousands of GPUs whether through XID errors, ECC memory faults, or thermal throttling, so you spend time on the fix instead of the search.
強化された可観測性は3つのギャップを埋めます。XIDエラー、ECCメモリフォールト、サーマルスロットリングのいずれであっても、数百から数千のGPUの中から1基の異常なアクセラレータを切り分けるため、調査ではなく修正に時間を使えるようになります。
今後の見通し
現時点で判断材料が足りないのは、料金と対応リージョンです。詳細メトリクスはメトリクス量が増えてコストに影響するとだけ説明されており、どの程度の追加費用になるかは示されていません。CloudWatchとAmazon Managed Service for Prometheusの価格差も具体的な数字は出ていません。これらの実額と、HyperPod自体を提供しているリージョンとの関係が明らかになれば、日本国内のチームが採用を判断しやすくなるとみられます。ホストプロファイリングの用途が説明されれば、さらに踏み込んだ評価が可能になります。
日本の開発者・IT企業にとっての意味
GPUクラスタの運用では、性能が出ない原因がGPUなのかネットワークなのかデータ供給なのかを切り分ける作業が大きな工数になります。今回の機能はこの切り分けをHyperPodの標準機能に取り込むもので、特にGPU使用率や温度をCloudWatchで見ている企業は、既存の監視基盤を大きく変えずに試せるとみられます。EKSとSlurmの両方に対応するため、既存のオーケストレータを維持したまま導入できる点も実務上は有利です。一方、詳細メトリクスはコスト増につながるため、まずデフォルトメトリクスで運用し、必要になった段階でEFAやDCGMを有効化する進め方が現実的です。HyperPod前提の機能であるため、オンプレミスや他クラウドのGPU基盤にはそのまま適用できない点には注意が必要です。
気になる点
- 既存のHyperPodクラスタでも使えますか
- 既存クラスタでも利用できます。EKSではアドオン、Slurmではクラスタ拡張として追加し、コンソールまたはAWS CLIからインストールします。メトリクスの種類やプロファイリングは後からいつでも有効・無効を切り替えられます。
- 追加コストはどのくらいかかりますか
- 詳細メトリクスは送信量が増えるためコストに影響すると説明されていますが、具体的な金額は原文に記載がありません。メトリクスストアはCloudWatchが既定で、Amazon Managed Service for Prometheusより低い価格とされています。
- 日本リージョンでも利用できますか
- 対応リージョンは原文に記載がありません。HyperPod自体を提供しているリージョンに準じるとみられますが、断定はできません。利用可否はAWSのリージョン別の提供状況を確認する必要があります。
用語解説
- Amazon EKS
- Kubernetesでコンテナを運用するAWSのマネージドサービス。HyperPodのオーケストレータの一つ。
- Slurm
- HPC向けのオープンソースジョブスケジューラ。HyperPodではEKSと並ぶ構成として選べる。
- EFA
- Elastic Fabric Adapter。AWS上のHPC・機械学習向け低遅延ネットワークインターフェース。
- NVIDIA DCGM
- GPUの状態監視・診断を行うNVIDIAのツール群。クロックや電力、エラー指標を収集する。
- XIDエラー
- NVIDIA GPUがドライバレベルで報告するエラーコード。ハードウェア異常の把握に使われる。
- ECCメモリエラー
- GPUメモリの誤り訂正機構が検出したエラー。メモリ不良の兆候を示す。
出典
Introducing enhanced infrastructure observability in Amazon SageMaker HyperPod
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する