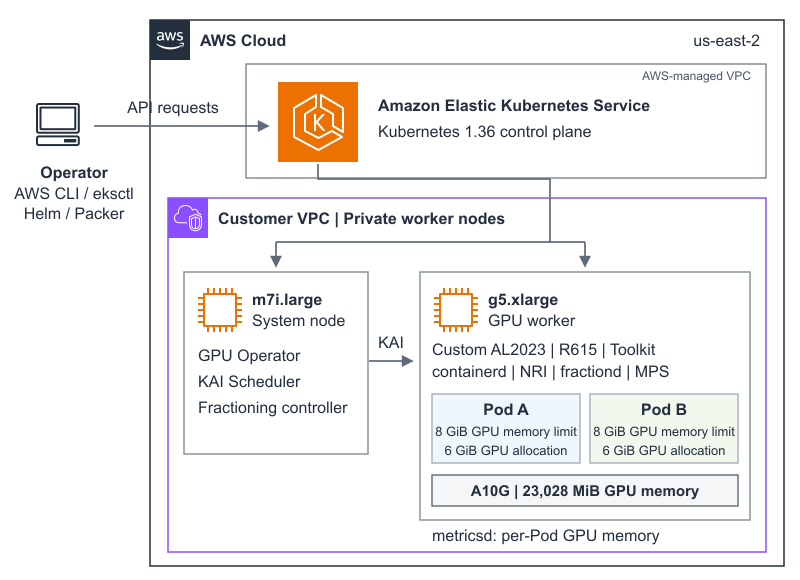
- Run:ai GPU FractioningはMPSを基盤に、Pod単位のGPUメモリ上限を強制する仕組み
- 検証はA10G搭載g5.xlarge 1台。8 GiB契約の2 Podを同時実行し、9 GiB要求は拒否
- Operator v0.1.7はR615以降のドライバが必要で、EKS最適化AMIでは足りずカスタムAMIを構築
AWSが公開した検証手順
NVIDIAは2026年10月13日にRun:aiのオープンソースリリースを発表しました。Run:aiはKubernetes向けのAIワークロードオーケストレーションソフトウェアで、4つのモジュールコンポーネントのうち、今回の記事はKAI SchedulerとGPU Fractioning Operatorの2つを使います。残るKAI Resource ManagementとWorkload Mapは組織統制や他のワークロード種別を扱うもので、検証の範囲外とされています。
検証環境は米国東部(オハイオ)のus-east-2リージョンで、Kubernetes 1.36のEKSクラスタにm7i.largeのシステムノードとg5.xlargeのGPUワーカーを1台ずつ置く構成です。GPUはA10Gで、メモリは23,028 MiBと記載されています。共有を無効にしたベースラインでは、GPUはnvidia.com/gpu: 1という1つのリソースとして公開され、これを要求する2つのPodは、メモリ需要の合計が収まっていても同時には動かせません。
GPU Fractioningを有効にすると、各Podに8 GiBのメモリ契約を与え、実際に6 GiBを割り当てる構成で2つのPodが同居します。さらに9 GiBを要求するPodが拒否されること、Pod単位のメトリクスが取得できることを確認しています。記事はこの一連の流れを10ステップの実装手順として整理しています。
MPSに何を足したのか
GPU共有は新しい技術ではなく、MIG、time-slicing、MPSがそれぞれ異なる分離と利用率のニーズに応えてきました。MIGは対応GPU上でハードウェア的なパーティションを作り、device pluginによるtime-slicingはメモリの複製も障害分離も伴わずにGPUを共有します。MPSは複数のCUDAプロセスを同時に実行させる仕組みで、障害の封じ込めは設定次第とされています。
GPU FractioningはこのMPSを土台に、Kubernetesのスケジューリング統合、コンテナ単位のメモリ上限の強制、Podごとのメトリクスを加えたものと位置づけられます。コンピュートモードはtime-slicing(デフォルト)またはsm-sharingを選べ、MIGを持たないGPUにも適用できる点が特徴です。実装ではfractiondがNode Resource Interface(NRI)経由で-containerdと連携し、metricsdがメトリクスを公開する構成が示されています。
ただしメモリ上限はコンピュートの比例予約ではなく、セキュリティ保証でもないと原文は明言しています。今回の検証が確かめたのはメモリ上限の動作であり、障害封じ込めやコンピュート性能は検証対象外です。
R615ドライバ必須の理由
検証時点のEKS最適化AL2023 NVIDIA AMIが提供していたドライバはR580とR595の枝で、GPU Fractioning Operator v0.1.7はR615以降を要求します。そのためPackerでカスタムのAL2023イメージをビルドし、NVIDIAドライバ615.71.10を組み込んでいます。NVIDIA_DRIVER_VERSIONはR615ブランチを指す指定であり、パッチ版を厳密に固定するものではないと注意されています。
前提条件として、固定サイズのGPUノードグループで動かせることも挙げられています。デバイス割り当てにはDynamic Resource Allocation(DRA)ではなくNvFractionsのアノテーションを使う方式です。KAI SchedulerとGPU OperatorはDRAをサポートするとされていますが、この手順では採用していません。
検証ではEKSコントロールプレーン、NATゲートウェイ、インスタンス、ボリューム、AMIスナップショットなど課金対象のリソースが作られるため、使い捨ての環境で実施し、終了後に片付けることが求められています。
向く用途と測るべき指標
記事が想定する用途は、アイドル時間のある対話型ノートブック、短時間の評価ジョブ、GPU互換性のテスト、小規模な推論サービスです。いずれも常時GPUを占有しない一方で、空きメモリがあってもPodを起動できない待ち時間が問題になりやすいワークロードだといえます。
メモリ要求量は実測したピーク使用量にオーバーヘッドを足して決め、同時負荷をかけた状態でレイテンシを測るよう勧めています。原文は、実証された密度の改善がスループットの向上や普遍的なコスト削減を立証するものではないと明記しており、導入判断には別途の性能測定が必要です。
| 項目 | 共有無効(ベースライン) | GPU Fractioning使用時 |
|---|---|---|
| 同時実行 | nvidia.com/gpu: 1を要求する2 Podは同時に動かない | 8 GiB契約の2 Podが同時に動作(検証済み) |
| メモリの割り当て | GPU全体を1つのnvidia.com/gpuとして公開 | Podごとのメモリ契約として宣言し上限を強制 |
| 上限超過の要求 | 共有が無効のため該当しない | 9 GiBの要求を拒否することを確認 |
The demonstrated density improvement does not establish a throughput gain or a universal cost reduction.
実証された密度の改善は、スループットの向上や普遍的なコスト削減を立証するものではない。
今後の見通し
Run:aiがオープンソース化されたことで、EKS以外の環境も含めた検証が今後広がるとみられます。判断材料として注目したいのは、EKS最適化AL2023 NVIDIA AMIがR615以降のドライバ枝を取り込むかどうかです。取り込まれればカスタムAMIのビルドが不要になり、導入の敷居は下がります。加えて、同時実行時のスループットとレイテンシの実測値、sm-sharingモードの挙動、DRAを使う方式への移行可否が明らかになれば、本番採用の可否をより具体的に判断できると考えられます。
日本の開発者・IT企業にとっての意味
GPUの調達が難しい状況では、1台のGPUを複数チームで使い回したいという要求が強くなります。特にA10GのようにMIGを使えないGPUで、ノートブックや評価ジョブが空きメモリがあるのに待たされている場合、Podごとのメモリ上限を強制できる選択肢は実務上の意味があります。一方で、導入にはR615以降のドライバを含むカスタムAMIのビルド、固定サイズのGPUノードグループ、Operatorのハードウェア要件の確認が必要です。メモリ上限はコンピュートの比例予約ではないため、レイテンシに敏感な推論を同じノードに相乗りさせる場合は事前の負荷試験が欠かせません。PoCでは密度だけでなくスループットとレイテンシを測り、ビルドしたAMIの保守体制も含めて判断することが求められます。
気になる点
- 日本のリージョンのEKSでも同じ手順は使えますか
- 記事の検証はus-east-2で行われており、日本リージョンでの確認結果は原文に記載がありません。別リージョンを使う場合は、選択したEKSバージョンとインスタンスタイプがそのリージョンで利用できることの確認が必要とされています。手順自体はリージョン名の設定を変えて流用する形になります。
- 既存のEKSクラスタにそのまま導入できますか
- そのままとは限りません。Operator v0.1.7はR615以降のドライバを要求し、検証時点のEKS最適化AMIはR580とR595だったため、カスタムAMIのビルドが必要でした。加えて固定サイズのGPUノードグループで動かせること、GPUがOperatorのハードウェア要件を満たすことの確認が前提になります。
- GPUを分割するとコストは下がりますか
- 原文は、確認できたのはPod密度の改善であり、スループット向上や普遍的なコスト削減を立証するものではないとしています。また検証自体がEKSコントロールプレーンやNATゲートウェイなどの課金リソースを伴います。コスト判断には、実際のワークロードで同時負荷時のレイテンシと処理量を測る必要があります。
用語解説
- MIG(Multi-Instance GPU)
- NVIDIA GPUをハードウェアレベルで複数のインスタンスに分割する機能。対応GPUが限られる。
- MPS(Multi-Process Service)
- 複数のCUDAプロセスを同一GPU上で同時に実行させるNVIDIAの仕組み。
- time-slicing
- GPUを時間方向に分割して複数のPodで共有する方式。メモリの複製や障害分離は伴わない。
- KAI Scheduler
- Run:aiのオープンソース版に含まれるKubernetes向けスケジューラ。Podの配置を制御する。
- DRA(Dynamic Resource Allocation)
- Kubernetesでデバイスを要求・割り当てるためのAPI群。共有や分離の挙動はドライバ実装に依存する。
- NRI(Node Resource Interface)
- containerdなどのコンテナランタイムにプラグイン機能を追加するためのインターフェース。
出典
Using NVIDIA Run:ai GPU Fractioning on Amazon EKS
https://aws.amazon.com/blogs/machine-learning/using-nvidia-runai-gpu-fractioning-on-amazon-eks
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する