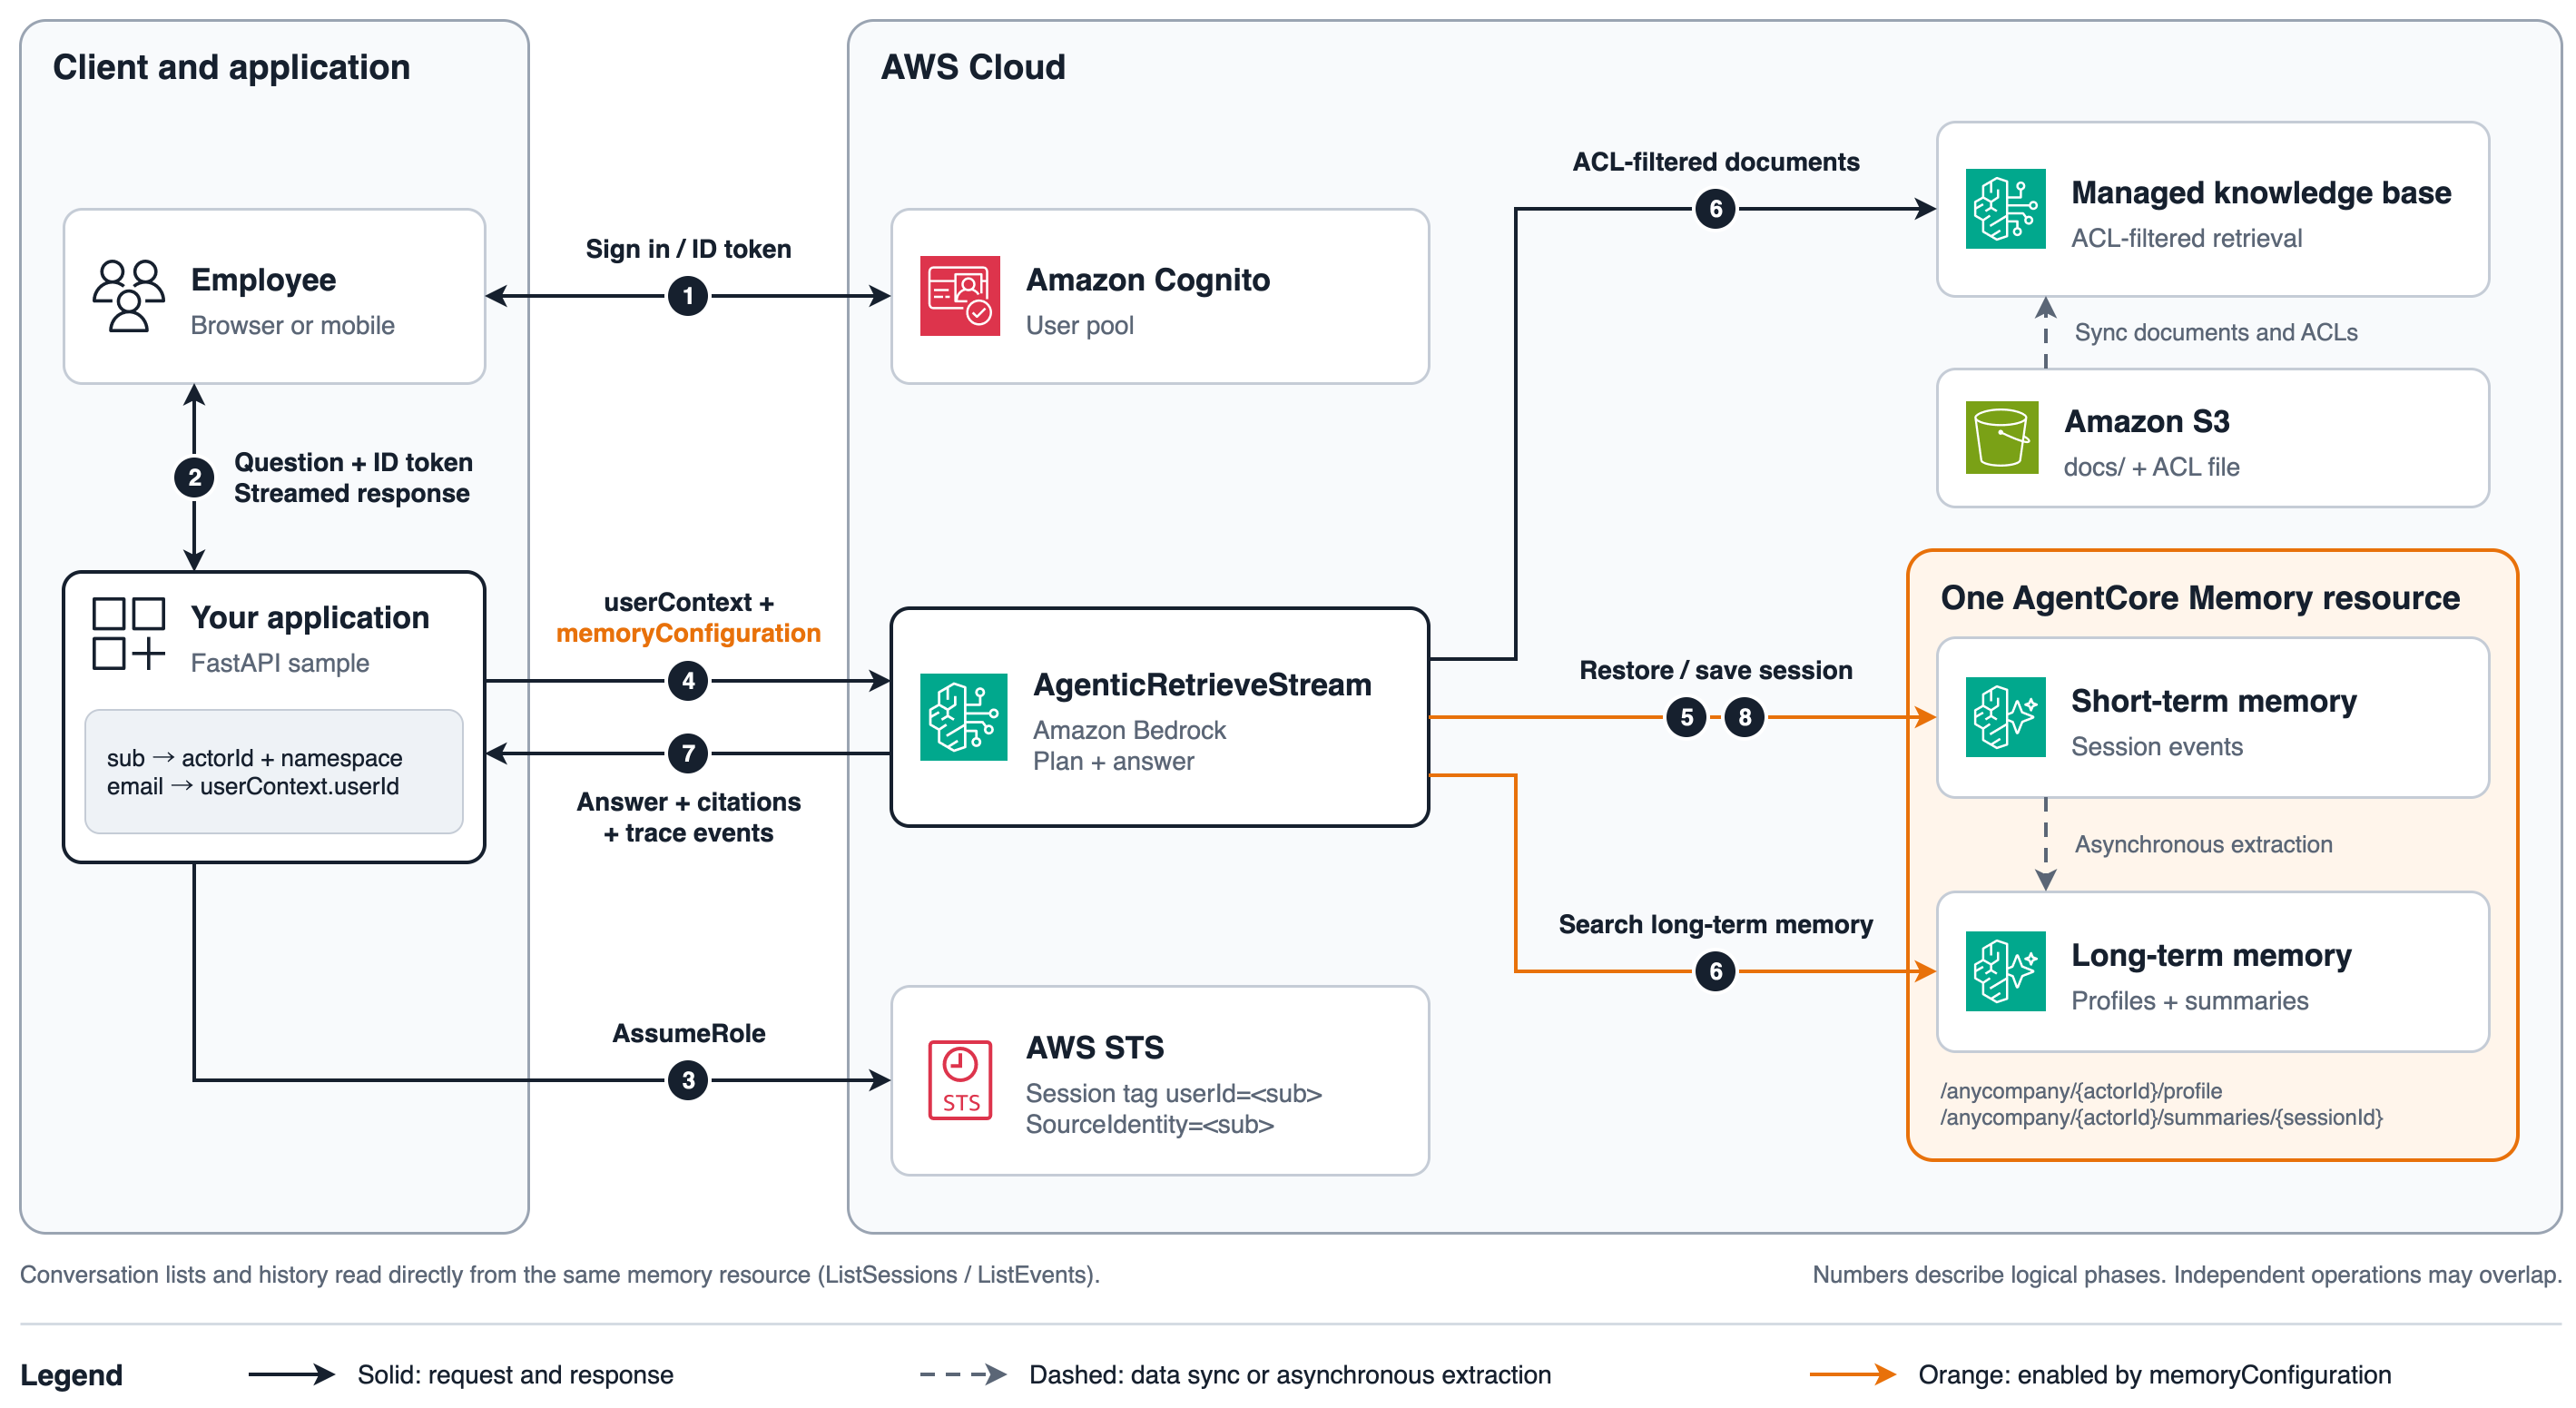
- AgenticRetrieveStreamにmemoryConfigurationを加えると、AgentCore memoryが検索ソースになる
- ユーザー識別はCognitoのIDトークンのsubとemailから取得し、リクエスト本文は使わない
- ACL有効化はデータソース作成時にのみ設定でき、後から変更できない
発表された連携の中身
Amazon Bedrock Managed Knowledge Base と、Amazon Bedrock AgentCore の機能である Amazon Bedrock AgentCore memory が連携しました。AgenticRetrieveStream のリクエストに memoryConfiguration を加えると、AgentCore memory がナレッジベースと並ぶ検索ソースとして扱われます。利用はオプトイン方式で、既存の呼び出しに対する後方互換性があると説明されています。
同じ呼び出しの中で、サービスはまず会話履歴を復元します。次にプランナーが、ユーザーに関する事実を参照すべきかどうかを自分で判断し、長期記憶から取得した内容をナレッジベースへのサブクエリの組み立てに使います。回答を生成した後は、そのやり取りを再び記憶へ保存します。
さらに同じリクエストには userContext が含まれ、ナレッジベースは利用者のアクセス制御リスト(ACL)で許可された文書だけを返します。アプリケーション側に残るのは、利用者の認証と「誰であるか」の受け渡しだけだと原文は説明しています。
IDの対応付けと分離
原文のサンプルでは、従業員は Amazon Cognito でサインインし、ID トークン(JWT)を受け取ります。アプリケーションのハンドラは検証済みトークンから2つのクレームを読み取ります。sub はメモリの actorId と namespace に、email は userContext.userId になり、クライアントが送る本文は question と任意の sessionId だけです。
この2つは役割が異なると原文は強調しています。ナレッジベースは、接続先データソースの ACL がメールアドレスで記録されているため email で利用者を識別します。一方、メモリには決して変わらず再利用されない actorId が必要で、Cognito の sub がこれに当たります。メールアドレスは変更されたり、退職者のアドレスが新しい従業員に再割り当てされたりする可能性があり、その場合に古い記憶を引き継いでしまうためです。
サンプルでは、アプリケーションの IAM ロールを userId=<sub> というセッションタグ付きで引き受けます。これにより、アプリケーションコードに誤りがあっても IAM 側でユーザーごとのメモリ分離を強制できると説明されています。1つのメモリリソースを全従業員で共有し、namespace テンプレートの {actorId} で分離する設計です。
2つの記憶戦略とACL
記憶の抽出には2つの戦略があります。summary 戦略は会話ごとに要約し、フランクフルト拠点で Mac を使っている、といった何気ない言及を捉えます。user-preference 戦略は明示された好みを構造化レコードとして抽出し、偶発的な言及を好みとして扱わないと説明されています。
文書側の ACL は、Amazon S3 バケット内のグローバル ACL ファイルで管理します。各エントリは S3 プレフィックスと、それを読めるメールアドレスの組で、ACL に該当しない文書は取り込まれません。サンプルでは11文書がスキャンされ、失敗0件で索引付けされたとのことです。
SharePoint、Google Drive、Atlassian Confluence のように接続元から権限をクロールできるコネクタでも考え方は同じで、権限とグループは接続元から解決され、各結果はリアルタイムで接続元に照合されます。この場合もアプリケーションコードは変わらず、userContext にメールアドレスを渡すだけです。
留意点と未公表の部分
aclEnabled はデータソース作成後に変更できません。また、この連携で使うメモリリソースは、ナレッジベースと同じ AWS アカウントにあり、状態が ACTIVE である必要があります。ウォークスルーは us-west-2 を前提とし、Python 3.10 以降と Boto3 1.43.72 以降が前提条件として挙げられています。
対応リージョンの一覧や料金、クォータについては、この記事の範囲では言及されていません。既存のアプリケーションからの移行については、memoryConfiguration がオプトインで後方互換とされているため、リクエストへの追加という形になるとみられます。
なお、原文は user-preference 戦略の説明の途中で終わっており、戦略の詳細やトレースの読み方の全体は確認できませんでした。実装前に公式ドキュメントで補う必要があります。
| 項目 | Managed Knowledge Base | AgentCore memory |
|---|---|---|
| 担当する処理 | 取り込み、ACLフィルタリング、索引付け、ランキング、計画、検索、生成 | 保存、保持、暗号化、抽出 |
| ユーザーごとの分離 | userContextのemailをACLに照合 | namespaceテンプレートの{actorId}で分離 |
| memoryConfiguration有効時 | セッション復元、記憶検索、永続化も担当 | 構成した戦略に従い長期記憶を非同期で抽出 |
The integration is opt-in and backward compatible. Your application keeps only what is genuinely yours: authenticating the user and passing who they are.
この連携はオプトイン方式で後方互換です。アプリケーションには、本当にアプリケーション自身のものである部分、つまり利用者の認証と「誰であるか」の受け渡しだけが残ります。
今後の見通し
今回の連携は、RAG における記憶と権限の扱いを、アプリケーションの実装からマネージドサービス側へ移すものと位置づけられます。次に判断材料になるのは、対応リージョンの広がりと料金体系、そして既存のマネージドナレッジベースに対して memoryConfiguration をどこまでそのまま適用できるかという点です。ACL の設定方式やコネクタごとの権限同期の挙動も、公式ドキュメントで確認できれば実務での採用判断がしやすくなります。
日本の開発者・IT企業にとっての意味
日本の IT 企業がマルチテナント型の SaaS や社内アシスタントを構築する場合、これまで会話履歴の保存、ユーザーごとの記憶の分離、文書 ACL の適用を自前で実装する必要がありました。今回の連携では、これらをマネージドサービス側に寄せられるため、アプリケーションが持つ責務は認証とユーザー識別の受け渡しに絞られます。特に、IAM のセッションタグでユーザー単位の分離を強制できる点は、実装ミスが情報漏えいにつながりやすい領域での保険になります。一方で、aclEnabled が作成後に変更できないことや、メモリリソースをナレッジベースと同一アカウントに置く必要があることは、既存システムの設計に影響します。導入を検討する際は、リージョン展開と料金、既存の権限管理方式との整合を先に確認することになりそうです。
気になる点
- 日本リージョンでも利用できますか
- 原文のウォークスルーは米国西部(オレゴン)の us-west-2 を前提としており、他のリージョンでの提供状況には触れていません。日本リージョンでの可用性は現時点では公表されていないため、公式のリージョン表で確認する必要があります。
- 既存のアプリケーションから移行できますか
- 連携はオプトインで後方互換とされているため、AgenticRetrieveStream のリクエストに memoryConfiguration を加える形で段階的に導入できるとみられます。ただし aclEnabled はデータソース作成後に変更できないため、ACL を使う場合はデータソースの作り直しが必要になります。
- ユーザーごとの記憶が混ざる心配はありませんか
- namespace テンプレートの {actorId} で分離され、加えて IAM のセッションタグ userId=<sub> により、コードに誤りがあっても分離が強制されると説明されています。actorId にはメールアドレスではなく、Cognito の sub のような変わらない識別子を使うことが推奨されています。
用語解説
- Agentic Retrieve
- エージェントが検索計画を立て、複数のサブクエリを組み立ててナレッジベースを検索する仕組み。
- ACL(アクセス制御リスト)
- 文書やリソースごとに、誰が読めるかを列挙した設定。
- actorId
- メモリ上で利用者を識別する不変のID。Cognitoのsubなどが使われる。
- namespace
- メモリを利用者ごとに区切るための名前空間。テンプレートに{actorId}を埋め込む。
- JWT
- 署名付きのトークン形式。CognitoのIDトークンもこれに当たる。
出典
Build memory-aware AI agents with Agentic Retrieve on Amazon Bedrock Managed Knowledge Base
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する