- SWARMはチケット一次応答を約130倍高速化し、96.2%を自動カバー
- 1つのスキルライブラリを共有する2つのエージェントで構成
- マニュアル追加だけで診断精度が71%から75%に向上、モデル変更なし
SWARMとは何か
米Nateraは、血中の遊離DNA(cfDNA)を使った検査を手がける企業です。検査には多数の精密機器が使われており、機器が停止すると検体処理そのものが滞ります。同社のラボエンジニアリングチーム(Ariel Jirau氏が率いる)はAWSと協力し、ラボ運用向けのエージェントAIシステム「SWARM(Systematic Workflow Analytics and Resolutions Manager)」を構築しました。
SWARMはAmazon Bedrock AgentCore上に構築されています。AWSのブログによると、サポートチケットへの一次応答時間が約130倍速くなり、チケットの96.2%を自動でカバーできるようになったとされています。
背景には「知識の継続性」の問題がありました。特定の機器ファミリーを長年診断してきた熟練技術者が退職すると、その知見は実質的に失われます。65件/日以上、3つのJiraキューにまたがるチケットに平均17.4時間かけて一次応答していた状況を、人員の追加ではなくシステムで変えることが狙いでした。
2つのエージェントとスキルライブラリ
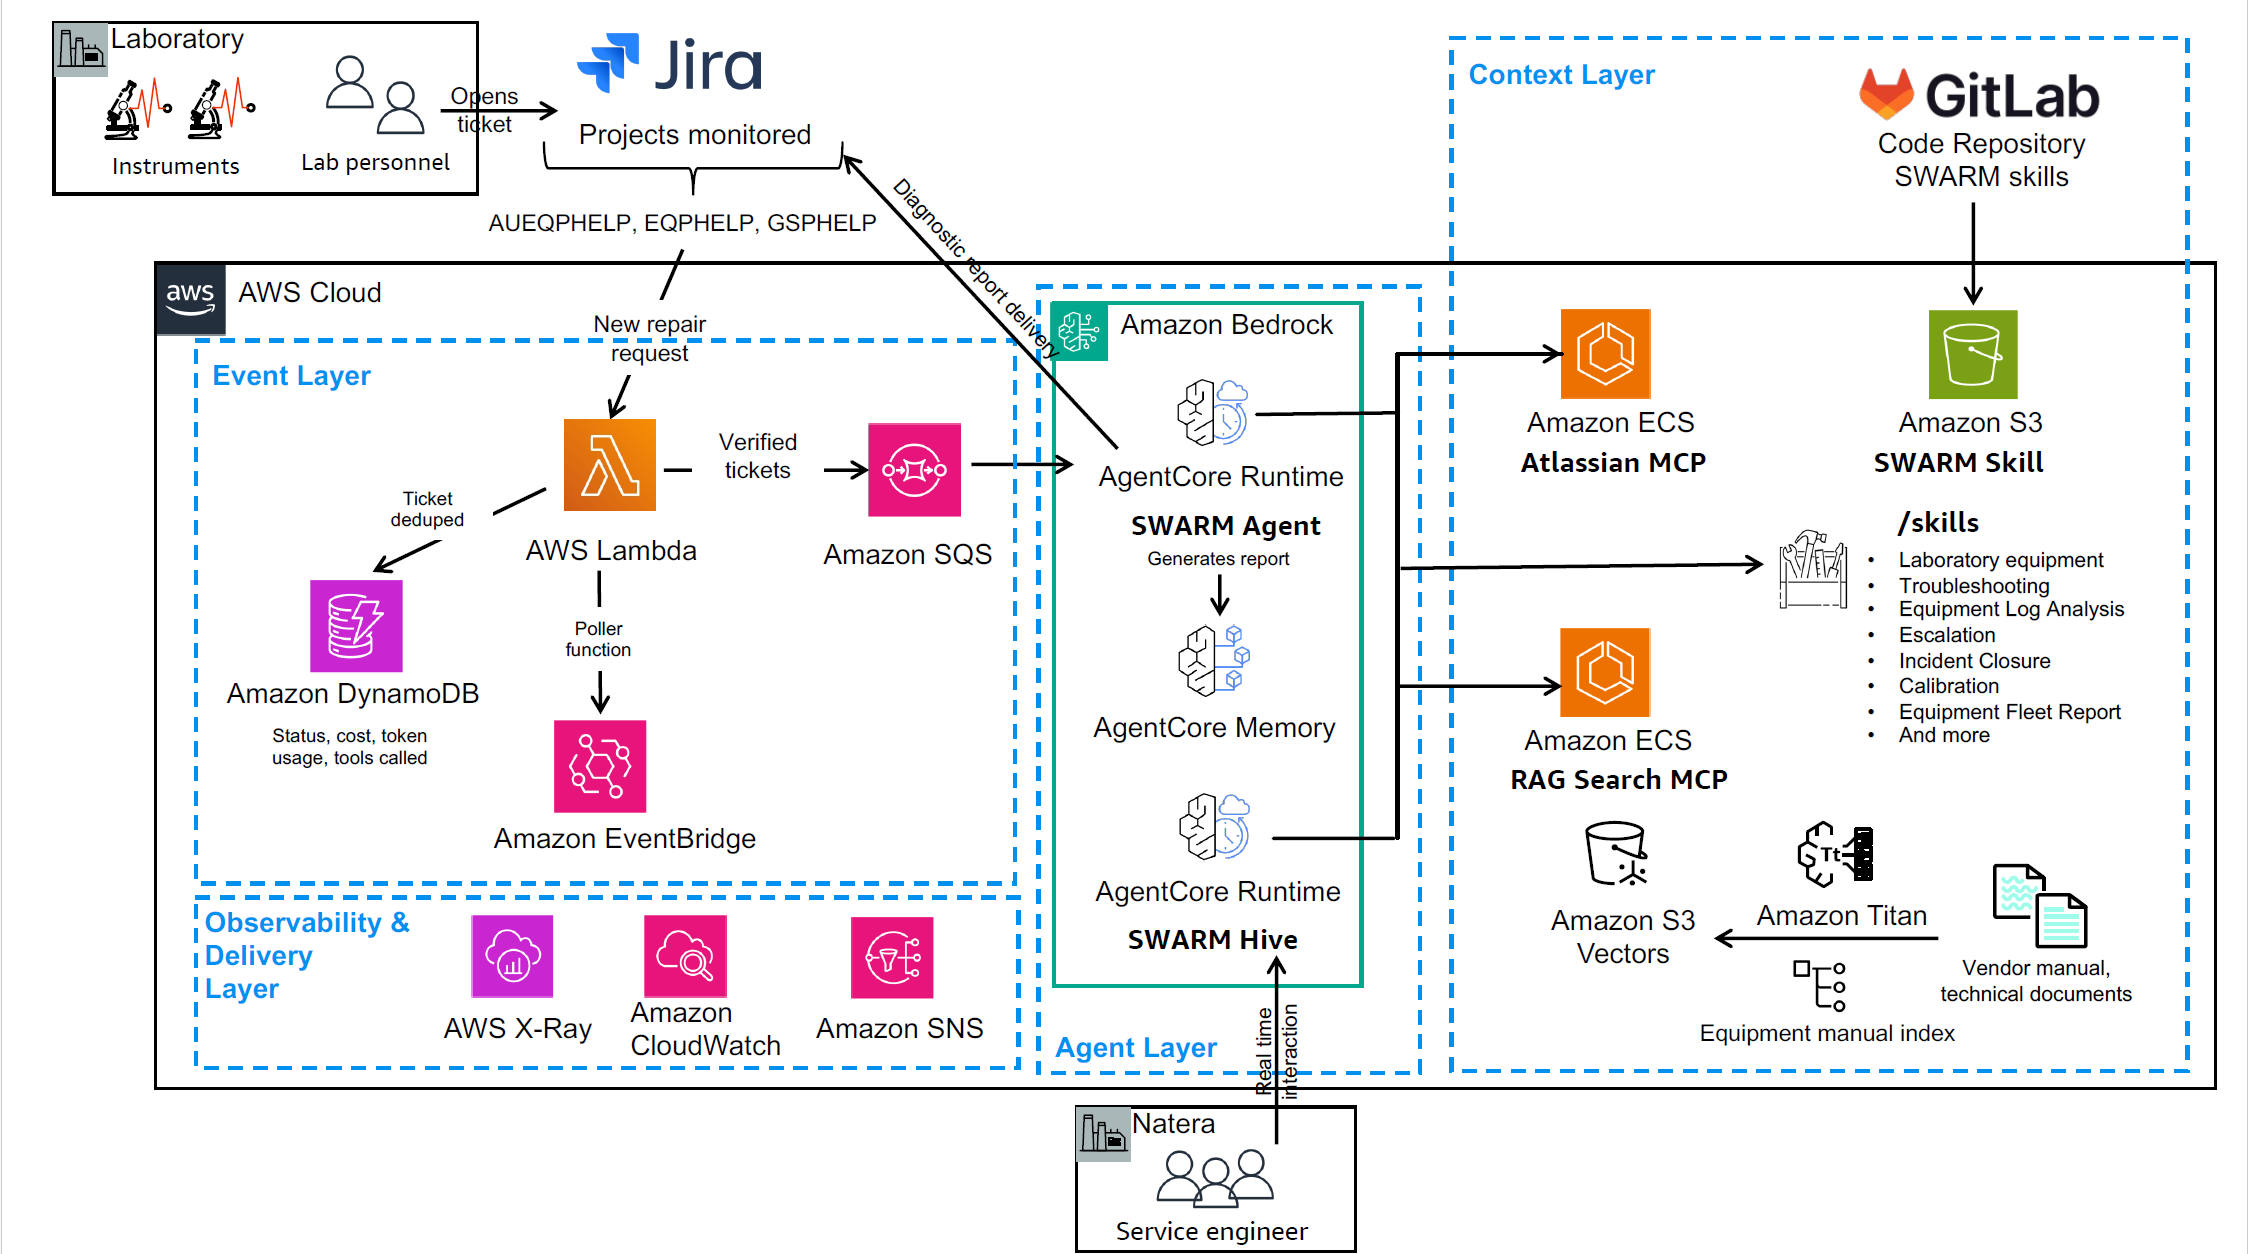
SWARMは、1つのスキルライブラリを共有する2つのランタイムで構成されます。swarm-agentは、エンジニアがチケットを開く前に構造化された診断レポートを自動生成する役割です。もう一方のswarm-hiveは、エンジニアが対話形式で追加質問をしたり、画像をアップロードしたり、別のトラブルシューティング手順を試したりするための役割を担います。
スキルライブラリには33のスキルが登録されています。24が機器固有のスキル、9がチケット種別をまたいで使える共通ワークフローのスキルです。各スキルはインターフェースが定義され、単体でテストでき、システム全体と同じ基準で評価されます。プロンプトにロジックを埋め込むのではなく、バージョン管理されたライブラリとして外部化している点が特徴です。
役割分担も明確です。Jiraの項目解析やHTMLレポート整形のような決定論的な処理はPythonが担当し、症状の解釈やベンダーマニュアルとの照合、診断文の生成といった言語推論はLLMが担います。Jirau氏は、誤診が起きたときにシステム全体ではなく特定のスキルを指せることを、ライブラリ方式を選んだ理由に挙げています。
キーレス運用と臨床環境の統制
エージェントの実行基盤にはAgentCore runtimeを採用し、コンテナのオーケストレーションやスケーリング、認証をマネージド側に任せています。認証情報の露出が許されない臨床環境のため、長期キーを持たない「キーレス」のデプロイ方式を採りました。GitLab CIのランナーがOIDCトークンをIAMのIDプロバイダーに提示し、AWS STSがデプロイ用ロールにスコープした短期の認証情報に交換します。
ネットワークはVPCのプライベートサブネットとVPCエンドポイントで閉じ、IAMでコンポーネント単位の最小権限を適用しています。残る少数の認証情報はAWS Secrets Managerで30日周期の自動ローテーションをかけています。
コンプライアンス面では、SWARMはBAA(Business Associate Agreement)の下でHIPAA対象のAWSサービス上で動作します。エージェントの呼び出しはすべて監査ログに残り、患者を特定できる情報はベクトルインデックスにも言語モデルにも渡さない設計です。チケットに含まれるのは機器とワークフローのメタデータだけだと説明されています。
精度改善はデータ品質から
ナレッジベースはAmazon Bedrock Knowledge BasesのマネージドRAGで構築し、埋め込みにはAmazon Titan Text Embeddingsを使っています。当初は機器固有のメタデータを付けない汎用的な検索で試したものの結果が安定せず、技術文書向けのカスタム文書処理パイプラインを自作しました。
チャンク分割はtiktokenのcl100k_baseエンコーディングで境界を測り、1000トークン、オーバーラップ150トークンという設定です。埋め込みAPIの呼び出しはレート制限とスループットのバランスを取って100文書単位のバッチで行っています。表や図の多い文書では、デフォルトのチャンク分割に頼らずパーサーを自作する価値があると述べられています。
Jirau氏によると、診断精度はまずデータ品質の問題です。スコアが最も低かった機器ファミリーについて不足していたベンダーマニュアルを追加したところ、モデルを変更しないまま精度が71%から75%に上がりました。同チームは、精度が頭打ちになったときはモデルのチューニングより先にデータの網羅性を確認する方針を取っています。
現時点での留意点
SWARMはNateraのラボ運用という特定の文脈で作られたシステムであり、AWSのブログはその設計パターンを紹介する位置づけです。約130倍という応答時間の改善は相対値で、実際の応答時間が何分なのかは原文に記載がありません。
また、96.2%という数字はサポートチケットの自動カバー率であり、診断の正しさまでは示していません。診断精度については71%から75%という数値が示されていますが、これは特定の機器ファミリーにおける計測結果です。
HIPAAとBAAを前提とした構成のため、日本の医療機関や検査会社がそのまま適用できるとは限りません。導入を検討する場合は、自組織に適用される規制とデータ分離の要件を先に確認する必要があるとみられます。
| 項目 | 導入前 | SWARM導入後 |
|---|---|---|
| チケット一次応答時間 | 平均17.4時間 | 約130倍高速(実時間は原文に記載なし) |
| 診断精度(対象機器ファミリー) | 71% | 75%(マニュアル追加後、モデル変更なし) |
| 知見の持ち方 | 熟練技術者の個人知見 | 33スキルのバージョン管理されたライブラリ |
"Diagnostic accuracy is a data quality problem first," Jirau said. "Adding missing vendor manuals for the lowest-scoring instrument family lifted accuracy from 71% to 75% with no model changes."
「診断精度はまずデータ品質の問題です。スコアが最も低かった機器ファミリーについて不足していたベンダーマニュアルを追加したところ、モデルを変更しないまま精度が71%から75%に上がりました」
今後の見通し
現時点で公開されているのはNateraでの導入事例と設計パターンであり、他のラボや業種での再現性はまだ示されていません。約130倍という応答時間の改善や96.2%という自動カバー率が、チケット量や機器の種類が異なる環境でも成り立つかは不明です。次に判断材料になるのは、診断精度の継続的な推移とスキルライブラリの拡張状況でしょう。33スキルのうち24が機器固有であるため、対象機器が増えればスキル追加のコストが発生します。この拡張コストと精度向上のバランスが明らかになれば、同様の仕組みを検討する企業にとって現実的な判断材料になるとみられます。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっての示唆は、エージェントAIの成否がモデル選定より「スキルの外部化」と「データの網羅性」で決まるという点です。SWARMはプロンプトにロジックを埋め込まず、33のスキルを独立してテスト・評価できる形にしています。誤りが起きたときに原因を特定しやすく、業務システムとして運用しやすい構造です。もう1つは権限管理の設計で、OIDCとSTSによる短期認証情報、IAMの最小権限、VPCエンドポイントの組み合わせは、AWS上でエージェントを社内システムに接続する際の雛形になります。JiraやConfluenceなど既存ツールと連携する案件では、webhookではなくポーリングとキューを挟む構成が可用性の面で有効です。一方、医療・金融など規制業種では、データ分離と監査ログの要件を先に固める必要があります。
気になる点
- 日本国内のリージョンでもAmazon Bedrock AgentCoreは使えますか
- 原文ではAmazon Bedrock AgentCoreが複数のAWSリージョンで利用可能とだけ説明されており、具体的なリージョン名や日本リージョンでの提供状況には触れていません。対応リージョンはAWSの公式ドキュメントで確認する必要があります。
- 既存のJira運用を大きく変えずに連携できますか
- SWARMはwebhookを設定せず、Amazon EventBridge Schedulerとポーリング用のLambdaでJiraを監視する構成です。取得したチケットはSQSのキューを経由し、DynamoDBでチケットIDをキーに重複排除します。チケットシステムの可用性からエージェントを切り離せる点が利点として挙げられています。
- 導入や運用のコストはどのくらいですか
- 原文に金額の記載はありません。DynamoDBに実行ごとのステータス・コスト・トークン使用量を保存し、評価ループに使う設計であることまでは説明されていますが、具体的な費用対効果は示されていません。
用語解説
- エージェントAI
- 目標に対して自律的に判断し、ツールやAPIを呼び出しながらタスクを進めるAIシステム。
- RAG(Retrieval Augmented Generation)
- 外部の文書を検索し、その内容を踏まえた回答を生成する手法。回答の根拠を社内文書に置ける。
- Amazon Bedrock AgentCore
- AWSが提供する、AIエージェントの構築・実行・認証・監視をマネージドで行うサービス群。
- OIDC(OpenID Connect)
- 認証情報を連携するための標準プロトコル。ここでは長期キーを持たないデプロイ認証に利用。
- BAA(Business Associate Agreement)
- HIPAAの下で、委託先が患者情報の保護義務を負うことを定める契約。
- ベクトルインデックス
- 文書を埋め込みベクトルに変換して保存し、意味的な類似検索を可能にするデータ構造。
出典
How Natera designed an agentic AI system for lab ops with Amazon Bedrock AgentCore
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する