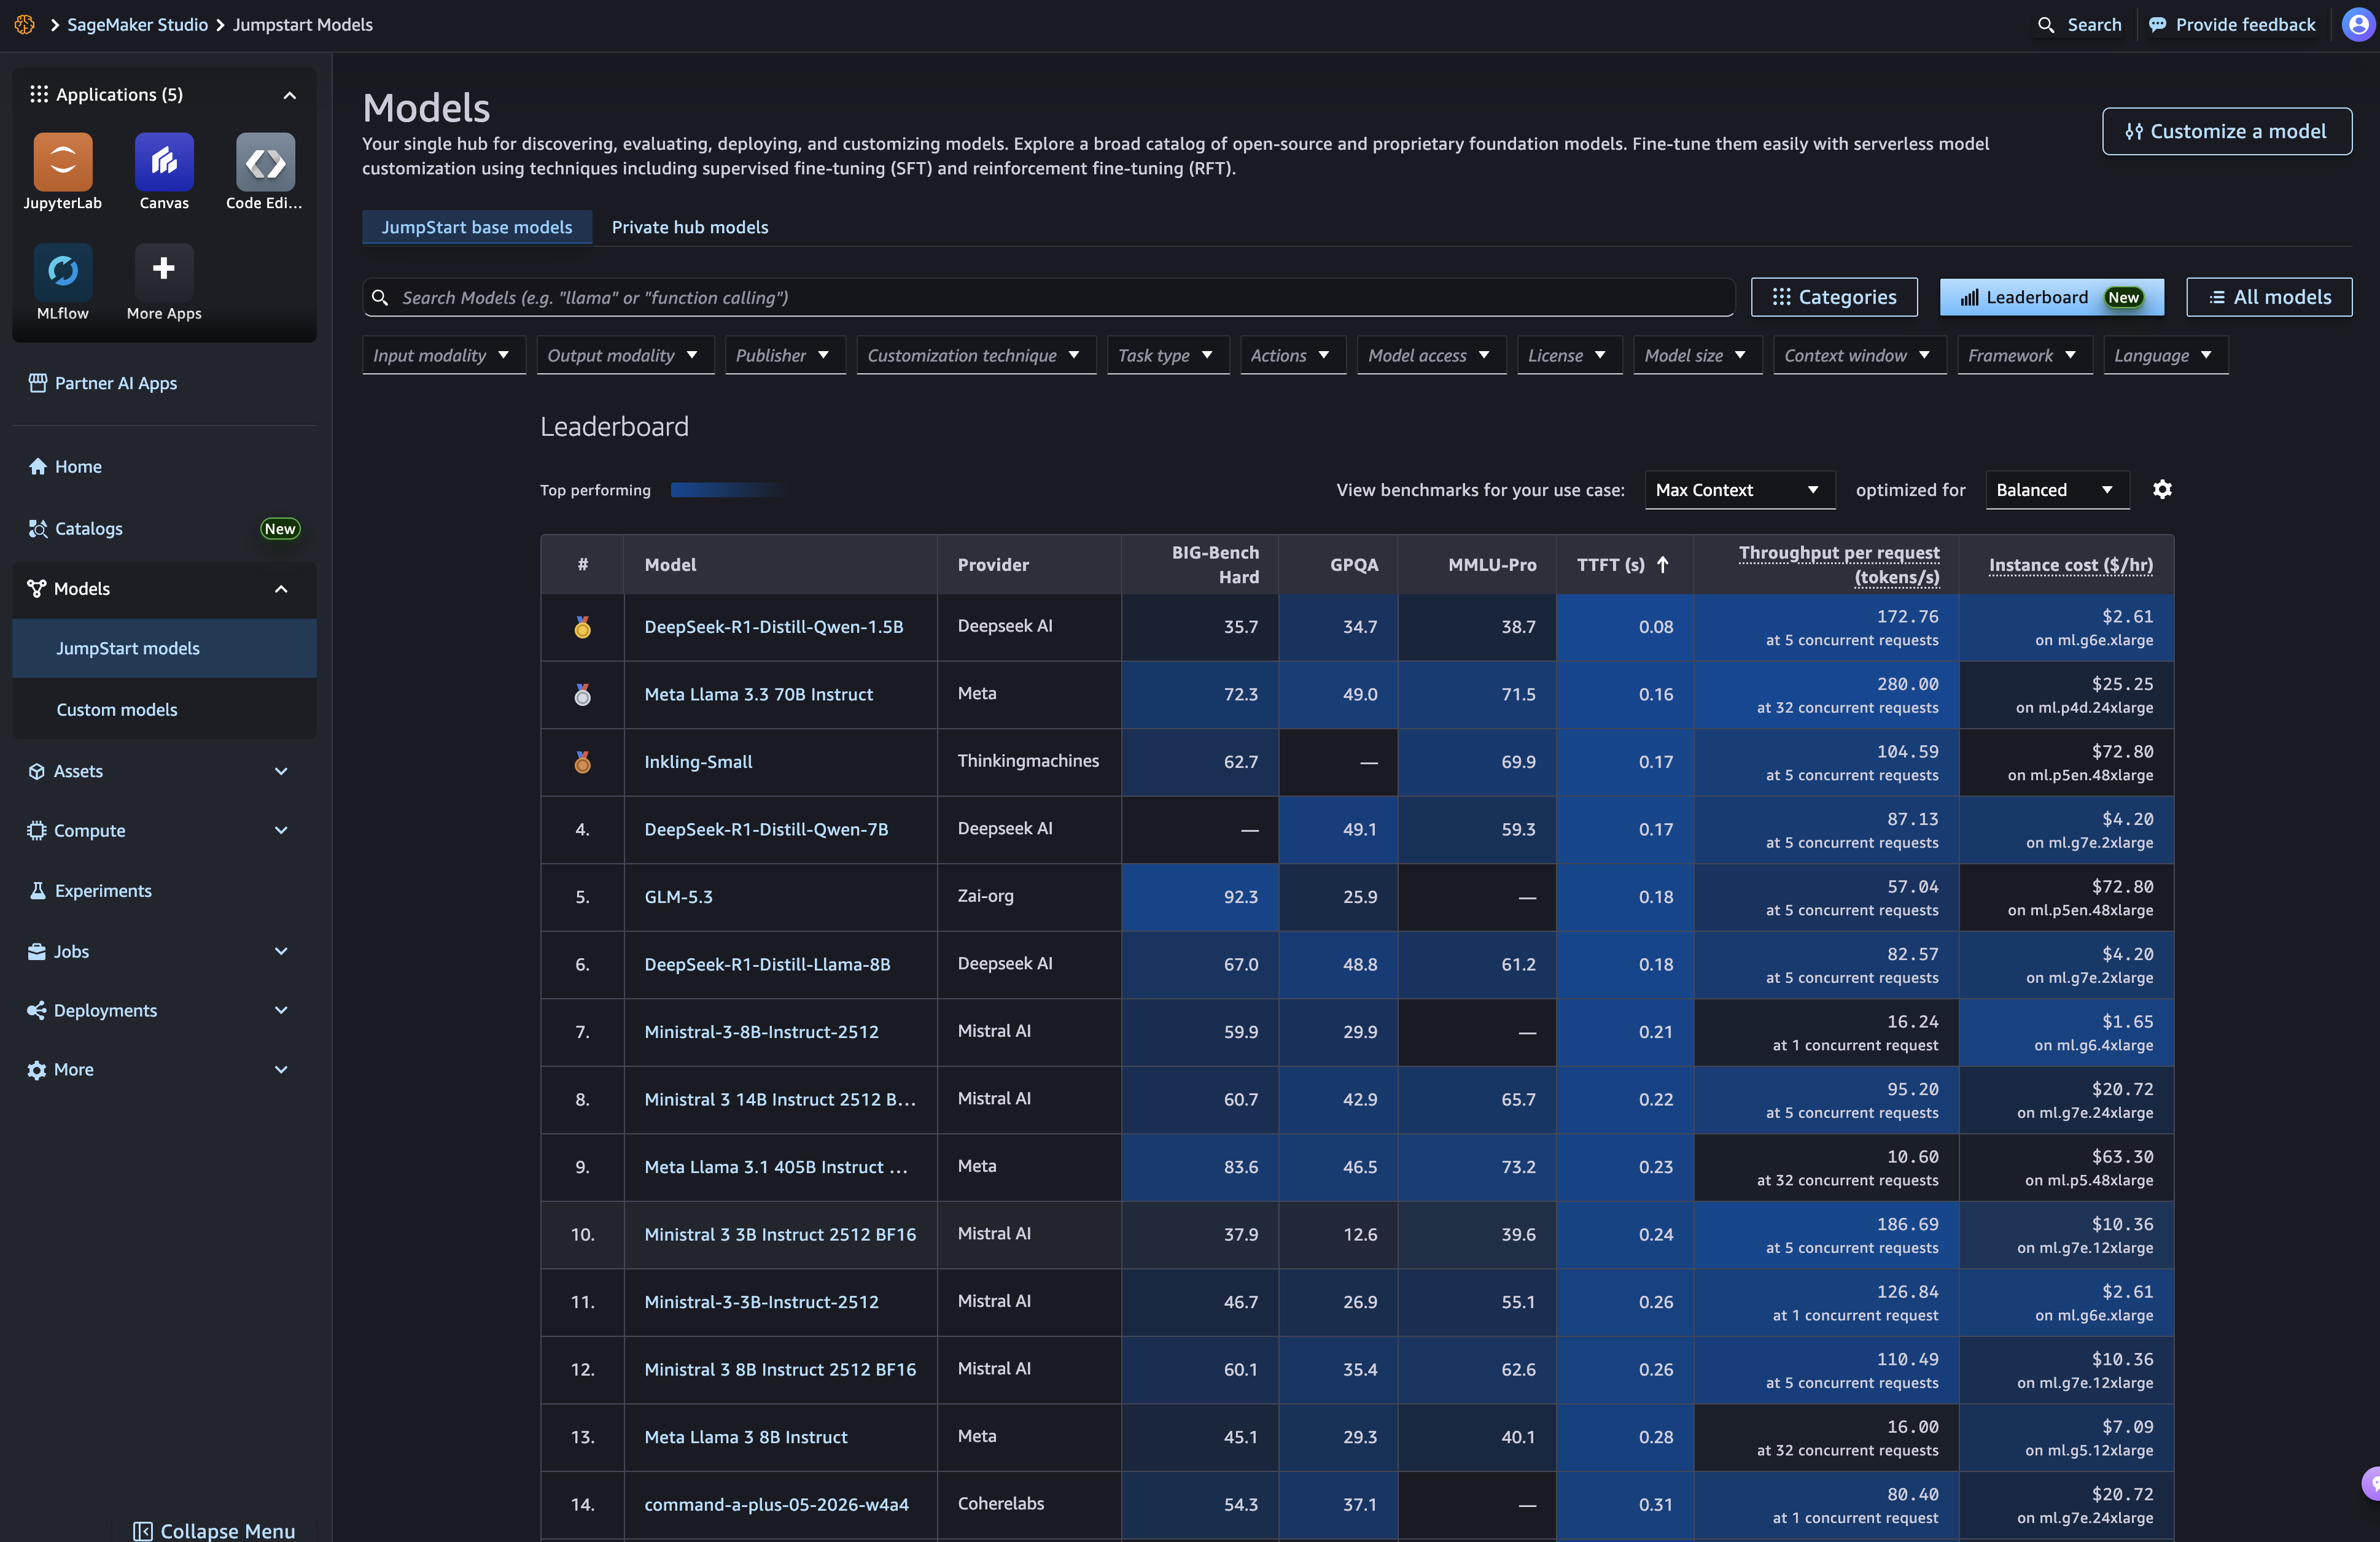
- SageMaker StudioのModelsページにLeaderboardビューを追加。既存の検索・フィルタをそのまま使える
- 品質はBIG-Bench Hard、GPQA Diamond、MMLU-Proの3ベンチマークをAWSが同一設定で実行
- 速度とコストは各デプロイ構成のエンドポイントに標準テスト負荷を送って測定。対象は70以上のモデル
何が発表されたのか
Amazon Web Servicesは、Amazon SageMaker JumpStartの新しい機能として「JumpStart Model Leaderboard」を発表しました。SageMaker StudioのJumpStartベースモデルページに追加された新しいビューで、既存のCategoriesビューやAll modelsビューと並ぶ位置づけになります。ビューを開くと、まず大規模言語モデル(LLM)のリーダーボードが表示され、初期設定の質問に答えなくてもランキングを確認できます。公開時点の対象は、Meta、Google、Qwen、IBM、Arceeなどのプロバイダーが提供する70以上のモデルです。
各モデルについて、リーダーボードは2種類の情報を示します。1つは3つの公開ベンチマーク(BIG-Bench Hard、GPQA Diamond、MMLU-Pro)の品質スコアで、AWS自身がすべてのモデルに同じ評価設定を使って実行しています。もう1つは性能とコストの指標で、JumpStartの各デプロイ構成でエンドポイントを立て、標準化したテスト負荷を送って測定します。数値の出所も測定方法も同じであるため、複数のサイトのデータをつなぎ合わせるのではなく、同一条件での比較ができると説明されています。
品質と性能の測り方
ベンチマークは、固定された設問と既知の答えからなる標準テストです。すべてのモデルに同じテストを実行すれば、比較できるスコアが得られます。今回の3つはいずれも推論能力を測るもので、値が高いほど良い結果を意味します。AWSはこれらを1つの数字に混ぜず、ベンチマークごとに分けて表示します。アプリケーションにとって重要なベンチマークを自分で重み付けし、公開されている定義と照らしてスコアを確認できるようにするためです。
速度とコストはワークロードとデプロイ構成に依存するため、リーダーボード上部の2つのメニューで条件を切り替えます。「View benchmarks for your use case」では用途プロファイルを選び(デフォルトはMax Context)、「Optimized for」では最適化ゴールを選びます(デフォルトはBalanced)。用途プロファイルは性能とコストの指標だけを変え、品質スコアはどのプロファイルでも同じです。
コストの扱いには注意が必要です。推定コストは、その構成のデフォルトインスタンスタイプのオンデマンド時間単価に基づくSageMakerインスタンス費用のみを反映します。データ転送、ストレージ、推論コンポーネントの費用、Reserved InstancesやAWS Savings Plansといった割引は含まれません。実際の請求額は変わるため、見積もりにはAWS Pricing Calculatorを使うよう案内されています。
候補を絞ってデプロイする流れ
利用の手順は、SageMaker StudioのModelsページでLeaderboardビューを開くところから始まります。このビューには専用のURLがあり、ブックマークやチームへの共有が可能です。次に、ライセンス、プロバイダー、入力・出力モダリティといった既存のフィルタで候補を絞ります。スコアを見る前に、商用利用が可能なライセンスなどの必須条件で絞り込むことが推奨されています。その後、用途プロファイルと最適化ゴールを選ぶと、性能とコストの列が更新されます。
各列には青いヒートマップが付いており、色が濃いほどその列での結果が強いことを示します。ベンチマークの列で並べ替えれば、重視する指標でランク付けできます。列設定(歯車アイコン)で不要な指標を隠すこともでき、横スクロール時もモデル名の列は固定されます。モデルを選ぶと詳細ページが開き、デプロイまたは、サーバーレスカスタマイズに対応したモデルであればカスタマイズを選べます。デプロイ時は、リーダーボードで比較したのと同じ用途と最適化ゴールを選ぶことが重要です。指標は測定された構成に対する値であり、構成が変われば品質、レイテンシ、スループット、コストも変わりうるためです。
原文では、社内ヘルプデスク向けアシスタントを例に選定の考え方が示されています。商用ライセンスが必要で、コストを予測しやすい形にしたいという条件で、ライセンスで絞り込み、チャット向けの用途プロファイルとLatency optimizedを選ぶとします。この例では、Model Aは知識スコアが最も高い一方でコストも最も高く、初回応答も最も遅いとされています。Model Bはほぼ同等のスコアで多段推論にも耐え、より小さく安いインスタンスで動くため、ヘルプデスクでは出発点として適しているという判断になります。大きいモデルが常に良い選択ではないことを、この例は示しています。
現時点の制約と注意点
リーダーボードは候補を絞るために使うものであり、最終判断の場ではないとされています。ベンチマークが測るのは一般的な能力であるため、上位2〜3モデルは自社のデータとプロンプトで評価してから本番に進むべきだとしています。比較は同じベンチマーク内で行う必要があり、ベンチマークごとに難易度が異なるため、別のベンチマークのスコアを直接比べることはできません。
モデルの種類にも注意が要ります。推論型と非推論型のモデルは異なる生成パラメータで評価され、推論型モデルのGPQA Diamondのスコアは10回の試行の平均値です。そのため両タイプ間の比較は近似値になります。また、僅差のスコアは実行ごとの通常のばらつきの範囲に収まりうるため、同点として扱い、明確な差があるかを見るべきだとされています。
網羅性にも制約があります。すべてのJumpStartモデルにベンチマークスコアがあるわけではなく、公開時点のベンチマークはLLMを中心としています。スコアがないモデルは性能が弱いのではなく、単にまだ計測されていないだけだと明記されています。
| 最適化ゴール | デフォルト | 原文で示された用途 |
|---|---|---|
| Balanced | はい(デフォルト) | 具体的な用途の記載なし |
| Latency optimized | いいえ | 顧客が対話するチャットボットの出発点 |
| Throughput optimized | いいえ | 夜間のドキュメント処理 |
| Cost optimized | いいえ | 夜間のドキュメント処理 |
Use the leaderboard to build a shortlist, not to make the final call. Benchmarks measure general ability. Always evaluate your top two or three models on your own data and prompts before going to production.
リーダーボードは候補を絞るために使い、最終判断の場にしないでください。ベンチマークは一般的な能力を測るものです。本番投入の前に、上位2〜3モデルは必ず自社のデータとプロンプトで評価してください。
今後の見通し
今後は、キュレーションされたJumpStartプライベートハブを利用する組織向けのプライベートハブ対応、LLMのテキスト生成以外のタスク別リーダーボード(物体検出、テキスト埋め込み、画像理解)、モデルとベンチマークの追加が検討されているとしています。日本企業にとっては、自社が利用するリージョンでいつ使えるようになるか、プライベートハブ対応がいつ入るかが分かれば判断しやすくなります。また、スコアの更新頻度や性能測定に使われたテスト負荷の内容が公開されれば、自社ワークロードとの近さをより精度高く見積もれるとみられます。
日本の開発者・IT企業にとっての意味
日本のIT企業や開発者にとっては、モデル選定の初動コストが下がる可能性があります。これまではモデルカードを1つずつ読み、出典も条件も異なるベンチマーク値を突き合わせたうえで、自社ユースケースでの速度やコストを推測する必要がありました。リーダーボードは、ライセンスや入出力モダリティで絞り込んだうえで、用途と最適化ゴールを指定した同一条件の比較を数クリックで得られる点に意味があります。社内稟議や技術選定の初期段階で、候補を絞る根拠として使いやすいでしょう。一方で、推定コストはインスタンス費用のみで割引や周辺費用を含まないため、予算試算には別途見積もりが必要です。また、最終判断には自社データでの評価が求められる点は変わりません。
気になる点
- 日本リージョンのSageMaker Studioでも使えるのか
- 原文には提供リージョンに関する記載がないため、現時点では公表されていません。利用にはSageMaker Studioへのアクセスと、JumpStartモデルをデプロイする権限が必要とされています。対応リージョンは今後のアップデートで確認する必要があります。
- 表示される推定コストはそのまま請求額になるのか
- いいえ。推定コストはSageMakerインスタンスのオンデマンド時間単価のみで、データ転送、ストレージ、推論コンポーネントの費用、Reserved InstancesやSavings Plansの割引は含まれません。見積もりにはAWS Pricing Calculatorの利用が案内されています。
- スコアが表示されないモデルは避けるべきなのか
- いいえ。スコアがないのは単に未計測であるという意味で、弱いモデルだということではありません。公開時点のベンチマークはLLM中心で、対応するモデルやベンチマークは順次追加されていくとしています。
用語解説
- オープンウェイトモデル
- 重み(パラメータ)が公開されている基盤モデル。自社環境にデプロイして利用できる。
- ベンチマーク
- 固定の設問と正解からなる標準テスト。同じ条件で実行して比較可能なスコアを得る。
- エンドポイント
- モデルをデプロイし、推論リクエストを受け付ける窓口。
- レイテンシ
- リクエストを送ってから応答が返るまでの遅延。対話用途で特に重視される。
- スループット
- 単位時間あたりに処理できるリクエストやトークンの量。
- プライベートハブ
- 組織が承認したモデルをキュレーションして共有するJumpStartの仕組み。
出典
Introducing the Amazon SageMaker JumpStart Model Leaderboard
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する