- Agent Toolkit for AWSに分散KVキャッシュのスキルが追加され、KiroやClaude Codeから設定できる
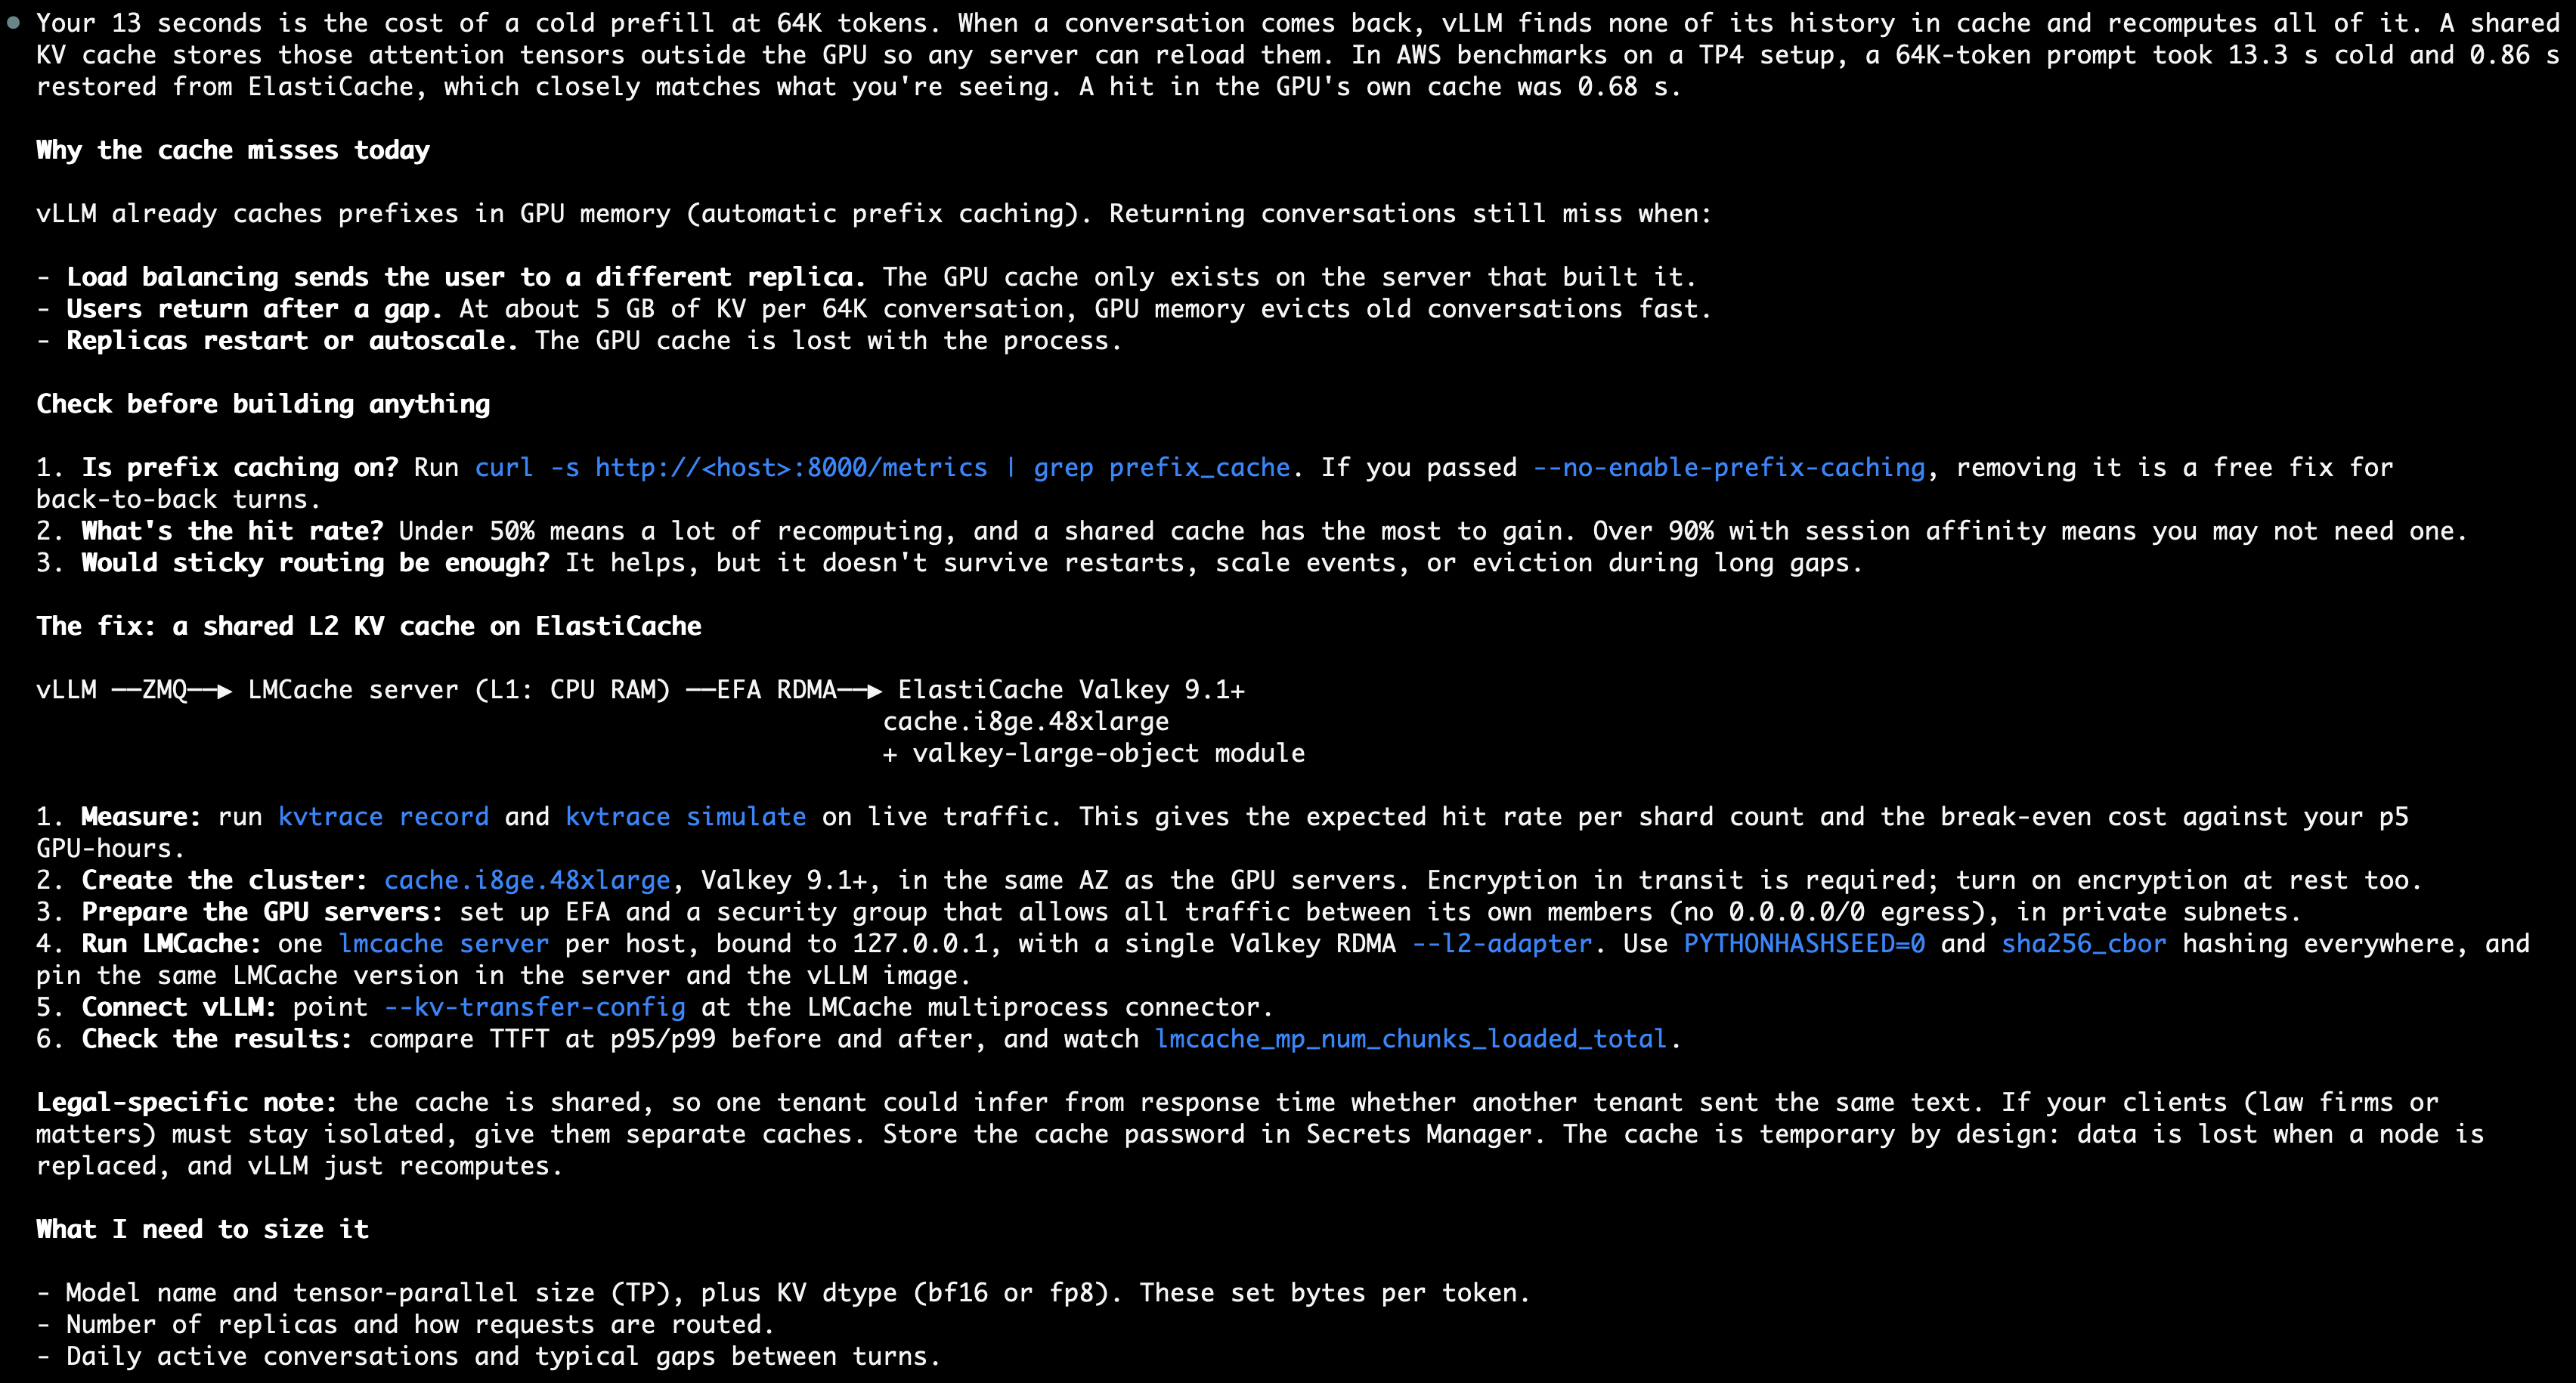
- ElastiCache for Valkeyを共有層に使い、GPU間でKV状態を再利用してプレフィルを削減する
- AWSは推論コスト最大40%減、初回トークンまでの時間最大80%短縮としている
公開されたスキル
AWSは2026年11月21日のブログで、「Agent Toolkit for AWS」に分散KVキャッシュ用のスキルを追加したと発表した。スキルは、コーディングエージェント(コード生成や環境操作を支援するAIエージェント)から数回のプロンプト操作で、自社ホスティングLLMのキャッシュ構成を評価・設定できるようにするものだ。Kiro、Claude Code、OpenAI Codexなど、Agent Skillsに対応するエージェントで動作するとされている。
ブログでは、このスキルを4つの対話例で紹介している。1つ目は初回トークンが遅い原因の診断、2つ目はキャッシュのサイジングと価格の見積もり、3つ目は実際のセットアップ、4つ目はデータ転送失敗時のトラブルシューティングである。診断では、既存設定の見直しで解決できる可能性(プレフィックスキャッシュの再有効化など)を先に確認し、共有キャッシュが本当に必要かを判断する流れになっている。
仕組みと新しさ
LLMは会話を続けるとき、過去の文脈に対応するKV(キー・バリュー)注意状態を毎回計算し直す。この処理はプレフィルと呼ばれ、文脈が長いほど時間がかかる。原文では、数十万トークンの案件履歴を抱える法務アシスタントの例が挙げられている。64Kトークンの文脈をp5インスタンスで扱う場合、再開した会話の初回トークンに13秒かかるという。
分散KVキャッシュは、各GPUサーバ内の小さなローカルキャッシュを、GPUフリートの隣に置いた共有層で拡張する。ブログの構成ではAmazon ElastiCache for Valkeyがその共有層を担い、LMCacheのコネクタを既存のvLLMやSGLangに追加する。llm-dやRay Serve配下のvLLMワーカーも対象になる。転送にはEFA RDMA(低遅延のネットワーク転送)を使う。
設定面では、推論サーバ群のKV ID機構(ハッシュとシード)とKVデータ型を揃えることが重要とされる。揃っていないと、あるサーバが書き込んだKV状態を他のサーバが見つけられない「キー不一致」が起きるためだ。
効果の見積もり方
効果はモデルやトラフィック、プロンプトのルーティングによって変わり、見積もりは複雑になりやすい。AWSは追加料金なしで使えるKVTraceを用意しており、デプロイ前に自社のモデルとトラフィックから効果を推定できるとする。KVTraceはvLLMやSGLangのKVイベントを記録し、候補となる容量ごとの共有KVキャッシュに対してオフラインで再生する。記録されるのはブロックハッシュとトークン数で、トークンIDやプロンプト本文は書き込まないと説明されている。
短いプロンプトでは、KV状態を読み込むより再計算した方が速い場合がある。ある長さ(カットオーバー点)を超えると読み込みが有利になり、その位置とプロンプトの繰り返し頻度が費用対効果を左右する。
ブログの例では、64,000トークンのプロンプトを扱うマルチターンRAGアシスタント向けに8台のp5インスタンスがある構成で、エージェントはcache.i8ge.48xlargeを2ノード推奨した。ヒット率(再計算されるトークンのうちキャッシュが応える割合)は与えられていないため、エージェントは複数シナリオを示し、KVTraceの実行を勧めている。KVTraceは節約上限の90%に達する最小容量を推奨する。
注意点と前提条件
共有キャッシュにはテナント分離の論点がある。原文は、共有KVキャッシュがあると、あるテナントが応答時間から別のテナントが同じテキストを送ったかどうかを推測でき得ると指摘する。分離が必要な案件は別々のキャッシュにし、共有するテナントはKVハッシュに自テナントのIDを加えるとしている。
設定の不一致は、ヒットカウンタが正常に見えても誤った回答を生むことがある。そのため本番トラフィックの前にローカル層を空にし、キャッシュ経由の実行を2回行って同じ出力になるか確認する手順が組み込まれている。作成・変更・削除のような影響の大きい操作では、明示的な承認を求める。
前提として、Agent Skills対応のコーディングエージェント、EFA RDMA書き込みに対応したGPUインスタンス(p5など)、LMCache 0.5.8rc1以降とvLLM 0.11.1以降(SGLang 0.5.13以降)、キャッシュを立てる場合はElastiCache for Valkey 9.1以降とcache.i8ge.48xlargeノードが挙げられている。
| 項目 | GPUローカルKVキャッシュ | 分散KVキャッシュ(ElastiCache) |
|---|---|---|
| キャッシュの保持範囲 | 各サーバ内の小さなキャッシュに限られ、サーバ間で共有できない | GPUフリート横の共有層に置き、セッションやルーティング変更、サーバ障害をまたいで数日間再利用できる |
| 推論コスト・遅延への効果 | 原文に記載なし | 自社ホスティングLLMの推論コストを最大40%、TTFTを最大80%削減 |
| 必要な構成 | 各GPUサーバ内で完結 | ElastiCache for Valkey 9.1以降(cache.i8ge.48xlarge)とLMCache |
Distributed KV caching with Amazon ElastiCache can cut self-hosted LLM inference costs by up to 40% and time to first token (TTFT) by up to 80%.
Amazon ElastiCacheを用いた分散KVキャッシュは、自社ホスティングLLMの推論コストを最大40%、初回トークンまでの時間(TTFT)を最大80%削減できる。
今後の見通し
今回のブログはスキルの使い方を4つの対話例で示したもので、実運用でのヒット率やリージョンごとの提供状況、日本語ワークロードでの傾向は示されていない。次に判断材料になるのは、KVTraceを自社トラフィックで実行した結果と、ElastiCache for Valkey 9.1以降およびcache.i8ge.48xlargeを利用できるリージョン、実際の請求額とTTFTの変化とみられる。ヒット率が低い場合や、プロンプトが短くカットオーバー点を下回る場合には、共有キャッシュの費用対効果は小さくなると考えられる。
日本の開発者・IT企業にとっての意味
GPUを自前で調達してLLMを運用する日本企業にとって、GPU時間の重複計算はそのままコストになる。法務・問い合わせ・コード支援のように会話履歴が長くなる業務アプリでは、再開時の待ち時間が使い勝手を大きく損なうため、TTFTの短縮は効果を測りやすい指標になる。すでにElastiCacheやValkeyを運用している企業は、同じAWSアカウント内に共有キャッシュ層を足せる点が現実的な選択肢になる。一方で、テナント分離の設計やKV ID設定の統一など、導入前に決めるべき事項がある。まずKVTraceで自社トラフィックのヒット率を見積もり、削減額がキャッシュの費用を上回るかを確認する進め方が現実的とみられる。
気になる点
- 自社環境で試すには何が必要ですか
- Agent Skills対応のコーディングエージェント(KiroやClaude Codeなど)、EFA RDMA書き込みに対応したGPUインスタンス(p5など)、LMCache 0.5.8rc1以降とvLLM 0.11.1以降(SGLang 0.5.13以降)が挙げられています。キャッシュを立てる場合はElastiCache for Valkey 9.1以降とcache.i8ge.48xlargeノードが必要です。
- いくらかかりますか
- 原文に具体的な金額は記載されていません。スキルはAWSの価格リストからGPUとキャッシュノードの価格を調べて見積もりに使うとされ、KVTraceの利用は追加料金なしとされています。実際のコストはヒット率とノード数で変わるため、自社トラフィックでの試算が必要です。
- 導入前に効果を確認できますか
- KVTraceを使うと、インフラを構築する前に自社のモデルとトラフィックから削減効果を推定できるとされています。短いプロンプトではKV状態の読み込みが再計算より遅い場合があり、カットオーバー点を超えると読み込みが有利になると説明されています。
用語解説
- KVキャッシュ
- 生成時に計算した注意機構のキーと値の状態を保持し、同じ文脈の再計算を省く仕組み。
- プレフィル(prefill)
- 入力トークン全体についてKV状態を計算する前処理段階。文脈が長いほど時間がかかる。
- TTFT
- time to first token。リクエストから最初のトークンが返るまでの時間で、体感速度に直結する。
- LMCache
- KVキャッシュをGPU外の共有層に置くためのコンポーネント。vLLMやSGLangと組み合わせて使う。
- vLLM / SGLang
- LLM推論用のサーバソフトウェア。スループットやメモリ効率を重視した実装として知られる。
- EFA / RDMA
- Elastic Fabric Adapter。AWSのネットワークインターフェースで、RDMAによりノード間転送を低遅延で行う。
出典
Cut self-hosted LLM cost and latency with the distributed KV caching agent skill
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する