- PDFやExcelなど多様な文書をTextractで前処理し、Bedrockの知識ベースに取り込む構成
- 生の文書をRAGに使うと情報欠落や幻覚、形式ごとの性能差が生じる問題を指摘
- サンプルコードをGitHubで公開し、CloudFormationで一括デプロイする手順を解説
発表された内容
AWSは、Amazon Bedrockのナレッジベースを活用し、大規模で複雑な文書を扱うためのカスタムソリューションを紹介する記事を公開しました。この記事は、文書から構造化・非構造化コンテンツを高精度に抽出するAmazon Textractと、生成AI機能を備えたAmazon Bedrockを組み合わせるものです。サンプルコードはGitHubで公開されており、誰でも構成を試せるようになっています。
具体例として想定されているのは、毎月数千件の公共料金明細を扱うカスタマーサービスのチームです。明細書にはPDFをはじめ、DOCX、TXT、HTML、XLSXなど異なる形式が混在し、表やレイアウトも複雑なため、人手での確認には限界があるとしています。これをRAGで自動化しようとしたものの、生の文書をそのまま読み込むだけでは精度が出なかったというのが出発点です。
単純なRAGの限界
顧客企業が最初に試したのは、公共料金明細をそのままRAGのモデルに読み込む方法でした。しかし、LLMが口座番号、期日、支払額などの重要な情報を見落とすケースが発生します。また、モデルが誤った情報や無関係な情報を生成する幻覚を起こすこともありました。PDF、DOCX、TXT、HTML、XLSXなど形式が異なることでも性能は不安定になったと記されています。
このことから、文書を単純に読み込むだけでは信頼性の高い回答は得られないと結論づけています。必要なのは、LLMに入力する前に文書を適切に下処理し、情報を整理する仕組みです。その解決策として導入したのが、Amazon Textractによる文書解析の前処理です。
Textract連携の仕組み
Amazon Textractは、複数ページのPDFや埋め込み画像を含む文書からテキストを抽出できます。このソリューションでは、抽出したデータからノイズや不要な情報を取り除くクリーニングとエンリッチメントを行い、文脈を理解してデータにラベルやタグを付与します。これにより、LLMが処理しやすくなり、より正確な情報抽出が可能になるとしています。
処理の流れは次のとおりです。ユーザーがS3バケット内の「raw_files」フォルダに文書をアップロードすると、ファイルアップロードをトリガーに「document-parser」Lambda関数が起動します。次に、Amazon Textractジョブが元ファイルを処理し、処理済みファイルが「parsed_files」フォルダに保存されます。その後、2番目のLambda関数がファイルをTXT形式に変換し、最終的な出力が「parsed_kb_documents」フォルダに置かれます。最後に、Bedrockの知識ベースがこのデータを同期して参照できるようにします。
デプロイ手順
デプロイには、AWS CloudFormationのスタックを作成するシェルスクリプトが用意されています。GitHubからリポジトリをクローンし、「custom-knowledge-base」ディレクトリに移動して「bash custom_kb_deployment_setup.sh」を実行すると、CloudFormationスタックが作成されます。このスタックにより、Lambda実行ロール、Lambdaレイヤー、2つのLambda関数、S3バケット、Amazon OpenSearch Serverlessクラスター、Bedrock Knowledge Bases、IAMロールなどが自動的に構築されます。
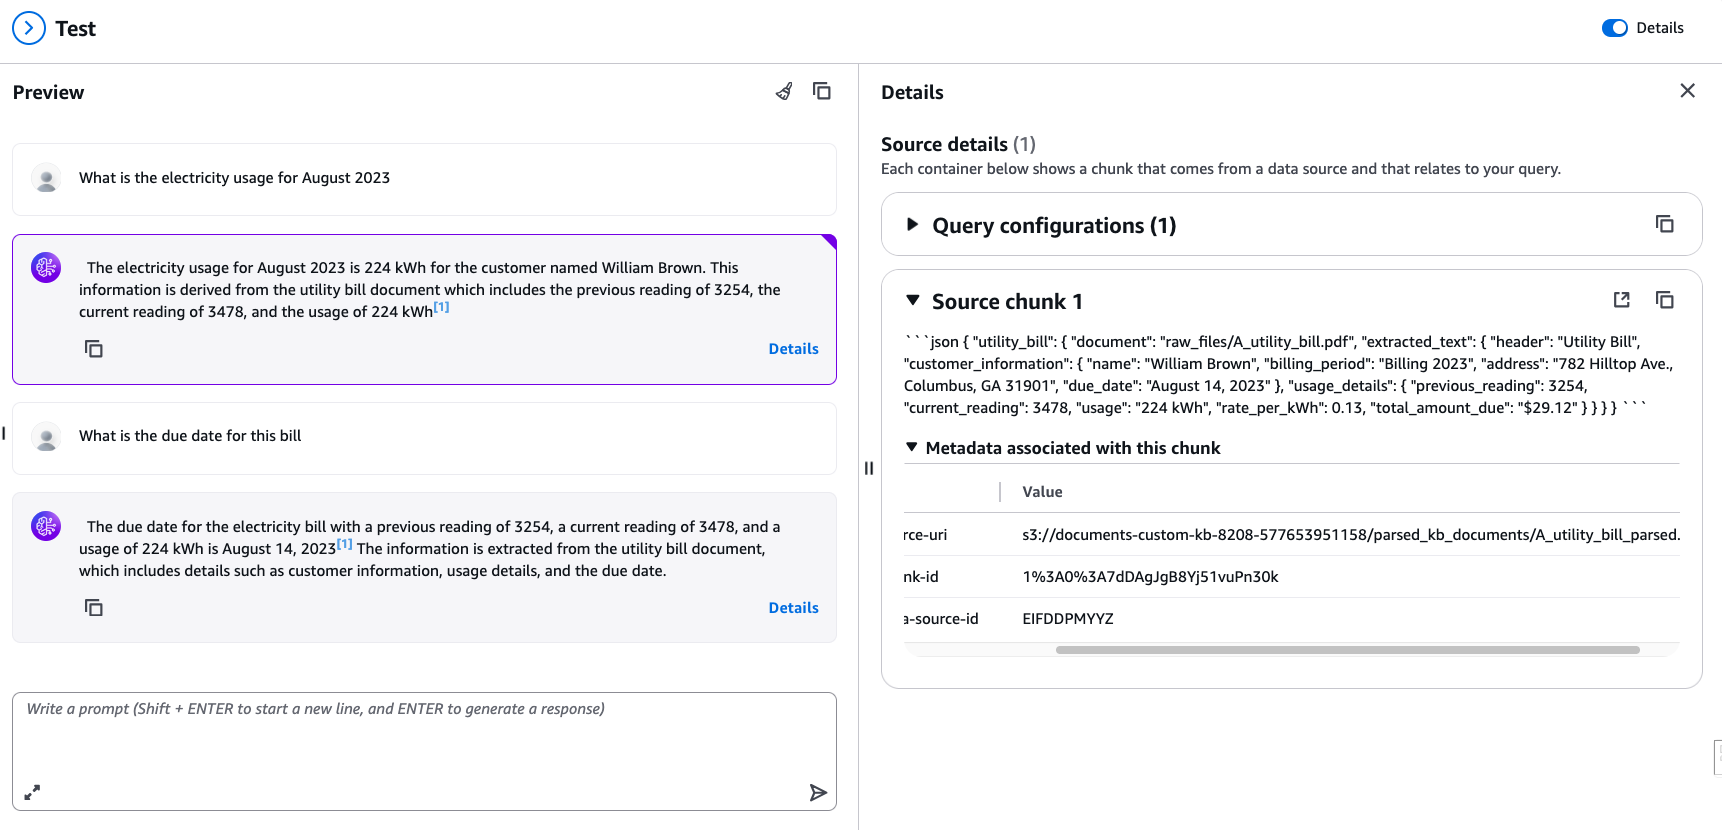
スタック作成後は、S3コンソールから「document-<スタック名>-<ID>」というバケットを開き、「raw_files」フォルダを作成してサンプルの公共料金明細をアップロードします。次に、BedrockコンソールのKnowledge Basesで新しく作成した知識ベースを選択し、データソースのSyncを実行します。動作確認ではText Knowledge Baseを選び、設定でAmazon Nova Microモデルを選択して、明細書に関する質問を入力するという手順になっています。
本番導入の注意点
AWSは、本番環境でRAGを運用する際に、Amazon Bedrock Guardrailsやグラウンディング検証の有効化を推奨しています。Guardrailsは、有害なコンテンツのフィルタリングや、許可されていないトピックのブロック、機密情報の編集を行うための設定です。グラウンディング検証は、モデルの回答が参照元の文書で裏付けられているかを確認し、幻覚の検出・低減に役立てられます。
一方で、このソリューションは出発点となるサンプルであり、用途に応じたカスタマイズが必要になることも記事では示唆されています。対応するファイル形式はPDF、DOCX、TXT、HTML、XLSX、PNGですが、実際の業務文書の種類によっては追加の処理を検討する必要があるとみられます。また、記事ではAmazon Nova Microなどのモデルが利用できるAWSリージョンが異なるため、事前にドキュメントで確認するよう案内されています。
| 項目 | 文書を直接読み込むRAG | Textract統合RAG |
|---|---|---|
| 情報抽出 | 重要な情報を見落としやすい | Amazon Textractが文書を解析し、必要な情報を補える |
| 回答の信頼性 | 幻覚で誤った情報を回答することがある | クリーニングと文脈理解で誤回答の低減を目指す |
| 文書形式への対応 | 形式によって性能が不安定になる | PDF・DOCX・TXT・HTML・XLSX・PNGを処理する |
The large language model (LLM) used to extract information from these documents was missing key details and, in some cases, hallucinating and providing incorrect or irrelevant information.
これらの文書から情報を抽出するために使われた大規模言語モデル(LLM)は、重要な詳細を見落とし、場合によっては幻覚を起こして誤った、または無関係な情報を提供することがありました。
今後の見通し
AWSのブログは、将来の拡張アイデアとして文書タイプの拡大、他のAWSサービスとの連携、フロントエンドの開発を挙げています。現時点では、Amazon Nova Microが利用可能なリージョンや、Textractの抽出精度が文書形式によってどう変わるかは、実際に試用しながら評価する必要があるとみられます。次の判断材料としては、このサンプルコードが更新されて対応文書形式が増えるかどうか、RAGの回答精度を定量的に評価する仕組みが示されるかどうかが考えられます。それらが明らかになれば、本番導入への適用可否をより判断しやすくなるでしょう。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっては、請求書や契約書など形式が統一されていない複雑な文書を扱うRAG構築の参考事例になるでしょう。ポイントは、文書をそのまま知識ベースに取り込むのではなく、Amazon Textractによる前処理、クリーニング、タグ付けを挟む点にあります。この前処理の有無が情報抽出の精度に影響するという問題は、日本語文書でも同様に起こり得るとみられます。また、S3へのアップロードからLambdaを経由して知識ベースを同期するまでの処理が自動化されており、既存のAWS環境を持つ企業はデプロイの型として応用しやすいです。実際に試す際は、Amazon Nova Microのモデルが利用できるリージョンと、本番運用で有効化すべきGuardrailsやグラウンディング検証の設定を確認してください。
気になる点
- どのファイル形式に対応していますか。
- 現時点ではPDF、DOCX、TXT、HTML、XLSX、PNGの6形式がサポートされています。Amazon Textractが複数ページのPDFやWordの表・画像などからテキストを抽出し、Excelのセルや表データにも対応します。
- デプロイには何が必要ですか。
- AWSアカウントとGitHubから取得するコードが必要です。シェルスクリプトを実行するとCloudFormationが、Lambda実行ロールやLambda関数2つ、S3バケット、OpenSearch Serverlessクラスター、Bedrock Knowledge Bases、IAMロールなどを作成します。コンソールでの同期設定まで進めれば動作確認できます。
- 利用料金はどのくらいかかりますか。
- ブログ記事には具体的な料金は記載されていません。Amazon Bedrock、Amazon Textract、Amazon S3などの利用量に応じて課金されるため、実際にかかるコストはAWSの料金情報を確認して見積もる必要があります。
用語解説
- RAG
- Retrieval-Augmented Generation(検索拡張生成)。外部の文書を検索し、その結果をもとにLLMが回答を生成する技術。
- Amazon Textract
- 機械学習を使い、PDFや画像から文字、表、フォームを抽出するAWSのサービス。
- Amazon Bedrock Knowledge Bases
- Bedrock上でRAGを構築するためのフルマネージド機能。データソースの同期やベクトル検索を提供する。
- Amazon Nova Micro
- Amazon Bedrockで利用できるテキスト生成モデルの1つ。記事の検証ではText Knowledge Baseで選択されている。
- 幻覚(ハルシネーション)
- 大規模言語モデルが、事実に基づかない内容をあたかも正しいかのように生成してしまう現象。
- AWS CloudFormation
- AWSのインフラ構成をコードで定義し、一括作成・更新できるサービス。
出典
Customizing your knowledge base on Amazon Bedrock for large and complex documents using Amazon Textract
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する