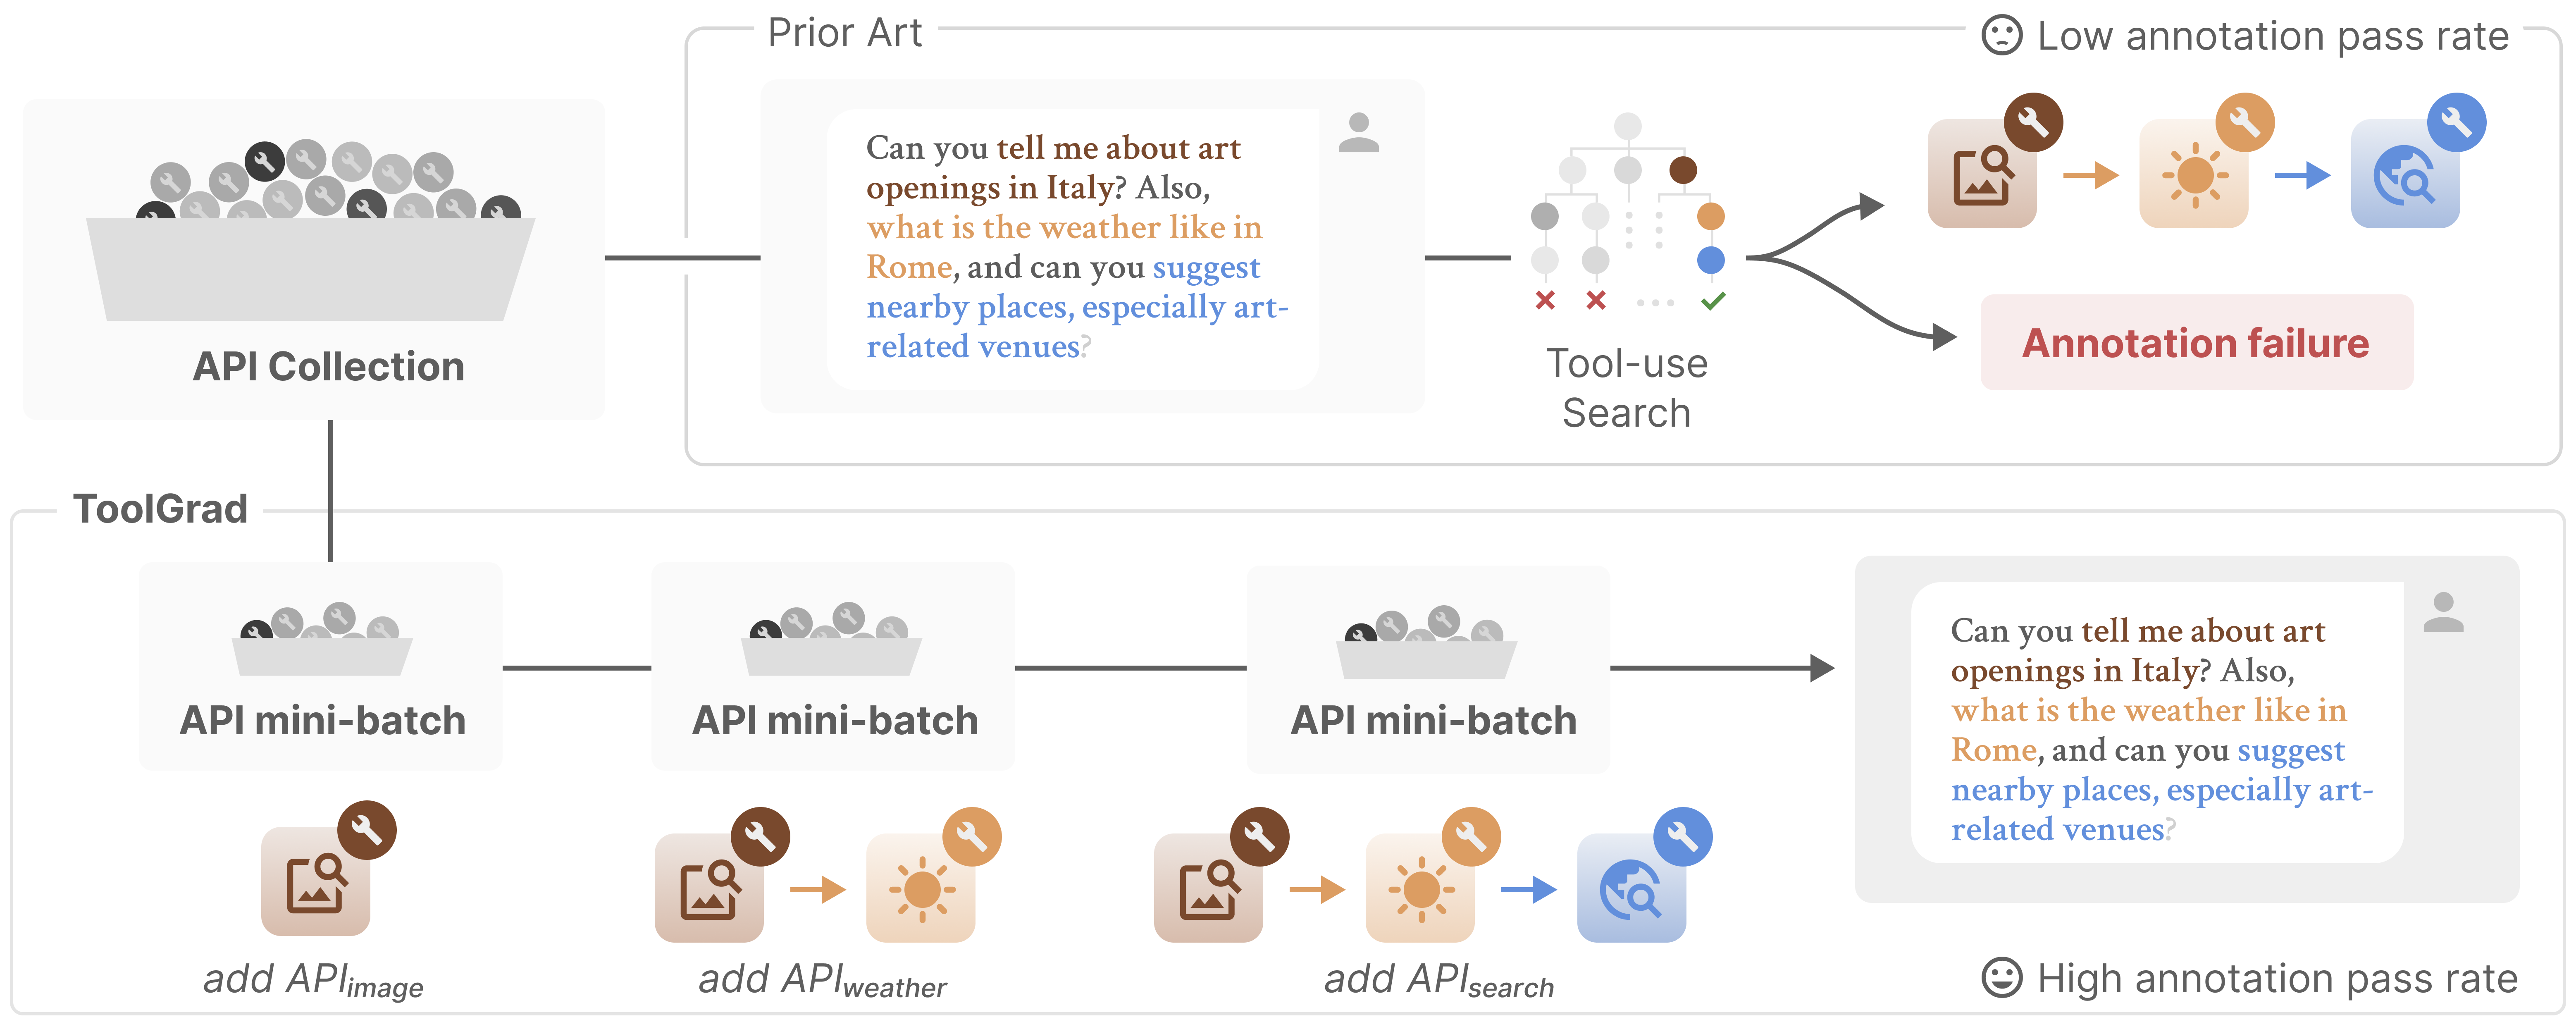
- ツール利用の解答を先に作り質問文を後から生成する「answer-first」方式を採用
- API提案・実行・選択・更新の4モジュールで反復的にワークフローを構築
- ToolGrad-12BがBFCLで83.1を記録し、主要な商用モデルと同等の水準に到達
何が発表されたのか
Google Researchは2026年9月10日、LLM(大規模言語モデル)にツール利用を教えるためのデータセットを効率的に生成するフレームワーク「ToolGrad」を発表しました。論文はACL 2026で発表されたもので、著者はZhongyi Zhou氏とRuofei Du氏です。AIエージェントが検索やファイル操作、Pythonスクリプトの実行といった実世界のタスクを自動化するには、LLMがツールを正しく使うことを学習する必要があります。
ToolGradの最大の特徴は、従来とは逆の順序を採用している点です。ユーザーの質問を先に作り、それに対するツール利用の解答を探索するのではなく、まず正解となるツール利用の連鎖(ツール呼び出しの並び)を生成し、その後にそれに対応するユーザーの質問文を生成します。研究チームは、明示的なツール利用の解答のほうが質問文より曖昧さが少なく、注釈付けが1回のLLMステップで済むと説明しています。
テキスト勾配による反復生成
ToolGradは、プロンプト最適化手法「TextGrad」で使われる「テキスト勾配」という考え方を、合成データセットの生成に応用しています。機械学習では通常、数値の損失勾配を使ってモデルの重みを更新しますが、TextGradはその代わりにLLMの批評役が自然言語で改善フィードバックを与えます。このフィードバックを「テキスト勾配」と呼び、ToolGradはこれを静的なプロンプトの改善ではなく、大規模なツールライブラリからの妥当なAPIワークフローの構築に使います。
フレームワークは4つのモジュールで構成されます。API Proposerは候補のAPIを絞り込み、API Executorsは選ばれたAPIを並列で試して実行レポートを作ります。API Selectorはそのレポートを確認して最も良いAPI呼び出しを1つ選び、これをテキスト勾配としてワークフローに追加します。最後にLLM Updaterが新しいAPI群に合わせてユーザークエリとAI応答を書き直します。この反復により、ユーザークエリ・検証済みAPIワークフロー・最終AI応答からなるデータサンプルが生成されます。
BFCLでの評価結果
研究チームはToolBenchの16k+の実世界APIをデータベースとして使い、小規模データセット「ToolGrad-500」を生成しました。これをGemma-3(1B・4B・12B)のファインチューニングに用い、それぞれToolGrad-1B、ToolGrad-4B、ToolGrad-12Bと呼んでいます。評価には、ToolBenchとは異なるツールセットを持つベンチマーク「Berkeley Function Calling Leaderboard(BFCL)」が使われました。
ToolGrad-12BはBFCLで83.1を記録し、gemini-2.5-proの83.2、claude-4.5 Opusの82.8、gpt-5の74.4と競合する結果となりました。また、ToolGrad-500はgemini-2.5-flash-liteで生成されていますが、そのデータで学習したGemma-3-12Bが元の「教師モデル」を上回るという自己進化(セルフ・エボルビング)的な挙動も確認されています。
位置づけと今後の課題
従来のquery-first手法は、仮のユーザー指示を生成したうえで深さ優先探索(DFS)エージェントに解答を探させる2段階の手順を取るため、複雑なエージェント探索から価値ある軌跡を抽出するという設計上、非効率になりがちでした。ToolGradはanswer-firstにすることで、より複雑な長手順のツール利用データを低コストかつ高い成功率で生成できるとしています。オープンソースのツール利用特化モデルであるToolACEやHammer-2.1-7Bと比べても優位だと報告されています。
一方、原文にはデータセットや学習済みモデルの公開方針についての記載はありません。また、実験はToolBenchとBFCLという特定のベンチマークに基づくもので、企業独自のAPI群や日本語環境での有効性は示されていません。今後の方向性として、より動的で大規模なAPIエコシステムへの拡張や、パーソナライズのための継続的なオンザフライ学習の探索が挙げられています。
| モデル | BFCLスコア | 位置づけ |
|---|---|---|
| ToolGrad-12B | 83.1 | Gemma-3-12Bのファインチューニング |
| gemini-2.5-pro | 83.2 | 商用モデル |
| claude-4.5 Opus | 82.8 | 商用モデル |
| gpt-5 | 74.4 | 商用モデル |
Interestingly, we find Gemma-3-12B fine-tuned on data generated by gemini-2.5-flash-lite can outperform its original "teacher model".
興味深いことに、gemini-2.5-flash-liteが生成したデータでファインチューニングしたGemma-3-12Bは、元の「教師モデル」を上回ることができると分かりました。
今後の見通し
研究チームは今後、より動的で大規模なAPIエコシステムへフレームワークを拡張することを挙げています。また、自己進化の能力を応用し、時間の経過に合わせてパーソナライズするための継続的なオンザフライ学習も検討課題とされています。実務にどう影響するかを見極めるには、生成したデータセットや学習済みモデルが公開されるかどうか、また企業独自のAPI群や日本語のツール呼び出しで同等の成功率とスコアが得られるかが明らかになる必要があるとみられます。原文にはこれらの検証結果はまだ含まれていません。
日本の開発者・IT企業にとっての意味
LLMエージェントを業務システムに組み込む際、多くの開発者は「自社ツールを正しく呼び出せるか」というデータ整備の壁に直面します。人手による注釈付けはスケールせず、探索ベースの自動生成は失敗が多くコストがかさむというのが従来の構図でした。ToolGradは解答を先に作るという順序の反転だけで成功率をほぼ100%まで引き上げ、12B規模の比較的小さなモデルでも商用モデルに迫る性能を出せると報告しています。自社環境で動かせる小型モデルにツール利用を学習させたい企業にとっては、データ生成コストを下げられる可能性を示す事例です。ただし原文の検証は英語の公開ベンチマークに限られ、社内APIや日本語の指示での再現性は示されていません。導入判断には、公開状況と自社データでの追試が欠かせないと考えられます。
気になる点
- ToolGrad-500データセットや学習済みモデルは公開されていますか?
- 原文には公開の有無やライセンスについての記載がなく、現時点では公表されていないとみられます。利用可能性は不明です。ただしベースモデルとして使われたGemma-3はGoogleが公開しているモデルで、ファインチューニングの対象として言及されています。
- BFCLのスコア83.1は実務でどんな意味がありますか?
- BFCLは関数(ツール)呼び出しの正確さを測るベンチマークで、エージェントの信頼性を測る目安のひとつです。ただし特定のベンチマーク上の比較であり、実際の業務システムでの性能を保証するものではありません。原文の主張もこのベンチマーク上の結果にとどまります。
- 自社が持つ独自のAPI群でも同じようにデータ生成できますか?
- 原文で示されている検証はToolBenchの16k+の実世界APIを使ったもので、企業独自のAPI群にそのまま適用できるかは示されていません。フレームワークは大規模なツールライブラリを想定した設計ですが、適用範囲の拡大は今後の課題として挙げられています。
用語解説
- LLM
- 大規模言語モデル。大量のテキストで学習し、文章生成や推論を行うAIモデル。
- ファインチューニング
- 学習済みモデルに追加データで再学習させ、特定タスクの性能を高める手法。
- BFCL
- Berkeley Function Calling Leaderboard。関数(ツール)呼び出しの正確さを測るベンチマーク。
- 深さ優先探索(DFS)
- 木やグラフを深い方向へ優先して辿る探索アルゴリズム。従来手法の解答探索に使われた。
- テキスト勾配
- 数値の損失勾配の代わりに、LLMが自然言語で与える改善フィードバック。TextGradで提唱。
- OOD(分布外)
- 学習データとは異なる分布のデータ。未知のツールでの評価を指す。
出典
ToolGrad: Efficient tool-use dataset generation with textual "gradients"
https://research.google/blog/toolgrad-efficient-tool-use-dataset-generation-with-textual-gradients
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する