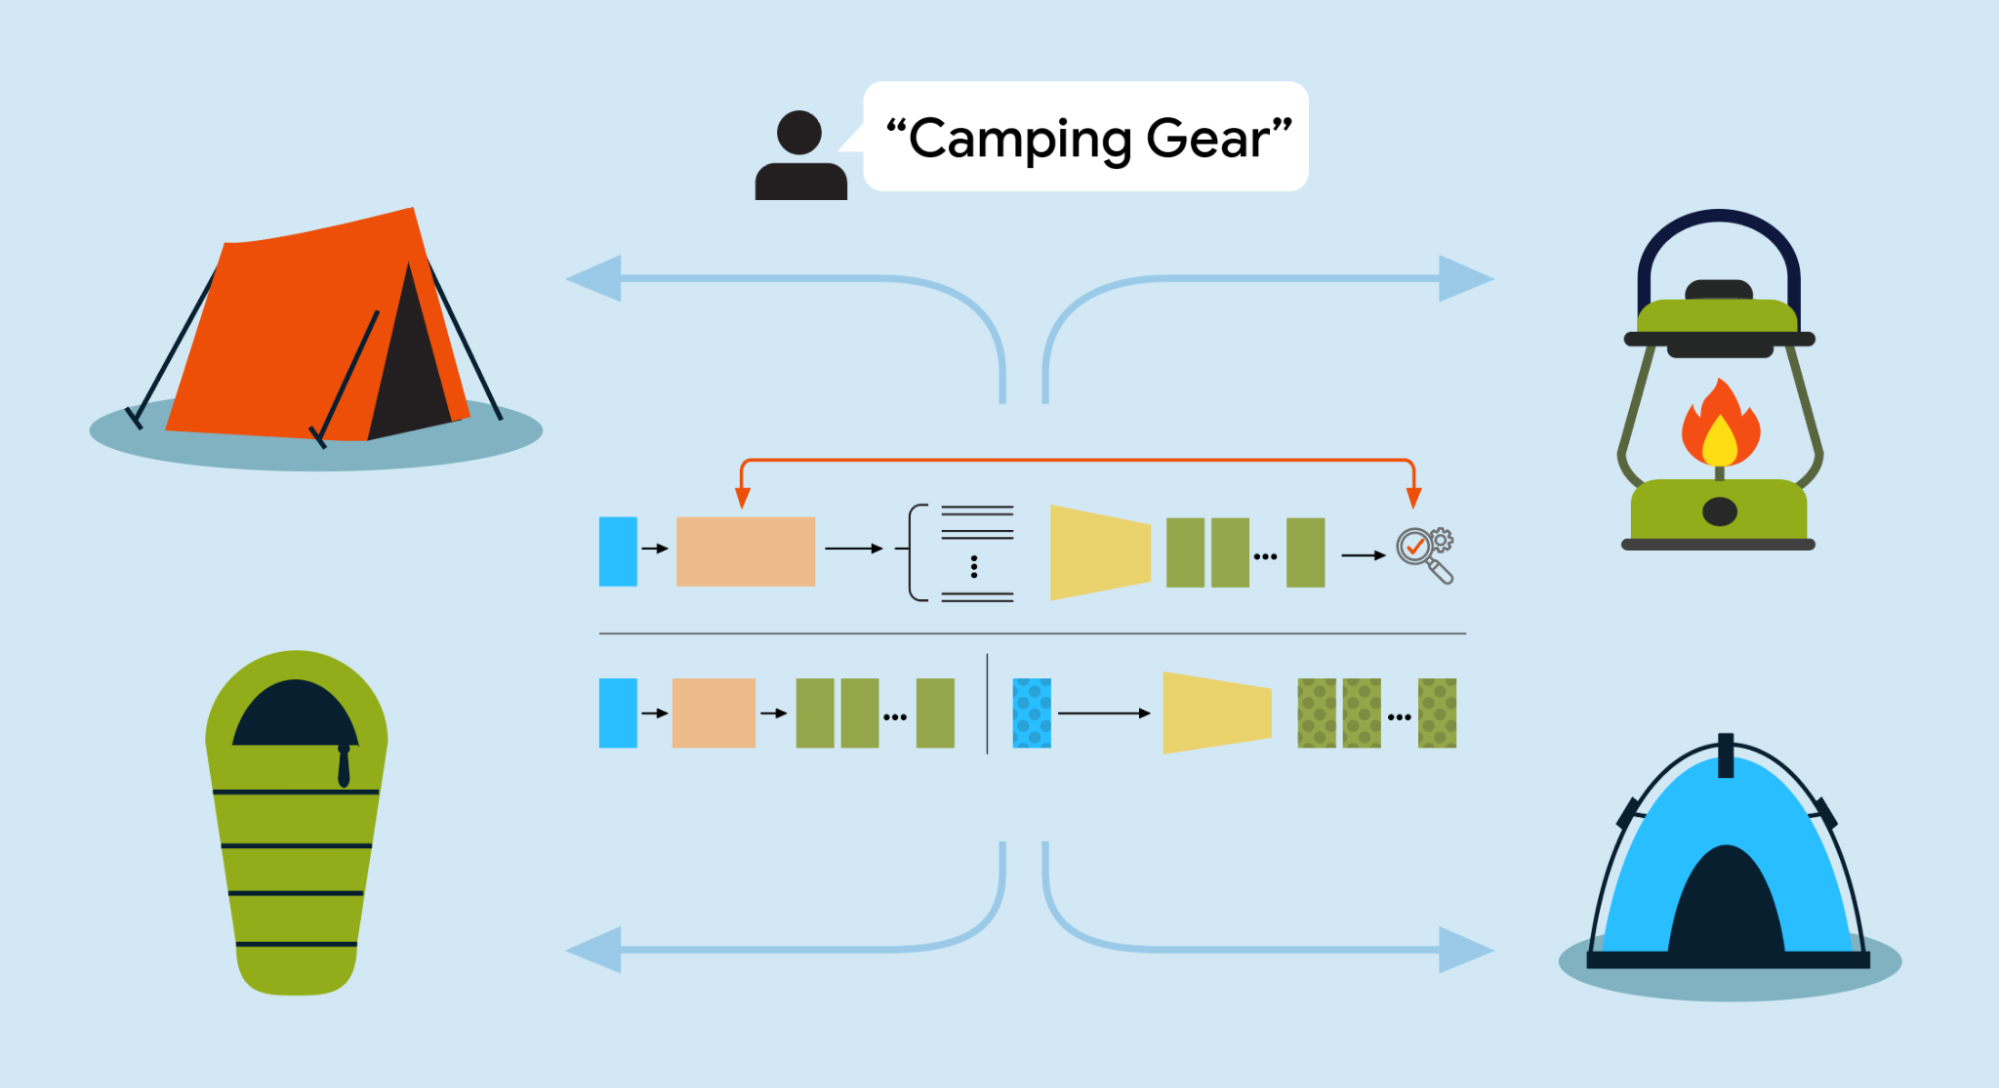
- 推論時の思考トークンを使わず、オフラインの強化学習でクエリ展開の方針を学習する
- 学習した振る舞いを53.9Mパラメータの拡散モデルに蒸留し、1回の並列生成で集合を出力
- 大規模バッチで約50秒に達する自己回帰型に対し、1秒未満〜数秒に短縮したと報告
何が発表されたか
検索やレコメンドの現場では、単一の最適解ではなく互いに補完し合う結果セットが求められるようになっている。たとえば「camping gear」と検索した利用者は、4人用テントの似た候補を10件並べられたいのではなく、テント、寝袋、携帯ストーブ、ヘッドランプといった必要な道具の組み合わせを期待する。
こうしたニーズに応えるのがクエリファンアウトと呼ばれる手法で、1つの広いプロンプトを関連する複数のサブクエリに分解し、利用者の関心を広くカバーする。Google Researchは2026年9月15日、この分解を推論時ではなく学習時に済ませるフレームワーク「Retrieve-for-Train」を発表した。
基になっているのはICML 2026の論文「Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion」で、著者はPengcheng Jiang氏(Student Researcher)とJudith Yue Li氏(Senior Research Engineer)である。パイプラインは、強化学習によるファンアウト言語モデルの訓練、そのモデルを使った教師データの合成、拡散リトリーバの訓練という3段階で構成される。
技術的な新しさ
Retrieve-for-Trainの中心は、「良い検索」を数式で定義し、それを報酬として学習に組み込む点にある。従来の教師あり学習は個々の検索結果を単独で評価するが、多様性や補完性は集合全体を評価しなければ測れない性質である。そこでグラウンデッドネス(データベース上の実在項目に対応しているか)、多様性(Vendi Scoreで測定)、アラインメント(元のプロンプトから意味がずれていないか)の3つを重み付きで合成した報酬を使う。
訓練にはGRPO(group relative policy optimization)にsoft PPOによる正則化を組み合わせたSoft-GRPOを用い、Gemma3-4BとQwen3-4Bという4Bのオープンソースモデルをファンアウト言語モデルとして微調整した。各プロンプトに対して10個のサブクエリを生成させる設定である。
3つの報酬は互いに牽制し合う関係にあると説明されている。グラウンデッドネスだけを最適化すると、データベースの座標にたまたま一致する無意味な文字列を出して報酬を稼ぐようになり、アラインメントだけを足すと言い換えの繰り返しに収束する。Vendi Scoreによる多様性の項がこの抜け道をふさぎ、妥当で接地していながら意味の異なるサブクエリを探索させる役割を担う。
既存手法との違い
ゼロショットのLLMに検索クエリの分解を任せると、paraphrastic collapse(言い換え崩壊)と呼ばれる現象が起きる。原文の例では「Bohemian festival style」に対して「bohemian festival fashion」と「bohemian festival clothes」のようなほぼ同義のクエリを並べてしまい、fringe jacketsやcrochet dresses、suede bootsといった異なる方向性を取り逃す。
また自己回帰型のモデルは、複雑なクエリを分解するために数百のchain-of-thought(CoT)トークンを生成して計画を立てる必要がある。これは対話用途では許容されても、大量のサブクエリを同時に必要とする集合型検索では深刻なレイテンシの下限を作り、サブ秒応答が求められる検索バーとは相容れない。
評価は2つの設定で行われた。一つは唯一の正解が存在せず集合レベルの性質だけで品質を測るオープンエンド抽象検索(OAR)、もう一つは弱い参照セットが与えられる弱教師あり合成検索(WSCR)である。データセットには、ユーザーが組んだコーディネートの大規模ファッションデータ(CLIPベースのリトリーバで評価)と、専門家が作成した音楽プレイリストの独自産業データ(MuLanで評価)が使われた。
注意点と不明点
原文では、Retrieve-for-Trainが単一クエリ検索、ゼロショット拡張、最適化されたBest-of-Nベースラインを上回ったと述べられているが、多様性・アラインメント・再現率の具体的な数値は示されていない。どの程度の差なのかは原文からは判断できない。
レイテンシについても、自己回帰型が大規模なコンテキストバッチで50秒近くまで伸びるのに対し、Retrieve-for-Train-Diffusionは1秒未満から数秒に収まるとされている。ただし12〜20という高速化の数値(原文表記は「12 to 20 speedup」)は、どの条件・どのベースラインとの比較なのかが原文では明示されていない。
評価に使った音楽プレイリストのデータセットは独自(proprietary)であり、外部での再現や検証は難しい。またコードやモデルの公開範囲についての記載はなく、原文はアブレーションの結論の途中で終わっているため、報酬設計に関する詳細な検証結果は確認できない。
| 項目 | 自己回帰型ファンアウト | Retrieve-for-Train拡散 |
|---|---|---|
| 推論方式 | CoTトークンを逐次生成 | 埋め込みを1回の並列パスで生成 |
| モデル規模 | 4B(Gemma3-4B / Qwen3-4B) | 53.9Mパラメータ |
| レイテンシ | 大規模バッチでほぼ50秒 | 1秒未満〜数秒 |
| 高速化 | 比較の基準 | 12〜20(原文は12 to 20 speedup) |
At scale, while autoregressive fan-out latency expands linearly to nearly 50 seconds under large context batches, Retrieve-for-Train-Diffusion stays between sub-second to a few seconds.
大規模なコンテキストバッチでは、自己回帰型ファンアウトのレイテンシがほぼ50秒まで線形に伸びる一方、Retrieve-for-Train-Diffusionは1秒未満から数秒の間に留まる。
今後の見通し
Retrieve-for-Trainは、推論時に考える量を増やして品質を上げるという近年の潮流に対して、学習時に一度だけ計算資源を使い、推論では軽く済ませるという方向を示している。検索や推薦のようにレイテンシ要件が厳しい用途では、この「学習時計算・推論時軽量化」の設計が広がる可能性がある。次に判断したいのは、品質面の定量的な比較と、実運用でのスループットである。論文のコードやモデルが公開されるか、またデータベースを差し替えたときの再学習コストが明らかになれば、自社システムへの適用可否を評価しやすくなるとみられる。
日本の開発者・IT企業にとっての意味
検索やレコメンドの品質は、クエリをどれだけ多角的に展開できるかで大きく変わります。今回の発表は、その展開を推論時の大量の思考トークンで賄うのではなく、オフラインの強化学習と小さな拡散モデルに置き換える設計を示した点に意味があります。日本のIT企業にとっては二つの示唆があります。一つは、LLMを使った検索機能を設計する際に「推論時にどれだけ考えるか」という予算配分を前提から見直す必要が出てくることです。もう一つは、53.9Mパラメータという小さなモデルで集合レベルの多様性を扱えるなら、既存の検索基盤に組み込む際のGPUコストやレイテンシの見積もりが変わり得ることです。ただし品質の定量値や日本語での検証は示されておらず、導入判断には追加の検証が必要です。
気になる点
- 日本語の検索や推薦にも使えますか
- 本文で使われた言語モデルはGemma3-4BとQwen3-4Bで、いずれもオープンソースモデルです。ただし評価に使われたのはファッションのコーディネートと音楽プレイリストのデータで、日本語データでの検証結果は原文に記載がありません。日本語環境での性能は現時点では不明です。
- 既存の検索基盤に組み込めますか
- 本手法はデータベース側の埋め込み空間を前提とし、凍結したデータセット固有のマルチモーダル埋め込みバックボーン(ファッションではCLIPベース、音楽ではMuLan)と組み合わせて評価されています。既存の埋め込みインデックスがあれば応用の余地はありますが、報酬の重み付けや再学習の手順は自前で設計する必要があるとみられます。
- レイテンシは実際どのくらい短くなりますか
- 原文によれば、自己回帰型のファンアウトは大規模なコンテキストバッチでほぼ50秒まで線形に伸びる一方、Retrieve-for-Train-Diffusionは1秒未満から数秒に収まります。ただし測定条件(ハードウェアやバッチサイズなど)の記載がないため、この数値をそのまま自社環境の見積もりに使うことはできません。
用語解説
- クエリファンアウト
- 1つの広い検索クエリを、関連する複数のサブクエリに分解して検索範囲を広げる手法。
- 拡散モデル
- ノイズからデータを段階的に生成するモデル。ここではテキストを逐次生成せず、埋め込みベクトルを並列に生成するために使う。
- 強化学習(RL)
- 試行錯誤の結果に報酬を与えて方策を改善する機械学習の手法。ここでは検索クエリの展開方針の学習に使う。
- GRPO
- group relative policy optimization。同じプロンプトへの複数の出力をグループとして比較し、相対的な良し悪しで方策を更新する強化学習アルゴリズム。
- Vendi Score
- 集合全体の多様性を測る指標。個々の要素ではなく、集合として意味がどれだけ広がっているかを数値化する。
- 蒸留
- 大きなモデルや学習済みの方策が持つ振る舞いを、より小さなモデルに引き継がせる手法。
出典
Bypassing inference bottlenecks: Accelerating complex AI search with Retrieve-for-Train
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する