- SkyRLとGRPOでQwen3-VL-8Bを訓練し、迷路正答率が43.75%から95%超に向上
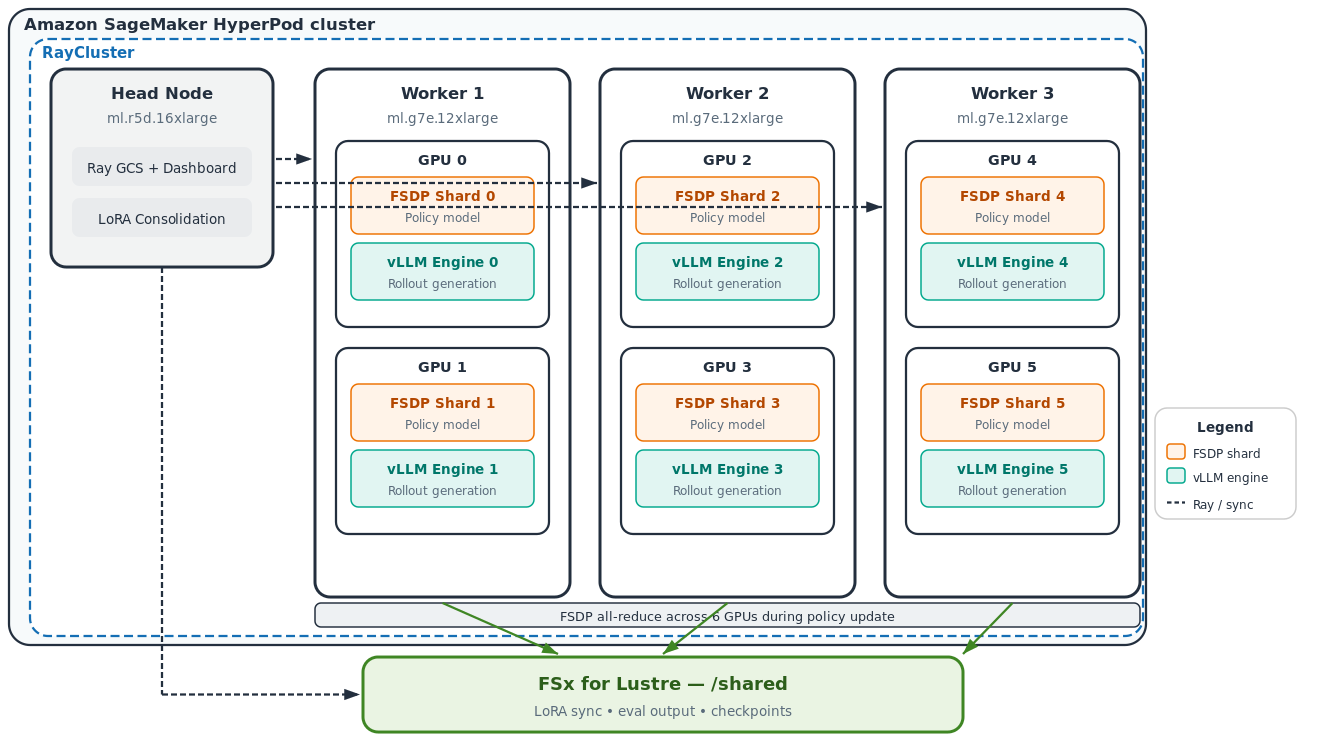
- GPUワーカー3台とCPUヘッド1台で、推論と訓練を同じGPUに同居させる構成
- 料金や対応リージョンは原文に記載がなく、評価は固定64問に限られる
HyperPod上でSkyRLを動かす
AWSは2026年9月25日付のブログで、Amazon SageMaker HyperPod上でオープンソースの強化学習フレームワーク「SkyRL」を実行し、視覚言語モデルのQwen3-VL-8Bを訓練する手順を公開しました。題材は2次元迷路の探索で、モデルは迷路の画像を見て移動方向を選ぶ行動を繰り返します。固定64問の評価セットで、迷路の正答率が43.75%から95%超に向上したと報告されています。前提条件の整理からコンテナイメージのビルド、ジョブ投入、監視までを含む実践的なウォークスルーです。
学習の出発点はVisGymのSFTチェックポイントです。VisGymは迷路環境とデータセット生成器を提供するリポジトリで、その教師あり微調整済みモデルは迷路画像の解釈と構造化された行動の出力をすでに習得していると説明されています。GRPOによる事後学習は、どの行動の並びがゴール到達につながるかを磨き上げる役割を担うという位置づけです。
GRPOによるマルチターンRL
通常の強化学習は1つのモデル出力に報酬を与えますが、マルチターンRLは状態を観測し、行動し、フィードバックを受け取る一連のステップを通じてエージェントを訓練します。迷路の例では、1エピソードが迷路への1回の挑戦、1ターンが1回の移動にあたります。報酬は疎に設定されており、制限手数内にゴールへ到達したときだけ1.0が与えられ、それ以外は何も得られません。1手ごとの正解表は存在せず、ある移動が良かったかどうかは前後の移動との関係で決まります。
この設定を支えるのがSkyRLのGRPO(Group Relative Policy Optimization)です。各開始位置について現在の方策で迷路を複数回走らせ、その結果を互いに比較します。グループ平均を上回った試行を強化し、下回った試行を抑え込む仕組みです。このグループ内比較そのものが学習信号になるため、criticや価値モデルを別途用意しなくても学習が成立すると説明されています。
6基のGPUに同居させる構成
構成はGPUワーカー3台とCPUヘッド1台です。ワーカーはml.g7e.12xlargeで、各ノードにNVIDIA RTX PRO 6000 Blackwellを2基、合計6基のGPUを使います。ヘッドはml.r5d.16xlarge(512 GB RAM)で、RayのGCSやダッシュボード、LoRAアダプタの統合を担当します。方策モデルはLoRA(rank 32)を適用したQwen3-VL-8Bで、PyTorch FSDPによって6基のGPUに分割されます。
SkyRLは推論と訓練を同じGPUに同居させます。ロールアウト生成は6つのvLLMインスタンスが担当し、方策更新はFSDPワーカーがまとめて実行します。最適化ステップのたびに、更新されたLoRAアダプタの重みがAmazon FSx for Lustre上の共有ストレージを通じて推論エンジンへ同期されます。AWSは、同居させない場合は訓練用と推論用に別々のGPUプールが必要になり、位相の切り替えで互いに待ち時間が生じて計算資源を浪費すると説明しています。
HyperPodが担う役割
HyperPodはAmazon EKS上の大規模機械学習ワークロード向けの基盤で、ノードの健全性を継続的に監視し、故障したノードを自動的に交換します。チェックポイントと組み合わせることで、ハードウェア障害が起きても最後に保存したステップから再開できます。数百GPU時間のロールアウトを伴う長時間のマルチノードRLでは、この再開性が重要になると説明されています。
運用面では、SageMaker StudioからRayクラスタを作成し、sagemaker_ray://プロトコルでジョブを投入できます。HyperPod Observability EKSアドオンが用意するAmazon Managed Grafanaダッシュボードで学習状況を監視できます。リモートエンドポイントを有効にすると、ローカルでのkubectl port-forwardなしにジョブ投入やダッシュボード閲覧が可能になります。
結果の読み方と注意点
95%超という数字は、固定された64問の迷路評価セットでの結果です。一般的な視覚言語能力や他のタスクへの汎化を示すものではない点には注意が必要です。また、この手順は特定のコンテナイメージとコミットSHA、特定のインスタンス構成を前提としており、再現にはKubeRay operatorやHyperPod Observabilityアドオンなどの前提条件を満たす必要があります。
原文には料金や対応リージョン、ml.g7e.12xlargeの提供状況についての記載はありません。ワーカーのGPUメモリが足りていれば他のGPUインスタンスやクラスタサイズでも動作するとされていますが、具体的な最小構成や性能差は示されていません。ヘッドノードについては、チェックポイント保存時にLoRAアダプタのシャードをCPUメモリへ一時的に読み込むため、大きなメモリ容量が必要だと説明されています。
| 項目 | SFTチェックポイント | GRPO事後学習後 |
|---|---|---|
| 迷路の正答率 | 43.75% | 95%超 |
| 学習方法 | 教師あり微調整(SFT) | GRPO |
| 評価セット | 固定64問の迷路 | 固定64問の迷路 |
That within-group comparison is the whole training signal, which lets GRPO work without a separate critic or value model.
このグループ内比較が学習信号のすべてであり、それによってGRPOは別個のcriticや価値モデルなしで機能します。
今後の見通し
この記事はAWSによる手順の公開であり、SkyRLをマネージドサービスとして提供するかどうかは明らかにされていません。今後は、HyperPod上でのRay利用や可観測性の機能拡充が続くかどうかが注目点になるとみられます。判断材料としては、HyperPodが対応するリージョンやインスタンスの広がり、SkyRLが対応するモデルやタスクの拡大、SkyRLをHyperPod以外のKubernetes環境で動かした場合との運用コストの比較などが挙げられます。料金体系や商用サポートの有無が示されれば、本番導入の可否を判断しやすくなります。
日本の開発者・IT企業にとっての意味
画像を見て操作するマルチモーダルなエージェントを事後学習させるには、長時間のロールアウトを止めずに回すGPUクラスタと、障害復旧・チェックポイント・可観測性の仕組みが欠かせません。今回の手順は、その組み合わせをEKSベースのマネージド基盤上でどう作るかを、インスタンス構成やFSx for Lustreのマウント方法まで含めて具体的に示しています。自前でGPUクラスタの運用ツールを組む手間を減らせる可能性がある一方、GPUワーカー3台と大容量メモリのヘッドという構成は小規模なチームには重く、まず小さいモデルで検証する判断が現実的です。SkyRLはオープンソースであるため、同様の構成をHyperPod以外のKubernetes環境で試すことも選択肢になります。
気になる点
- 日本リージョンでも同じ構成を組めますか。
- 原文には対応リージョンの記載がないため、現時点では公表されていないというのが正確なところです。前提として、Amazon EKSオーケストレーションのHyperPodクラスタ、ml.g7e.12xlargeとml.r5d.16xlarge、Amazon FSx for Lustre、SageMaker Studioドメインが利用できる必要があります。個別のリージョンでの提供状況はAWSの最新情報を確認してください。
- GPUは6基そろえないと試せませんか。
- 必須ではないとされています。原文は、ワーカーに十分なGPUメモリがあれば他のGPUインスタンスやクラスタサイズでも動作すると説明しています。ただしヘッドノードはLoRAアダプタのシャードを統合する際に大きなメモリを必要とし、例では512 GB RAMのml.r5d.16xlargeを使っています。具体的な最小構成は示されていません。
- 費用はどのくらいかかりますか。
- 原文に料金の記載はないため不明です。構成として必要になるのは、HyperPodクラスタ(EKSオーケストレーション)、ml.g7e.12xlarge×3台、ml.r5d.16xlarge×1台、Amazon FSx for Lustre、SageMaker Studioドメイン、コンテナイメージを置くAmazon ECRです。実際のコストは稼働時間とリージョンの料金に依存します。
用語解説
- GRPO
- Group Relative Policy Optimization。同じ開始状態から複数回試行し、グループ内で相対的に良い行動を強化する強化学習手法。criticを必要としない。
- FSDP
- Fully Sharded Data Parallel。PyTorchの分散学習手法で、モデルのパラメータや勾配を複数のGPUに分割して保持する。
- LoRA
- Low-Rank Adaptation。学習対象を低ランクの差分パラメータに限定し、微調整の計算量とメモリを抑える手法。
- vLLM
- 大規模言語モデルの推論を高速化するオープンソースの推論エンジン。ここでは迷路のロールアウト生成に使われる。
- SFT
- Supervised Fine-Tuning。正解付きのデータでモデルを追加学習する教師あり微調整のこと。
- エピソード
- 強化学習において、開始から終了までの一連の試行をひとまとまりとして数える単位。
出典
Accelerate multimodal RL training with SkyRL on Amazon SageMaker HyperPod
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する