- Nemotron 3.5 Super VLは120BのMoEモデルで、1トークンあたり12Bを活性化する
- テキスト・画像・文書・動画を1つのモデルで扱い、推論とツール利用に対応する
- EKS、EKS Auto Mode、SageMaker HyperPod EKSで同一のKubernetesマニフェストを使える
公開された内容
AWSのブログでは、NVIDIA Nemotron 3.5 Super VLがAWS上で利用可能なNemotronファミリーに加わったことが示された。すでにNemotron 3 Nano、Nano Omni、Super、Ultra、Nemotron 3.5 LightningがAWSで利用できるという。Nemotron 3.5 Super VLは120BパラメータのMixture-of-Experts(MoE、複数の専門家モデルのうち一部だけを動かす方式)モデルで、1トークンあたり12Bのパラメータを活性化する。推論とツール利用に、テキスト・画像・文書・動画の理解を組み合わせ、1つのモデルでテキスト系と視覚系の両方のタスクを担う。
このモデルはNemotron 3 Ultraから蒸留されたオープンなマルチモーダルモデルで、重み・学習データセット・post-training(事後学習)のレシピが公開されている。そのためドメイン特化のカスタマイズが可能で、自分で管理するインフラ上で実行できる。コンテキスト長は最大100万トークン、入力はテキスト、画像、文書、動画に対応し、BF16とNVFP4のチェックポイントが用意される。
NVIDIAが報告するスコアは、Hermes Benchで63.44%、LangChainのエージェント評価で87.05%、CharXivのチャート推論ベンチマークで80.8%とされる。これらは技術レポートに基づく数値とされている。
アーキテクチャの特徴
Nemotron 3.5 Super VLは、Mamba-2、attention、エキスパート層を交互に配置したハイブリッドMamba-Transformer MoE構造を採る。スパースルーティングによって120Bのうち12Bのみを活性化するため、1トークンあたりの計算量はより小さいモデル並みに抑えられる一方、GPUメモリには全重みを保持する形になる。
Mamba-2層は生成中に一定サイズの状態を保持するため、KVキャッシュのように系列長に比例してメモリが増えない。これが長いコンテキストを扱いやすくしている。さらに再帰的に共有されるMulti-Token Prediction(MTP)ヘッドが、ネイティブな投機的デコーディング(候補トークンを先に生成して検証する高速化手法)を支える。視覚エンコーダにはRADIOを採用している。
用途としては、コードのテスト・検証やエラー解析、検索ツールが返した情報源の突き合わせ、表やグラフを含む文書の要約、脆弱性の特定、動画の検索・レビュー・インシデント分析が挙げられている。主要なオープンなエージェントフレームワークやオーケストレーションシステムとは、NVIDIAのリファレンス実装やcookbook、NVIDIA Agent Toolkitを通じて統合できるという。
AWSでのデプロイと評価
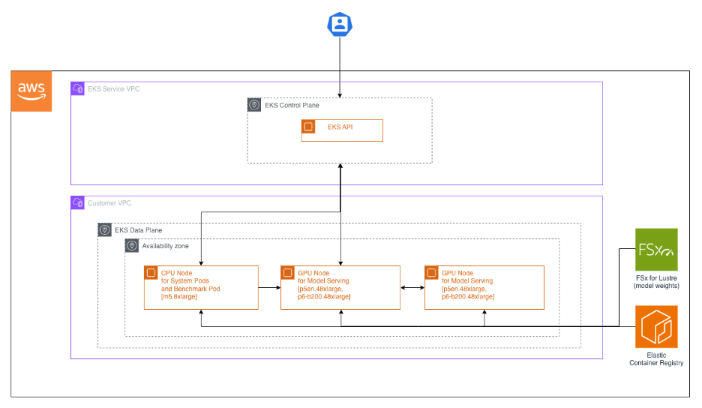
リファレンス実装は、標準のAmazon EKS、EKS Auto Mode、Amazon SageMaker HyperPod EKSで動作する。EKS Auto Modeでは、スケーリングやGPU、EFA(Elastic Fabric Adapter、ノード間通信用のネットワークインターフェース)のサポートをAWSが利用者に代わって管理する。モデルをデプロイするKubernetesマニフェストは、どのオーケストレータを選んでも同じものを使えるという。クラスタはKubernetes APIを載せるコントロールプレーンと、CPU・GPUノードからなるデータプレーンで構成される。CPUノードはシステムとテスト用のPodを、GPUノードはモデルを動かし、コンテナイメージはAmazon ECR、モデルの重みは共有のAmazon FSx for Lustreボリュームに置く。
モデルの配信はNVIDIA Dynamoが担い、単一ノードに集約する構成と、prefill(入力の前処理)とdecode(トークン生成)を別ノードに分ける分離構成を選べる。視覚言語モデルでは、画像・動画のエンコード段階をさらに別ノードに分離できる。検証はp6-b200.48xlarge(8基のNVIDIA B200 GPU)とp5en.48xlarge(8基のNVIDIA H200 GPU)で行われた。
性能測定にはNVIDIAのaiperfツールを使い、TTFT(最初のトークンが出るまでの時間)、ITL(トークン間の遅延)、TPS(1秒あたりのトークン数)を計測する。2ノードでの集約構成と分離構成の比較では、分離構成の方がTTFTが低く、ITLはほぼ同じだったという。TTFTとITLを分けて見ることで、ITLが上がればdecode側、TTFTが上がればprefill側を増やすという判断ができると説明されている。
現時点で分かっていないこと
料金やGPUの最小構成について、本稿で参照した範囲では具体的な数値が確認できない。原文には最小GPU構成の項目が設けられているが、詳細な表は示されていない。利用を検討する場合は、p6-b200.48xlargeやp5en.48xlargeといったGPUインスタンスの利用が前提になる点に注意が必要となる。
ベンチマークスコアはいずれもNVIDIAの技術レポートに基づく報告値であり、AWS上での実測値ではない。集約構成と分離構成の比較も2ノードでの条件であり、クラスタ規模を変えた場合の挙動は別途確認が必要になる。
EKS Auto Mode以外の2つの選択肢について、GPUやスケーリングの管理をどこまでAWSが担うのかは、参照した範囲では明示されていない。構成を選ぶ際は、aws-do-eksプロジェクトの手順とあわせて確認することが望ましいとみられる。
| 項目 | 集約構成 | 分離構成 |
|---|---|---|
| TTFT(最初のトークンまで) | 相対的に高い | 相対的に低い |
| ITL(トークン間の遅延) | ほぼ同じ | ほぼ同じ |
| ノードの使い方 | 単一ノードに集約 | prefillとdecodeを別ノードに配置 |
Sparse routing activates 12B of the 120B parameters per token, so compute per token matches a much smaller model while GPU memory still holds the full weights.
スパースルーティングは120Bのパラメータのうち12Bをトークンごとに活性化するため、トークンあたりの計算量ははるかに小さいモデルと同等になる一方、GPUメモリには全重みが保持される。
今後の見通し
今回公開されたのは、モデルそのものの新規発表というより、AWS上で動かすための構成と評価手法の整理である。今後は、クラスタ規模を変えた場合のスループット特性や、NVFP4チェックポイントを使った際の精度・速度の変化が明らかになれば、実運用での構成選びがしやすくなる。最小GPU構成や料金の情報が公開されれば、PoC(概念検証)にかかるコストの見積もりが可能になる。aws-do-eksのリファレンス実装が更新され、対応モデルやフレームワークの範囲が広がるかどうかも判断材料になるとみられる。
日本の開発者・IT企業にとっての意味
日本企業がエージェント型AIを社内システムに組み込む際、モデルを自社のクラウドアカウント内で動かせるかどうかは、データの扱いや監査の観点で重要な判断軸になる。Nemotron 3.5 Super VLは重み・学習データセット・post-trainingレシピが公開されており、EKSやSageMaker HyperPod EKSという既存の運用基盤に載せられる点が実務上の意味を持つ。文書・表・動画を1つのモデルで扱えるため、社内文書の要約や動画レビューなど複数システムに分かれていた処理を統合できる可能性がある。一方で、120Bの重みを保持するGPUメモリと、8基構成のGPUインスタンスが前提になるため、小規模な検証から始める場合は分離構成や量子化チェックポイントの活用を検討する必要がある。Kubernetesの運用知識がある組織ほど立ち上げは容易とみられる。
気になる点
- 日本国内のリージョンでも同じ構成で使えるのか
- 参照した範囲では、リージョンごとの提供状況には触れられていない。一方で、デプロイ手順はEKS、EKS Auto Mode、SageMaker HyperPod EKSで共通のKubernetesマニフェストを使う形でまとまっており、利用するGPUインスタンスが確保できるリージョンかどうかが実質的な判断材料になるとみられる。
- コストはどのくらいかかるのか
- 原文には料金に関する記載がない。p6-b200.48xlarge(8基のNVIDIA B200 GPU)やp5en.48xlarge(8基のNVIDIA H200 GPU)といった大規模なGPUインスタンスでの検証が前提となっており、必要なノード数は目標とするスループットから逆算する考え方が示されている。具体的な費用は現時点では公表されていない。
- 既存のEKSクラスタやツールをそのまま使えるのか
- モデル配信にはNVIDIA DynamoとvLLMを使い、コンテナイメージはAmazon ECR、重みはAmazon FSx for Lustreに置く構成が示されている。Kubernetesマニフェストは各オーケストレータで共通のため、既存のEKS運用に沿って組み込める可能性がある。詳細な手順はaws-do-eksプロジェクトで公開されている。
用語解説
- MoE(Mixture-of-Experts)
- 複数の専門家サブネットワークを用意し、入力ごとに一部だけを動かすモデル構造。総パラメータ数を増やしつつ計算量を抑えられる。
- KVキャッシュ
- 生成時に過去のキーと値のテンソルを保持して再計算を省く仕組み。系列長に比例してメモリ使用量が増える。
- 投機的デコーディング
- 小さな処理で候補トークンを先に生成し、本体モデルでまとめて検証する高速化手法。出力の品質を保ちながら生成を速める。
- TTFT / ITL
- TTFTは最初のトークンが生成されるまでの時間、ITLはトークン間の遅延。応答の体感速度と連続生成の速さを分けて測る指標。
- EFA(Elastic Fabric Adapter)
- AWSが提供するノード間通信用のネットワークインターフェース。大規模な分散処理でGPUノード間の通信を高速化する。
出典
Accelerate agentic AI with NVIDIA Nemotron models on Amazon EKS and SageMaker HyperPod EKS
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する