- LLMがdiffごとに「失敗するテスト」を生成し、本番前のバグを検出
- LLM-as-Judgeとルールベース判定を併用し、偽陽性をランキングで抑制
- 589人が利用、真陽性率60%、プライバシーSEVを20%削減
JiTTestsが本番インフラへ
Metaは2026年10月29日、LLMを活用したテスト生成手法「Catching JiTTests」を研究プロトタイプから本番インフラへ移行したと発表しました。JiTTestsは、コード変更(diff)が本番にマージされる前に、その変更に固有のテストを自動生成する仕組みです。Metaは数億行規模のコードが常に変化していると説明しており、従来のテストでは変更のスピードに追いつけないとしています。
今回の発表は、FSE 2026で採択された論文「Just-in-Time Catching Test Generation at Meta」の内容と、その後の実運用結果をまとめたものです。Metaは約5か月前にこの取り組みを初めて公開しており、今回はスケールと業界全体への適用可能性を確かめた段階と位置づけています。Catching JiTTestsは現在、研究段階の試作物ではなくMetaのインフラの一部として稼働しているとしています。
2つの生成ワークフローと5段階の処理
テスト生成は「dodgy diff」と「intent-aware」という2つのワークフローで行われます。dodgy diffは、あらゆるdiffを意図的にバグを含んだ変異体(mutant)とみなし、親コードとの振る舞いの差を暴くテストを作るアプローチです。intent-awareは、diffのタイトルや要約から変更の意図をLLMに推論させ、その意図を実装する際に起こりうるリスクを列挙したうえでテストを生成します。
処理は5段階に分かれます。まず夜間に余剰キャパシティを使って前日投稿されたdiffのうちリスクの高いものを選び、次に2つのワークフローでテストを生成します。その後、生成された「weak catch」(失敗したテストのうち偽陽性かもしれないもの)をLLMとルールベースの両面から評価し、最終的に人間のエンジニアに声をかけるかどうかを決めます。
偽陽性をどう抑えるか
大規模なコードベースでは、weak catchの多くが偽陽性である可能性があり、そのままエンジニアに投げるとレビュー負荷が跳ね上がります。Metaはこれを抑えるために、複数の最先端LLMの判定を集約する「LLM-as-Judge」と、決定論的で検証可能なルールベースの評価器「RubFake(Rule-Based False-Positive Killing Environment)」を併用しています。
両者を組み合わせてweak catchの候補をランキングし、上位のものだけを人間の確認対象にします。さらに、人間がすべての出力を確認する「human-in-the-loop」ではなく、基準を設定して集約レベルで結果を監視する「human-on-the-loop」を採用し、エンジニアがテストコードを読む機会を減らす設計にしています。
運用で得られた数値と限界
公開時点で589人(声をかけたエンジニアの64%)がCatching JiTTestsを利用し、真陽性率は60%だったと報告されています。2026年上半期には、74件の深刻な(SEV)プライバシーバグをdiff段階で捕捉し、同期間のプライバシーSEVの発生を20%減らしたとしています。
ただし真陽性率60%という数字は、残りの4割が真のバグとして確認されたわけではないことを含みます。原文では、テスト生成は夜間の余剰キャパシティで実行され、エンジニアの開発速度を妨げないように設計されていると説明されていますが、計算資源の量やコスト、他社環境での再現性については記載がありません。
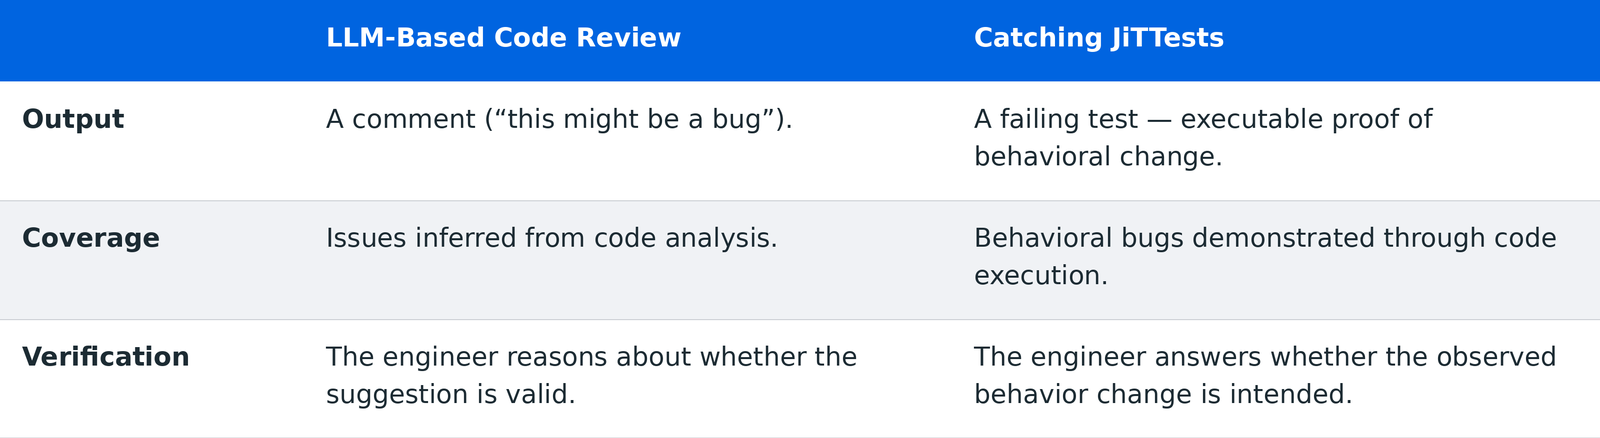
| 項目 | LLM・エージェント型コードレビュー | Catching JiTTests |
|---|---|---|
| アプローチ | 過去の経験をもとにコードをレビュー | 変更が生む振る舞いの差を示す実行可能テストを生成 |
| 出力 | レビュー指摘 | 失敗するテスト(weak catch) |
| 計算コスト | より少ないステップで済む | より多くの計算ステップを必要とする |
| 検出範囲 | レビューで気づける範囲 | コードレビューでは見逃しうる種類のバグ |
While it requires more computational steps, it catches classes of bugs that LLM- or agent-based code reviews might not.
より多くの計算ステップを必要とする一方で、LLMやエージェントベースのコードレビューでは見つけられない種類のバグを捕捉します。
今後の見通し
Catching JiTTestsは、LLMエージェントによるコードレビューとは異なる方向の安全性レイヤーとして位置づけられます。Metaは論文で初期デプロイの詳細を公開しており、手法自体は追試可能な形になっているとみられます。今後注目されるのは、他社のコードベースでも同等の真陽性率が出るか、LLM-as-Judgeに使うモデルの構成やコストがどう変わっていくか、そしてこの仕組みがオープンソース化や外部提供されるかどうかです。これらの情報が明らかになれば、日本企業が自社のCIに組み込めるかどうかを判断できるでしょう。
日本の開発者・IT企業にとっての意味
日本のIT企業にとっての意味は主に2つあります。1つは、エージェント型のコーディング支援でコードを書く速度が上がるほど、テストの生成速度もボトルネックになるという点です。Metaの事例は、diff単位でテストを自動生成し、本番前のリスクを下げるという発想を具体的な運用形にした例として参考になります。 もう1つは運用手法です。人間が全件を確認するのではなく、基準を設定して集約結果を監視するhuman-on-the-loopは、レビュー工数を増やさずにAIの出力を回す設計として、日本の開発組織にも応用しやすい考え方です。ただし前提として、夜間の余剰計算資源、diff単位のリスクスコア、複数LLMを判定に使うコストといった要素が必要になります。真陽性率60%という数値は、導入時に残り4割のトリアージをどう設計するかを同時に検討すべきことも示しています。
気になる点
- 日本企業の開発現場でも同じ仕組みを導入できますか
- 論文で手法の枠組みは公開されていますが、Metaのコードベースとインフラを前提とした仕組みです。オープンソース化や外部向け提供については原文に記載がありません。diff単位でテストを生成し、既存のCIに組み込むという考え方自体は参考になります。
- 偽陽性が多いと実務で使いものになりませんか
- MetaはLLM-as-JudgeとRubFakeを併用して候補をランキングし、上位だけを人間の確認対象にすることでレビュー負荷を抑えています。報告されている真陽性率は60%で、残りについてはトリアージの設計が必要になります。
- 導入コストはどれくらいかかりますか
- テスト生成は夜間の余剰キャパシティで実行され、エンジニアの開発速度を妨げない設計だと説明されています。ただし使用する計算資源の量や金額、LLM呼び出しのコストについては現時点で公表されていません。
用語解説
- JiTTests
- Just-in-Time Tests。コード変更(diff)が本番に入る直前に、その変更固有のテストをLLMで自動生成する手法。
- LLM-as-Judge
- 複数のLLMに判定させ、その結果を集約して品質を評価する手法。ここではweak catchが真陽性かどうかの判定に使う。
- Diff Risk Score(DRS)
- 変更内容からリスクの高さを推定する仕組み。原文では「DRSに似た機構」として言及されている。
- human-on-the-loop
- 人間が個々の出力を確認するのではなく、基準を設定し集約レベルで結果を監視する運用形態。
- mutant(変異体)
- 意図的に欠陥を注入したコード。テストがその欠陥を検出できるかで有効性を測る。
- SEV
- severityの略。Metaにおける深刻度の高い障害・バグの区分。
出典
Catching Bugs Before They Land: JiTTesting’s Human-on-the-Loop Approach at Full Scale
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する