- Metaの広告検索エンジン「Meta Andromeda」の次世代版は、単一GPUサーバーで毎秒10億件超の広告を処理する
- LLM由来のMixture-of-Expertsをretrievalに導入し、2024年版比で推論時FLOPsを約300分の1に削減
- NVIDIAとGPUカーネルを協調最適化し、ゲーティングは5.3倍、索引マッチングは2倍超の高速化
発表の概要
Metaは、パーソナライズ広告の検索エンジン「Meta Andromeda」の次世代版を公開した。広告レコメンドの最初の段階であるretrievalで、ランキング段階に近いモデル性能を維持しながら、単一GPUサーバー上で毎秒10億件超の広告を処理できるとする。2024年版のMeta Andromedaと比べて100倍のスループット向上という。
広告主にとっては、同じレイテンシ予算のまま、より大きな候補プールから広告をマッチングできる。2025年以降、Meta AndromedaはFacebookでコンバージョンを2.4%増やしたと報告されている。
MoEで推論コスト削減
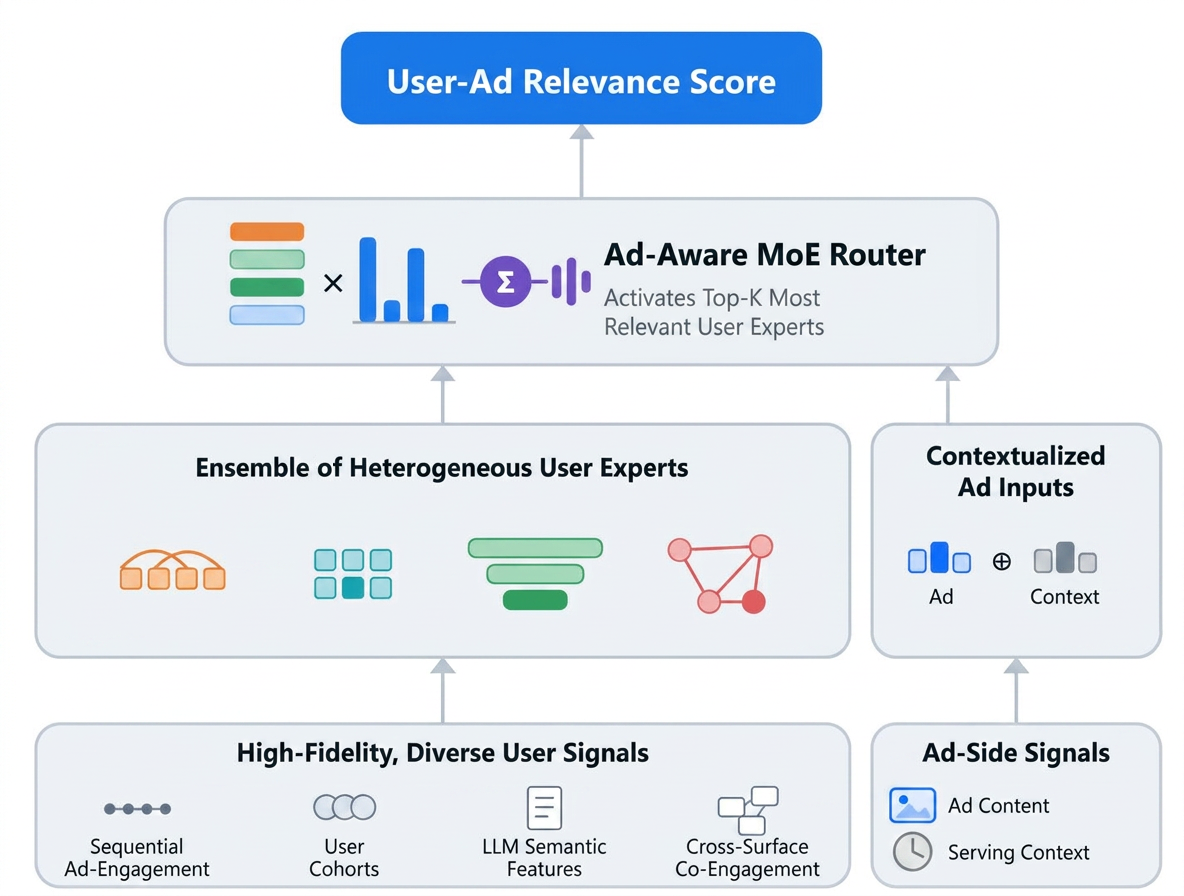
新アーキテクチャの中心は、大規模言語モデルで使われるMixture-of-Experts(MoE)をretrievalに持ち込んだ点にある。ユーザー側は単一のタワーから、関心ごとに分かれた複数の専門家タワーの集合に変わった。連続的な広告エンゲージメント、ユーザーコホート表現、LLM由来の意味特徴、画面横断の共エンゲージメント信号を統合する。
候補広告側はリアルタイムの配信コンテキストを結合し、相互作用層は密なニューラルネットから注意機構ベースのMoEゲーティングに進化した。候補を最も関連するユーザー専門家に動的に振り分ける。これにより、2024年版のretrievalモデルと比べて約300分の1の推論時FLOPsで、ランキング段階に近い性能を実現するという。
単一GPUへの融合と配置
モデルだけでなくシステム側も協調設計した。ユーザーと広告の相互作用ごとに、モデル実行とシステム処理を1つのGPUカーネルに融合する。従来は複数の小さなカーネルを呼び出し、中間テンソルをHBMに書き出していたが、融合カーネルでは中間結果をGPUのレジスタや共有メモリに保持し、HBMへの冗長なトラフィックをなくす。
さらに、索引マッチング、スコアリング、top-K選択を同じGPU上に配置した。従来はCPUホストとリモートGPUの間で候補リストをやり取りし、ネットワーク帯域がボトルネックになっていた。コンパクトなリクエストだけをGPUサーバーに送り、最終的なtop-Kだけを返す構成に変えたことで、ネットワーク通信量を約100分の1に削減した。
索引マッチングのGPU移設では、広告主が設定する複雑なターゲティング条件を数十の特徴カテゴリにわたって評価し、リアルタイムの索引更新にも対応する必要があった。GPU並列実行向けに索引構造を再設計し、本番のターゲティング意味論を保ったとしている。
NVIDIAとの協調最適化
2026年初頭からNVIDIAと共同で、retrievalパイプラインの各構成要素をハードウェア限界に近づける最適化を進めた。NVIDIAが最適化済みGPUカーネルを提供し、Metaが統合とベンチマークを担当した。各構成要素でベースライン比2〜5倍の高速化を得た。
相互作用ネットワークのゲーティングカーネルは5.3倍高速化し、毎秒24億件から100億件超に向上した。GPUのピークHBM帯域の約85%に達した。単純な内積スコアリングカーネルと同じ程度のレイテンシで、より表現力の高いモデルを動かせるという。INT8量子化ではFP16最適化カーネル比で最大2倍のスループット向上があり、精度は16ビットと同等だった。
索引マッチングは2倍超の高速化で毎秒1000億件超に達し、スコアリングネットワークの1桁上になった。余裕があるため、複数のretrieval経路で再実行してもボトルネックになりにくい。パイプライン全体では、構成要素間のデータ移動が遅延の大きな割合を占めていたとし、索引マッチングとスコアリングのデータレイアウトを協調設計して不要な間接参照を除いた。
現時点の注意点
原文は、全最適化を適用したパイプライン全体の最終結果の記述が途中で終わっている。単一GPUサーバーで毎秒10億件超という数値は示されているが、end-to-endの最終スループットや精度、消費電力、コストへの影響は本文だけでは判断できない。
この仕組みはMetaの広告配信基盤に組み込まれた内部実装であり、外部向け製品としての提供時期や、日本市場での適用時期は原文に記載がない。NVIDIA GH200を前提とした設計であり、他のGPU環境やクラウドへの一般化可能性も明らかではない。
2024年版からの移行詳細や、モデル容量をさらに増やした場合の効果も今後の説明を待つ必要がある。ただし、モデル・システム・ハードウェアを同時に設計する「協調設計」の方向性は、大規模レコメンド基盤を扱う企業にとって参考になる。
| 項目 | 2024年版 | 2026年版 |
|---|---|---|
| スループット | GPUカードあたり毎秒数千万件 | 単一GPUサーバーで毎秒10億件超 |
| 推論時FLOPs | 基準 | 約300分の1(2024年版比) |
| ネットワーク通信量 | 基準 | 約100分の1 |
| ユーザーモデル | 単一のユーザータワー | 専門家タワーの集合(MoE) |
| カーネル融合の範囲 | モデル実行内の演算 | モデル実行とシステム処理を単一カーネルに融合 |
Model inference throughput has reached over 10 billion ads per second on a single GH200 GPU
モデル推論のスループットは、単一のGH200 GPU上で毎秒100億件超の広告に達した。
今後の見通し
Metaは単一GPUパイプラインで毎秒10億件超を処理し、モデル推論では単一GH200上で毎秒100億件超に達したとしている。まだハードウェア限界までの余裕があるとみられ、モデル容量の拡大や複数retrieval経路への展開が進む可能性がある。一方、全最適化後のend-to-end性能、一般提供の時期、日本での適用、消費電力あたりの効率は原文では明らかでない。次に判断するには、パイプライン全体の最終スループットと精度、コスト、GH200以外のGPUでの再現性が示されるかを見る必要がある。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、この発表は大規模レコメンド基盤の設計が「モデルだけ」「システムだけ」の最適化から、GPUカーネルやデータ配置を含む協調設計へ移りつつあることを示す。ECの商品推薦や動画サービスの候補抽出でも、候補数が増えるほどメモリ帯域とネットワークがボトルネックになりやすい。融合カーネルで中間テンソルをHBMに出さない工夫、索引マッチングをGPUに寄せる発想、MoEで推論FLOPsを抑える手法は参考になる。一方で、Meta規模の専用実装でGH200前提の最適化であり、そのまま移植できるものではない。広告主には、Facebook広告のマッチング精度と候補規模が同じレイテンシで改善する可能性がある点が実務上の意味を持つ。
気になる点
- 日本企業もこのretrieval基盤を使えますか
- Metaの広告配信基盤の内部技術で、外部提供や日本での提供時期は原文に記載がありません。広告主としては、Facebook広告の配信性能向上という形で間接的に影響を受ける可能性があります。現時点では自社システムに導入できる製品としての情報はありません。
- なぜMoEにすると効率が上がるのですか
- すべての入力で同じ大きなネットワークを使うのではなく、入力に応じて専門家サブネットワークを選ぶため、表現力を保ちながら推論時の計算量を抑えられます。原文では、2024年版retrievalモデル比で約300分の1のFLOPsでランキング段階に近い性能に達したとされています。
- 既存の広告配信システムから移行できますか
- 原文はMetaの本番環境での刷新であり、移行手順や互換性には触れていません。単一GPUへの索引マッチング移設やカーネル融合など、GPUアーキテクチャに強く依存する設計です。一般企業が同様の構成を採るには、自社の候補規模とレイテンシ要件に合わせた再設計が必要と考えられます。
用語解説
- retrieval
- 広告やコンテンツの候補群から、まず関連性の高い少数候補を高速に絞り込む処理。後段のランキングに渡す前段階。
- Mixture-of-Experts(MoE)
- 複数の専門家ネットワークを用意し、入力に応じて一部だけを使うモデル構造。計算量を抑えつつ表現力を上げやすい。
- FLOPs
- 浮動小数点演算の回数。モデル推論の計算量を表す指標として使われる。
- HBM
- GPUに搭載される高帯域メモリ。大規模モデルの推論では帯域が性能の律速になりやすい。
- カーネル融合
- 複数のGPU演算を1つのカーネルにまとめ、中間データのメモリ書き出しを減らす最適化手法。
- INT8量子化
- 推論の数値表現を8ビット整数に落とす手法。メモリ使用量と計算量を減らし、速度向上が期待できる。
出典
Meta Andromeda: Powering the Next Generation of Ads Retrieval Through Model-System Co-Design
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する