- Bedrock Managed Knowledge Baseのエージェント型検索がLangChainから使えるようになった
- 標準のRetrieve APIは1回の検索、エージェント型は計画ループで再検索する
- 原文の例では5件取得だと6つの意図のうち2つを取りこぼすと説明されている
何が公開されたのか
AWSの機械学習ブログで、Amazon Bedrock Managed Knowledge BaseとLangChainを組み合わせたRAGアプリの解説が公開された。同じ複数パートの質問を標準の検索とエージェント型検索の両方に通し、トレースイベントからモデルが生成した計画を読み取る内容になっている。両方式のコストと、安い方を選ぶべき場面にも触れている。
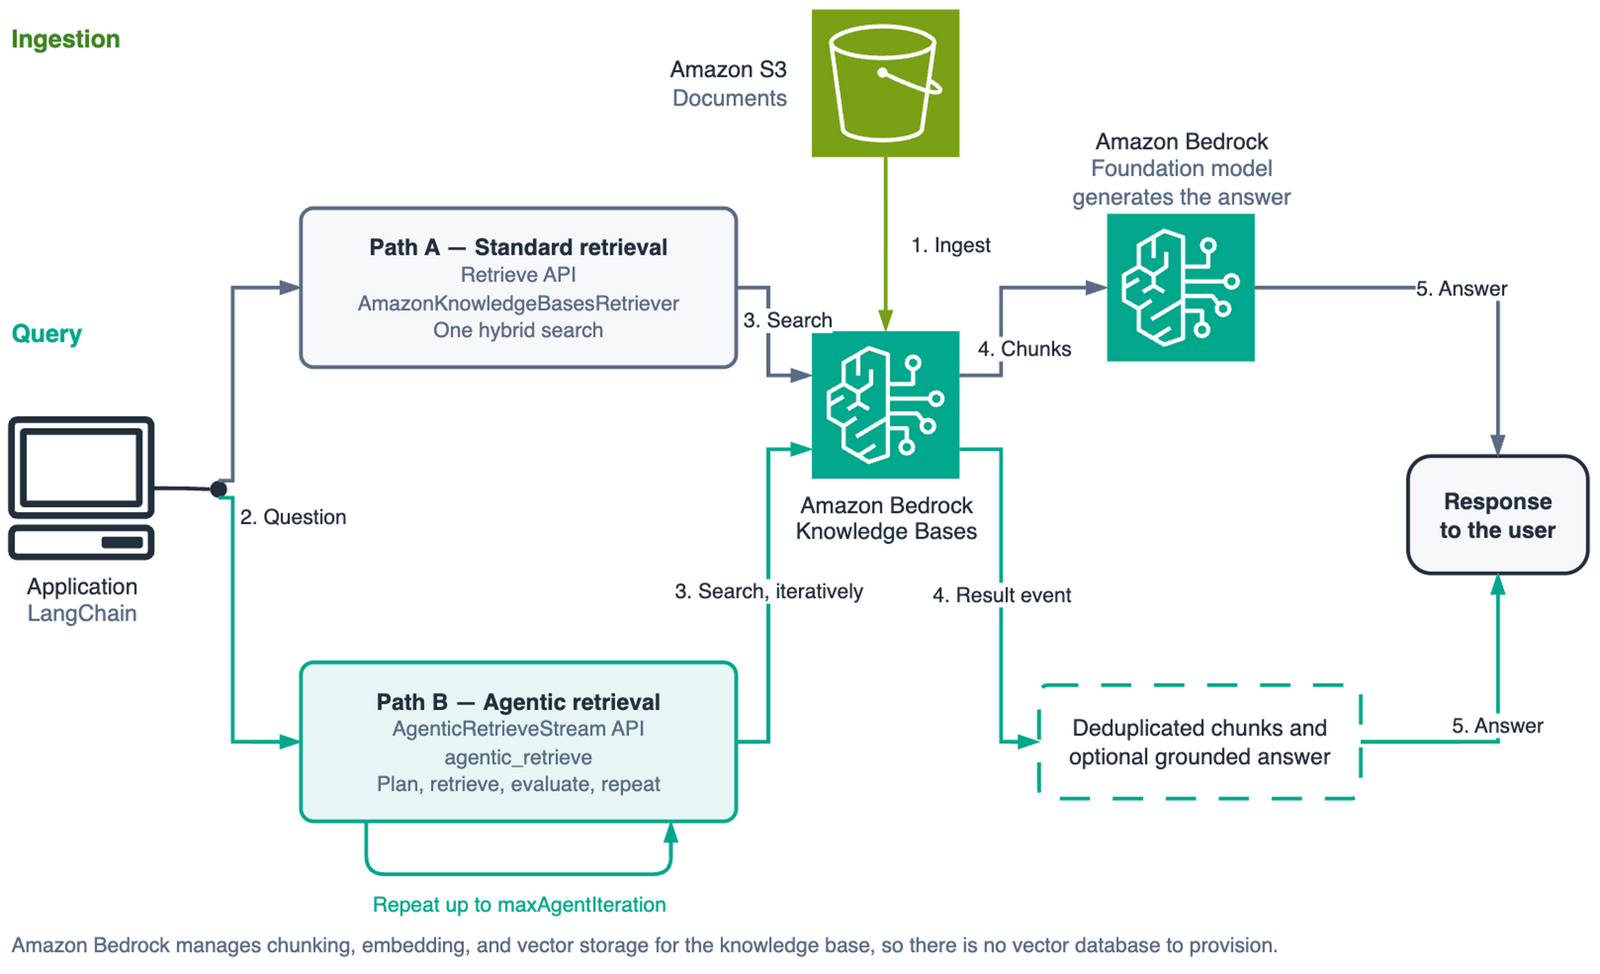
エージェント型検索はAmazon Bedrock Managed Knowledge Base上で利用できる。1回の検索ではなく、質問をサブクエリに分解して実行し、十分な根拠があるかを判断し、足りなければ再検索する仕組みだ。langchain-awsパッケージが標準とエージェント型の両方を公開しているため、LangChainアプリからどちらも呼び出せる。
2つの検索APIの違い
Bedrock Managed Knowledge Basesは2つのAPIを提供する。Retrieve APIは1回のハイブリッド検索を実行してスコア付きのチャンクを返す。AgenticRetrieveStream APIは計画ループを実行し、各ステップをトレースイベントとしてストリームで返す。langchain-awsでは、前者がチェーンに組み込める標準のリトリーバー、後者がナレッジベースから直接呼び出す関数として提供される。
エージェント型が関数になっているのは、基盤のAPIが結果をストリームで返し、同期型のBaseRetrieverインターフェースに収まらないためだ。AmazonKnowledgeBasesRetrieverに切り替えフラグがあるわけではない点は注意したい。
設定ではmanagedSearchConfigurationを使う点も押さえておきたい。vectorSearchConfigurationは自前のベクターストアを使う従来の経路で、既存のサンプルの多くはこちらを示している。
単発検索の限界
原文では、チェックアウトと在庫の2サービスを、オンコールのエスカレーション・バックアップと復元の目標・デプロイのロールバック手順という3つの観点で比較する質問が例に使われている。これは実質6つの意図を含む質問になる。
単発検索では、1つのクエリベクトルが6つの意図すべてをまとめて表そうとする。原文によれば、5件の結果では2つの意図を取りこぼす。10件に増やすと6つすべてをカバーできるが、2つのサブ意図が二重にカバーされ、1つのチャンクはどれも担っていないという無駄が見えるという。
リトリーバーの動作自体は正しく、制約は構造的なものだと筆者は説明する。1つのベクトルは6つの意図を表現できず、返された根拠が十分かを問うステップが存在しない、という指摘である。
導入時の注意点
エージェント型検索を使うにはboto3のバージョンが重要で、agentic_retrieve_streamは1.43.32より前には存在しなかったとされている。原文の検証はPython 3.12以降を前提としている。
権限設計では差が出る。bedrock:AgenticRetrieveStreamとbedrock:InvokeModelWithResponseStreamはナレッジベースのARNに絞れないが、bedrock:Retrieveとbedrock:GetDocumentContentは絞れる。またbedrock:GetDocumentContentは見落とされやすく、FullDocumentExpansionステップが文書全体を必要としたときに呼ばれるため、Retrieveだけのポリシーではクエリの途中で失敗しうる。
検証は米国東部(バージニア北部、us-east-1)で行われており、他リージョンでの可用性はAWSドキュメントの確認が必要とされている。実行にはドキュメントの保存と取り込み、検索呼び出し、基盤モデルの推論のコストがかかりうるとして、料金ページを参照するよう案内している。
| 項目 | 標準(Retrieve API) | エージェント型(AgenticRetrieveStream API) |
|---|---|---|
| 検索の方式 | 1回のハイブリッド検索 | 計画ループでサブクエリを反復実行 |
| LangChainでの提供 | AmazonKnowledgeBasesRetriever | agentic_retrieve 関数 |
| IAMでのスコープ | ナレッジベースARNに絞れる | ARNに絞れずワイルドカード指定 |
| 向く質問 | 意図が1つの質問 | 複数意図を含む質問 |
The limitation is structural: one vector cannot represent six intents, and there is no step in the process that asks whether the returned evidence is enough to answer the question.
制約は構造的なものだ。1つのベクトルは6つの意図を表現できず、返された根拠が質問に答えるのに十分かどうかを問うステップがプロセスに存在しない。
今後の見通し
原文はagentic_retrieveの内部動作の説明の途中で終わっており、評価ステップがどのように再検索を打ち切るかの詳細は示されていない。今後、この評価ロジックの具体像や、標準検索とエージェント型検索の実際のコスト差・レイテンシ差が公開されれば、どちらを本番で使うかを判断しやすくなる。日本語や東京リージョンを含む他リージョンでの可用性も、AWSドキュメントの更新を待って確認したい。自前のベクターストア構成からマネージドのナレッジベースへ移す場合の移行コストも、判断材料になるとみられる。
日本の開発者・IT企業にとっての意味
RAGの精度問題はモデルやプロンプトの調整として語られがちだが、この記事が示すのは検索側の構造的な限界だ。複数の意図を含む質問では、1つの埋め込みベクトルが意図の平均に寄り、関連はするが質問の一部しかカバーしないチャンクが返る。日本のIT企業が社内検索やサポートアシスタントをRAGで作る場合、比較質問や複数条件の質問は日常的に発生する。Bedrock Managed Knowledge Baseなら、マネージドのまま計画ループを足す選択肢が増える。一方、エージェント型は独立関数でストリーム前提、IAMもARNに絞れないなど、既存チェーンへの組み込み方は変わる。単発検索で足りる質問を見極め、複数意図の質問にだけエージェント型を回す設計が現実的とみられる。
気になる点
- 東京リージョンなど日本でも使えるのか
- 原文のウォークスルーは米国東部(バージニア北部、us-east-1)で実施されており、他リージョンでの可用性はAWSドキュメントを確認するよう記載されている。東京リージョンを含む日本国内での提供状況は原文に明記されていないため、現時点では公式ドキュメントで確認する必要がある。
- 既存のLangChain RAGアプリから移行できるのか
- 標準検索はAmazonKnowledgeBasesRetrieverとして既存のチェーンに組み込める。ただしマネージドのナレッジベースではmanagedSearchConfigurationを指定する必要があり、自前ベクターストア向けのvectorSearchConfigurationを使う既存例はそのまま流用できない。エージェント型は独立したagentic_retrieve関数を呼ぶ形になる。
- コストはどれくらい違うのか
- 原文は2つの検索経路のコストに触れるとしているが、具体的な金額や倍率は示していない。実行にはドキュメントの保存と取り込み、検索呼び出し、基盤モデルの推論のコストがかかりうるとし、Amazon Bedrockの料金ページを参照するよう案内している。単発検索の方がレイテンシは低いとされている。
用語解説
- RAG
- 検索拡張生成。外部文書を検索し、その内容を根拠にモデルへ回答させる構成。
- エージェント型検索
- 質問をサブクエリに分解し、検索・評価・再検索を繰り返す検索方式。
- ハイブリッド検索
- キーワード検索とベクトル検索などを組み合わせて結果を統合する検索手法。
- 埋め込み(embedding)
- テキストを数値ベクトルに変換したもの。類似度の計算に使われる。
- FullDocumentExpansion
- 抜粋では文脈が足りないと計画が判断した際に、文書全体を取得するステップ。
- AmazonKnowledgeBasesRetriever
- langchain-awsが提供するBedrockナレッジベース用の標準リトリーバー。
出典
Agentic retrieval with LangChain and Amazon Bedrock Knowledge Bases
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する