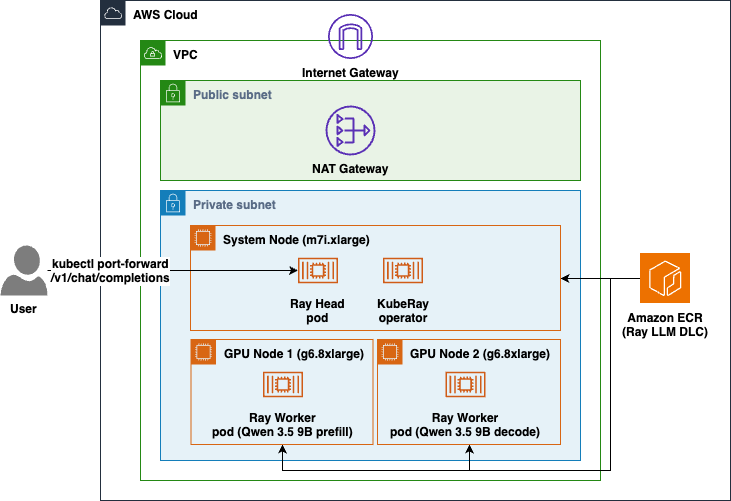
- 1つのLLMを2台のGPUノードに分け、prefillとdecodeを別ノードで処理する
- 推論エンジンにvLLM、KVキャッシュ転送にNIXLとEFAを同梱したDLC
- アプリ定義はYAMLのみでハンドラクラスやカスタムイメージのビルドは不要
何が示されたか
AWSがRay LLM DLCを使い、Amazon EKS上の2つのGPUノードに1つのLLMをまたがって配置する手順を示した。prefillとdecodeを別ノードに分離し、1つのOpenAI互換エンドポイントの背後で協調させる。想定用途としてRAG、文書要約、エージェント型アプリケーションが挙げられている。
単一GPUノードの構成では、1つのGPUに収まらないモデルや、1レプリカでは足りないスループットへの対応が難しい。マルチノード構成はテンソル並列・パイプライン並列・データ並列、そしてprefill/decode分離で一般的だが、GPUスタックのライブラリ互換を利用者自身が組み合わせて検証する必要があった。DLCはその依存関係をテスト済みの組み合わせとしてまとめたものになる。
PD分離の狙いと仕組み
LLM推論には2つのフェーズがある。prefillは入力プロンプト全体を並列に処理してKVキャッシュを作り、decodeはそのキャッシュを読みながらトークンを1つずつ生成する。prefillは計算律速、decodeはメモリ帯域律速で、同じGPUを共有すると互いに干渉する。
分離すると各フェーズに別々のハードウェアとサービング設定を選べ、独立してスケールできる。一方で、prefillが作ったKVキャッシュをdecodeノードに渡す必要があり、その転送が速くなければ効果が相殺される。記事はだからこそノード間の相互接続が重要になると説明している。
DLCに含まれるもの
Ray LLM DLCには、推論エンジンのvLLM、Ray ServeのHTTPレイヤー、ノード間KVキャッシュ転送のNIXL、高帯域ノード間通信用のEFAスタック(libfabricとaws-ofi-nccl)が含まれる。CUDAランタイムやフレームワーク、サービング層の間にバージョンのずれが起きないよう、全コンポーネントがまとめて検証され、セキュリティパッチはビルド時に適用される。
アプリケーションはYAMLのserveConfigV2ブロックで定義する。build_pd_openai_appというヘルパーがprefill_configとdecode_configを受け取り、両者の間のKVキャッシュ転送を配線する。ハンドラクラスやモデルアーカイバ、カスタムイメージのビルドは不要とされている。
記事が特に重視するのがkv_connector_extra_configでbackendsにLIBFABRICを指定する行である。指定しない場合、NIXLはUCXを既定として使い、EFA上でもTCP相当の速度になると説明されている。
EKS上の構成
構成はVPC内のEKSクラスタで、ノードはプライベートサブネットに置かれ、NAT Gateway経由で外向き通信を行う。CPUのシステムノード(m7i.xlarge)がKubeRayオペレーターとRayヘッドを動かし、2台のGPUワーカーノード(g6.8xlarge)がprefillとdecodeをそれぞれ担当する。両ノードはAmazon ECRからDLCを取得する。
GPUノードグループは単一のAvailability Zoneに固定される。EFAはAZをまたげないためである。ワーカーのPodはGPU 1基とEFAインターフェース1つを要求し、NIXLがCUDA VRAMをEFA NICに登録する関係でprivileged: trueで動かす必要がある。IPC_LOCKだけでは足りないと説明されている。
現時点の注意点
検証はQwen3.5-9Bをg6.8xlargeで動かす構成を前提としている。記事の設定値(max_model_len 4096、bfloat16、gpu_memory_utilization 0.90、enforce_eager true)はこの構成に合わせたものとみられる。より大きなモデルや別のインスタンスで同じ設定が通用するかは示されていない。
モデル重みのロードは、このキャッシュ構成で再起動時に約145秒から約2秒に短縮されたと報告されている。ただしモデルや入力に依存する部分がある。デプロイ手順は4つのスクリプトに分かれ、クラスタ作成だけで15〜20分、GPUノード追加に5〜20分かかるとされる。
| 項目 | 指定なし(UCX) | LIBFABRIC指定 |
|---|---|---|
| KV転送バックエンド | UCX | LIBFABRIC |
| EFA利用時の実効速度 | TCP相当 | EFAによる高帯域通信 |
| 設定の記述 | 不要 | backends: ["LIBFABRIC"] を指定 |
The critical setting is kv_connector_extra_config: { backends: ["LIBFABRIC"] }. Without that line, NIXL defaults to UCX, which runs at TCP speed even on EFA.
重要な設定は kv_connector_extra_config: { backends: ["LIBFABRIC"] } である。この行がなければ、NIXLはUCXを既定として使い、EFA上でもTCP相当の速度で動作する。
今後の見通し
Ray LLM DLCはマルチノード推論の依存関係をまとめる試みだが、記事の検証はQwen3.5-9Bとg6.8xlargeという1つの構成にとどまる。より大きなモデルや別のGPUインスタンスで同じ設定が通用するか、prefillとdecodeのレプリカ数をどう配分すると効率が良いかは、今後の検証やドキュメントの更新を待つ必要がある。対応リージョンや料金も原文には示されておらず、自社環境で試す場合はGPUインスタンスのサービス枠とEFA対応AZの確認が先になる。PD分離の効果はワークロード次第とみられるため、プロンプト長や同時リクエスト数を変えたベンチマークが公開されれば判断しやすくなる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって、LLM推論のコストとレイテンシはサービス設計を左右する。PD分離は、長いプロンプトを処理しながら同時にトークン生成を続ける用途、たとえば社内文書検索を組み合わせたRAGや要約、エージェント型の処理で効いてくる可能性がある。vLLMやRayの依存関係を自前で組み合わせて検証する作業は工数が大きく、検証済みのコンテナが提供される意味は小さくない。一方で、GPUノード2台とEFA対応AZを前提とするため、GPUクォータの確保とコスト試算が導入の前提になる。アプリ定義がYAMLで完結する点は、既存のKubernetes運用に乗せやすいという利点がある。
気になる点
- 日本リージョンでもこの構成は使えますか?
- 原文は特定のリージョンを示していません。前提として、少なくとも64 vCPU分のサービス枠と、EFAに対応したAZでg6.8xlargeを2台起動できることが挙げられています。GPUノードグループはEFAがAZをまたげないため単一AZに固定されます。実際に利用できるリージョンはAWSのドキュメントで確認が必要です。
- コストはどのくらいかかりますか?
- 原文に金額の記載はありません。構成として必要なのは、CPUシステムノード1台(m7i.xlarge)、GPUワーカーノード2台(g6.8xlarge)、NAT Gateway、EKSクラスタです。クラスタ作成だけで15〜20分、GPUノード追加に5〜20分かかるとされ、検証中もこれらのリソース分の費用が発生します。
- 既存の単一ノード構成から移行できますか?
- 原文は移行手順そのものを説明していません。前回の記事ではRay Serve DLCを単一GPUノードで使っており、今回はbuild_pd_openai_appにprefill_configとdecode_configを渡す構成です。アプリ定義はYAMLのserveConfigV2ブロックで完結し、カスタムイメージのビルドは不要とされていますが、既存構成からの移行可否は明記されていません。
用語解説
- DLC
- AWSが提供する、フレームワークと依存関係、GPUスタックを検証済みの組み合わせでまとめた事前ビルド済みDockerイメージ。
- prefill
- LLM推論の第一段階。入力プロンプト全体を並列に処理してKVキャッシュを構築する。計算資源を多く使う。
- decode
- 推論の第二段階。KVキャッシュを読みながらトークンを1つずつ生成する。メモリ帯域の影響を受けやすい。
- KVキャッシュ
- 生成済みトークンの内部状態を再利用するためのキャッシュ。再計算を避けて生成を速くする。
- PD分離
- prefillとdecodeを別々のノードやGPUに分けて実行する構成。互いの干渉を避け、個別にスケールできる。
- NIXL
- NVIDIA Inference Transfer Library。ノード間でKVキャッシュを転送するためのライブラリ。
出典
Run multi-node inference workloads using Ray LLM Deep Learning Containers
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する