- MetaのMuse Spark OpenがSageMaker JumpStartで提供開始、自分のAWSアカウントに配備できる
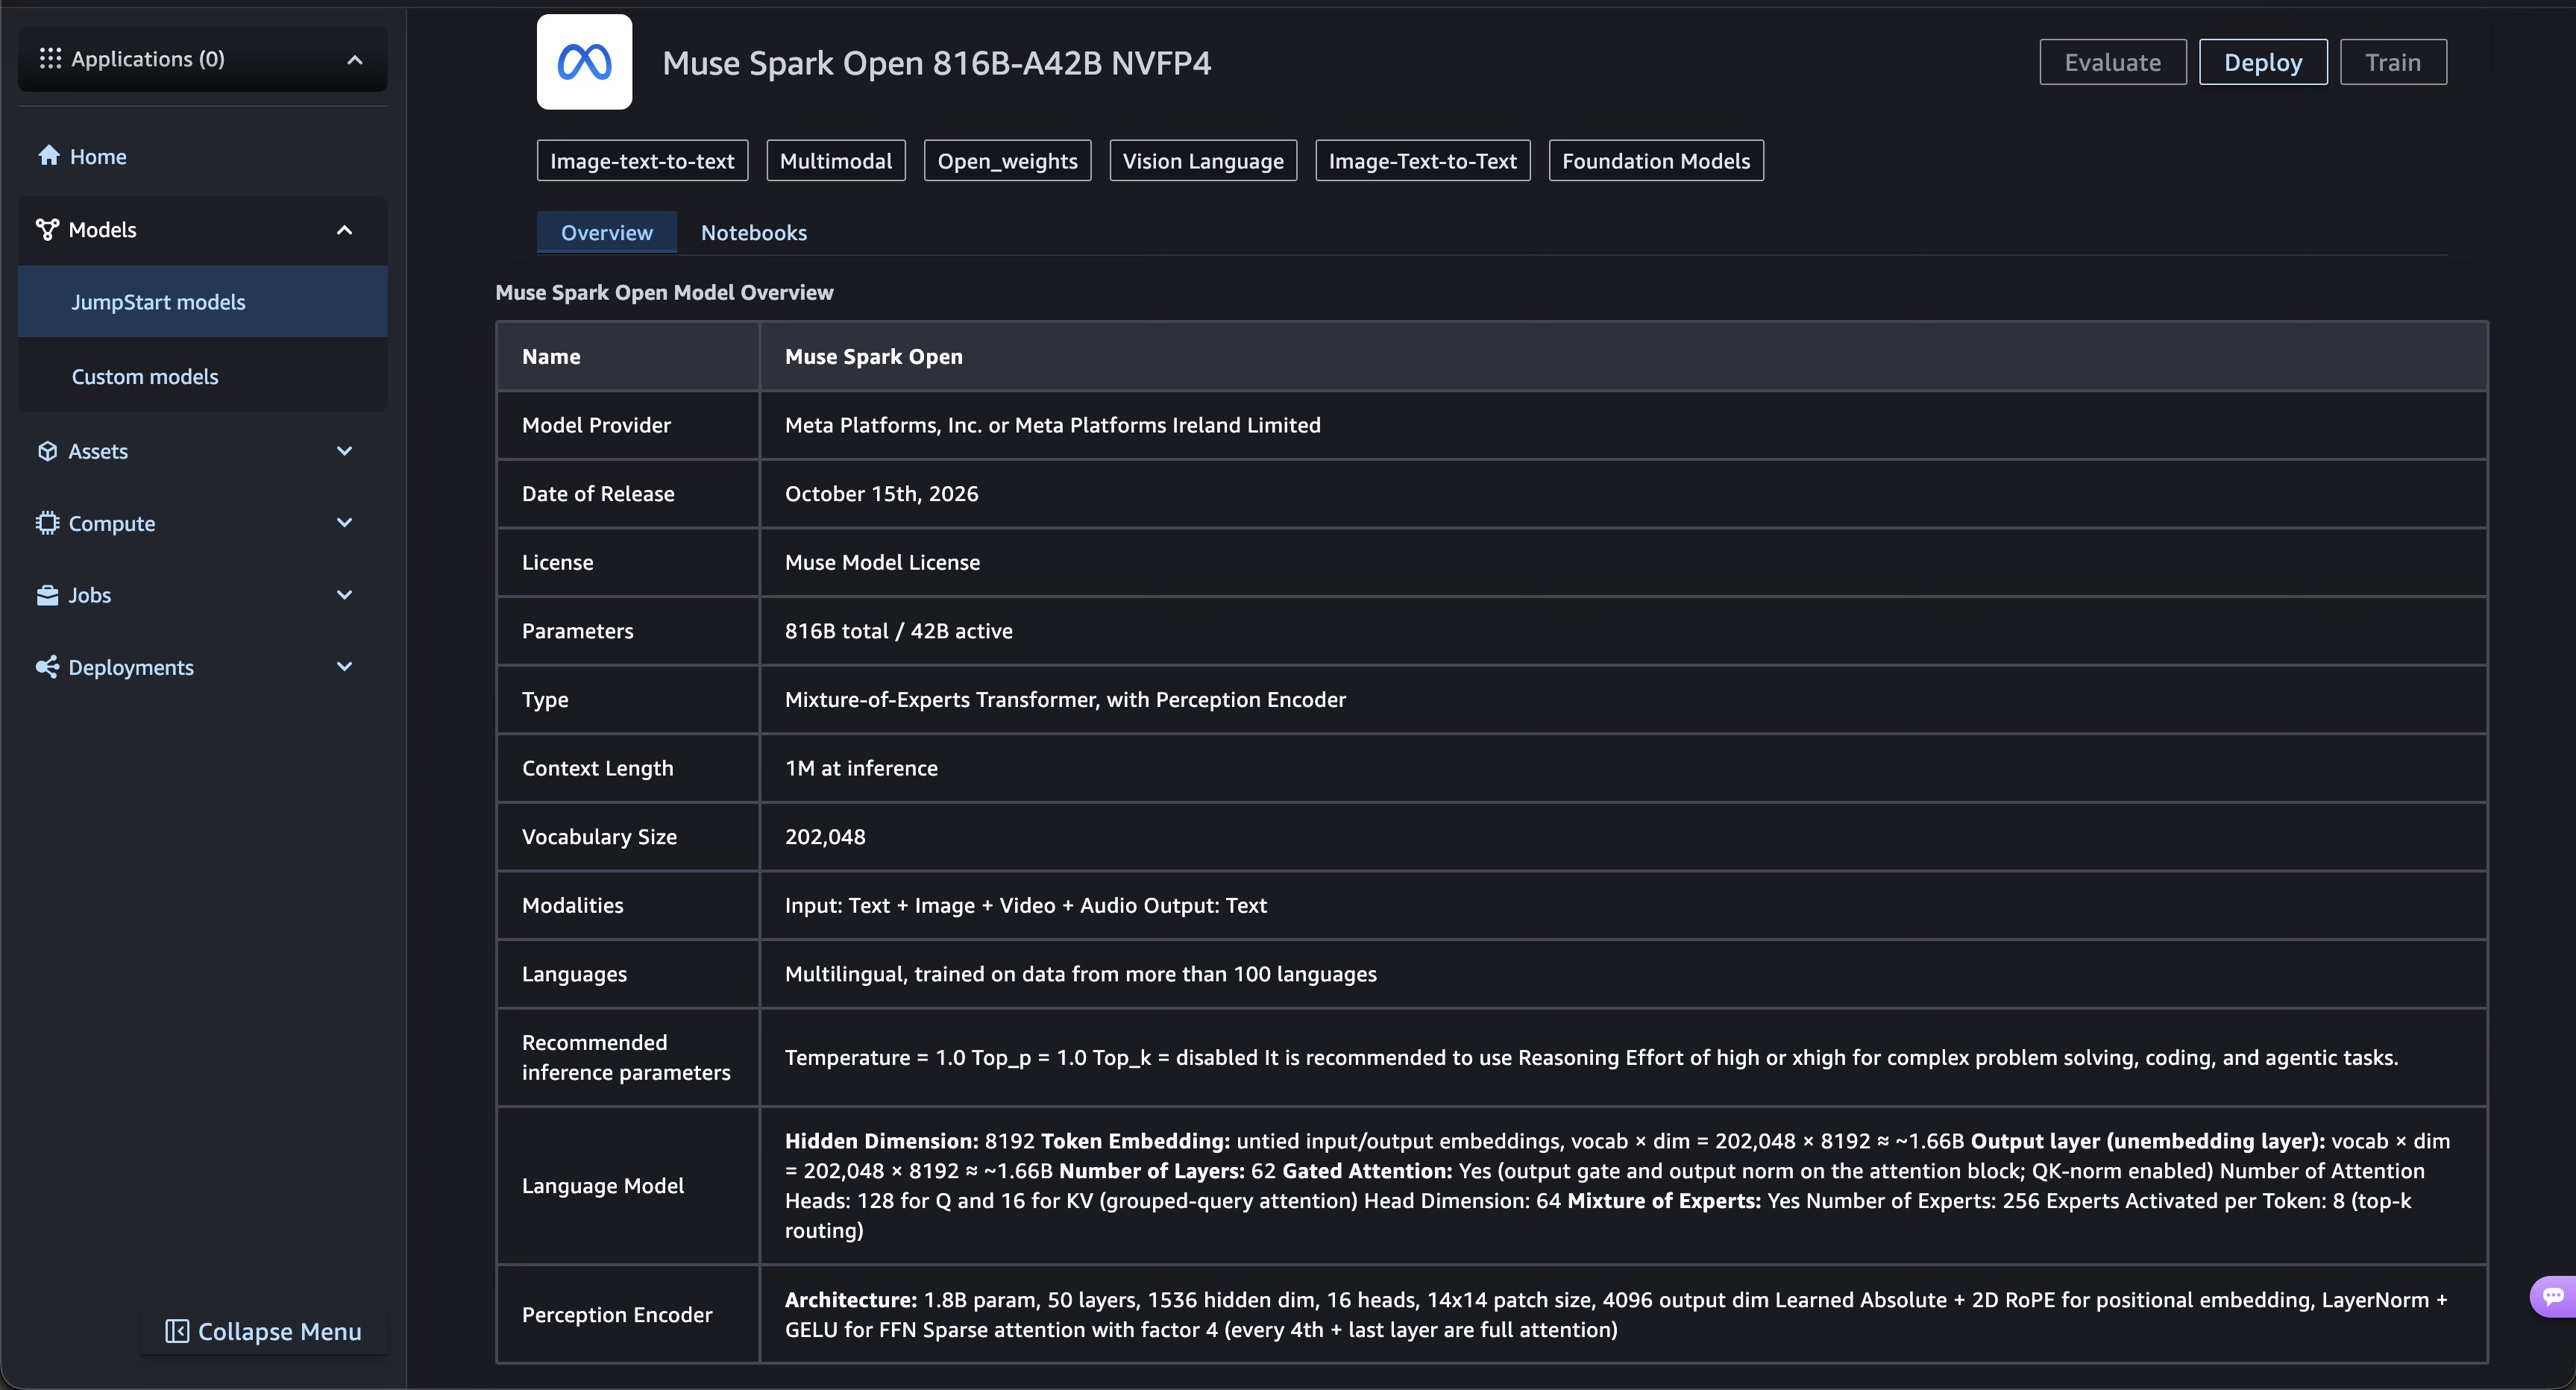
- MoE構成で総パラメータ8160億、1トークンあたり有効420億、コンテキストは100万トークン
- BF16版とNVFP4量子化版の2種類があり、利用するインスタンスと必要メモリが異なる
SageMaker JumpStartで提供開始
Metaのコーディング向けオープンウェイトモデル「Muse Spark Open」が、Amazon SageMaker AIの機械学習モデルハブであるSageMaker JumpStartで利用できるようになった。利用者は自分のAWSアカウント内にSageMaker AIエンドポイントとして配備でき、サービング基盤を自分で管理する必要はない。提供されるのはBF16版(Muse-Spark-Open-816B-A42B)と、NVFP4で量子化した版(Muse-Spark-Open-816B-A42B-NVFP4)の2種類とされている。
学習には実際の開発者の作業が使われたと説明されており、複数ファイルにまたがるリファクタリングや長時間のデバッグセッションが例として挙げられている。コンテキストウィンドウは100万トークンで、配備はSageMaker StudioかSageMaker Python SDKから行う手順が記事では示されている。配備後はOpenAI互換のチャット形式のペイロードで推論リクエストを送れる。
816BのMoEと100万トークン
Muse Spark OpenはMoE(Mixture of Experts、入力に応じて一部のエキスパートだけを使う構成)を採用し、総パラメータ数は8160億、1トークンあたりに有効になるパラメータは420億とされている。非常に大きなネットワークの容量を持ちながら、トークンごとに使う計算量はより小さい密なモデルに近い水準に抑えられる点が特徴だ。重みはMuse Model Licenseのもとで公開され、Muse Spark Usage Policyが含まれる。
また、このモデルは推論モデル(reasoning model)として位置づけられ、入力としてテキスト、画像、ドキュメント、音声、音声付き動画を受け取り、テキストを返す。SageMaker AIのエンドポイントは最終的な回答とあわせてモデルの推論過程も返すため、エージェントが何をどのような理由で行っているかを追いやすくなっている。
エージェント前提の設計
MetaはMuse Spark Openを最初からエージェント向けのモデルとして設計したと説明している。単発のツール呼び出しではなく、計画を立て、実行し、結果を観察し、長い時間軸の中で自己修正することを想定しているという。タスクに取りかかる前に考える推論モデルであるため、処理の進み方を確認しながら使える。
Metaは、Webの閲覧、分割できる作業をサブエージェントに委任する動作、デスクトップ・モバイル・ブラウザ上でのコンピュータ操作を学習させたと述べている。ただしこれらはモデル側が持つ能力であり、SageMaker AI上ではアプリケーションやエージェントフレームワークが、モデルが呼び出すツール・ブラウザ・コンピュータ利用環境を提供する役割を担う。コード以外にも、画像・ドキュメント・音声・動画を推論の対象とする。
2つのバリアントと配備要件
配備方法を左右する性質が2つある。スパースな活性化によってトークンあたりの計算量は小さく抑えられるが、8160億のパラメータすべてを保持するGPUメモリは依然として必要になるため、インスタンス選定はメモリ容量が基準になる。NVFP4版は重みをNVIDIAの4bit浮動小数点形式で保存するため、BF16の重みと比べておよそ4分の1のメモリで済む。
その違いが利用するインスタンスを決める。NVFP4版はml.p5e.48xlarge、BF16版はml.p6-b300.48xlargeで動作する。コストを意識してサイジングする場合はNVFP4版をまず試すのがよいとされ、品質が自分の用途に合うかどうかは自社のワークロードで評価して確認する必要がある。配備はインスタンスの準備と重みの読み込みのため、通常15〜20分かかるとされている。
エンドポイントは自分のAWSアカウント内で動くため、ソースコードやプロンプトは自分で設定・管理する基盤上で処理される。Amazon VPCへの接続、AWS Key Management Service(AWS KMS)の鍵によるストレージボリュームの暗号化、コンテナのネットワーク分離を有効にできる。インスタンス種別やスケーリング上限も選択でき、モデルバージョンを固定すれば再配備しない限りモデルは変わらない。
現時点の注意点
公開時点でMuse Spark OpenがSageMaker JumpStartから利用できるリージョンは、米国東部(バージニア北部)と米国東部(オハイオ)の2つとされている。ほかのリージョンでの提供状況は、利用するリージョンのSageMaker JumpStartを開いて確認する必要がある。
Muse Spark Openはgated model(利用条件への同意が必要なモデル)で、配備時にエンドユーザーライセンス契約(EULA)への同意が求められる。SDKから配備する場合はaccept_eula=Trueを指定する。エンドポイントはマルチGPUインスタンス上で動作し、リクエストを処理していない間も起動している限り課金されるため、不要になったら削除する必要がある。料金はAmazon SageMaker AIの料金ページを参照するとされている。
| 項目 | BF16版 | NVFP4版 |
|---|---|---|
| モデルID | meta-vlm-muse-spark-open-816b-a42b | meta-vlm-muse-spark-open-816b-a42b-nvfp4 |
| 重みの形式 | BF16 | NVIDIAの4bit浮動小数点形式 |
| 必要なメモリ | 比較の基準 | BF16の重みのおよそ4分の1 |
| 対応インスタンス | ml.p6-b300.48xlarge | ml.p5e.48xlarge |
With the 1 million-token context window, the model can take in a whole project, including its dependencies, legacy code, and thousands of files.
100万トークンのコンテキストウィンドウにより、このモデルは依存関係やレガシーコード、数千のファイルを含むプロジェクト全体を取り込むことができる。
今後の見通し
Muse Spark Openは公開時点で米国東部の2リージョンに限られるため、次に着目すべきは対応リージョンの広がりと、実際のリポジトリでの品質・コストの評価結果とみられる。Metaは学習に実際の開発者ワークフローを使ったと説明しているが、具体的なベンチマーク値はこの記事では示されていない。自社コードでの評価が推奨されている以上、まずNVFP4版で試し、品質が要件を満たすかを確認する流れが現実的だろう。gated modelであるため、ライセンス条項の内容と利用条件を事前に確認しておきたい。長期的には、サブエージェントの委任やコンピュータ操作といったエージェント機能を、SageMaker AI側のツール提供とどう組み合わせるかが実運用上の焦点になるとみられる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって第一の意味は、大規模なコーディング向けモデルを、自社管理下のAWSアカウント内で運用できる選択肢が増えることだ。ソースコードやプロンプトを外部に出すことなく処理でき、VPC接続やAWS KMSによる暗号化、ネットワーク分離を選べるため、機密性の高いリポジトリを扱う案件でも検討しやすくなる。100万トークンのコンテキストは、依存関係やレガシーコードを含むプロジェクト全体を一度に渡せることを意味し、タスクを分割する設計上の制約が緩む可能性がある。一方で、8160億パラメータを保持するマルチGPUインスタンスが必要で、起動中は課金され続けるため、常時稼働させる使い方ではなく評価やバッチ的な利用から始める判断が現実的だ。エージェント機能を使うにはツールや実行環境を自前で用意する必要があり、フレームワーク側の実装コストも見込んでおきたい。
気になる点
- 日本からでも使えるのか、どのリージョンで提供されているのか
- 公開時点でSageMaker JumpStartからMuse Spark Openを利用できるのは米国東部(バージニア北部)と米国東部(オハイオ)の2リージョンとされている。日本国内リージョンでの提供可否はこの記事では触れられておらず、現時点では公表されていない。利用するリージョンのSageMaker JumpStartを開いて確認する必要がある。
- BF16版とNVFP4版はどう選べばよいのか
- NVFP4版は重みを4bit形式で保存するため、BF16の重みのおよそ4分の1のメモリで済み、ml.p5e.48xlargeで動作する。BF16版はml.p6-b300.48xlargeが対応インスタンスとされている。コストを意識するならNVFP4版をまず試し、品質が自分の用途に合うか自社ワークロードで評価することが推奨されている。
- 既存のアプリケーションから呼び出せるのか
- エンドポイントはOpenAI互換のチャット形式のペイロードを受け取り、チャット補完を返す。最終回答はmessage.content、モデルの推論過程はmessage.reasoning_content、推論に使ったトークン数はusage.reasoning_tokensで取得できる。ストリーミングにも対応しており、リクエスト本文にstreamを指定して専用メソッドを呼ぶ。
用語解説
- MoE(Mixture of Experts)
- 複数のエキスパートと呼ばれる部分ネットワークを用意し、入力に応じて一部だけを使う構成。総パラメータを大きくしつつ、1トークンあたりの計算量を抑えられる。
- コンテキストウィンドウ
- モデルが一度に読み込めるトークン数の上限。ここでは100万トークンで、プロジェクト全体をまとめて入力できる規模とされる。
- NVFP4
- NVIDIAの4bit浮動小数点形式。重みをこの形式で保存すると、BF16と比べておよそ4分の1のメモリで済むとされる。
- SageMaker JumpStart
- Amazon SageMaker AIに含まれる機械学習モデルのハブ。モデルを選び、自分のアカウント内にエンドポイントとして配備できる。
- gated model
- ダウンロードや配備の前に利用条件への同意が必要なモデル。SageMaker JumpStartでは配備時にEULAの同意が求められる。
出典
Meta’s Muse Spark Open now available in Amazon SageMaker JumpStart
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する