- i14のLaplace 3BはGLA採用の線形注意モデルで、推論状態は系列あたり29.5MBと文脈長に依存しない
- AWSのGenAIICがGPU向けTritonカーネルをPyTorch演算子に書き換え、TorchNeuron Nativeのベータ版で稼働させた
- trn2.48xlarge 1台で学習は毎秒約12万トークン、推論は1,280系列同時で毎秒11,544出力トークン
発表された内容
i14が設計した線形注意ベースの大規模言語モデル「Laplace 3B」を、AWSのTrainium2上で学習・推論した結果が報告された。協力したのはAWSのGenerative AI Innovation Center(GenAIIC)のチームで、ネイティブPyTorchのバックエンドであるTorchNeuron Nativeのベータ版を使い、独自アーキテクチャをTrainium2に持ち込んだ。この際、Gated Linear Attention(GLA)の設計とMuonオプティマイザはそのまま維持されている。
学習はtrn2.48xlarge 1台で毎秒約12万トークン、推論は同じインスタンスで1,280系列を同時に処理して毎秒11,544出力トークンという結果だった。記事はモデルの構造、Trainium2向けに加えた変更、学習と推論の実測値を順に説明している。
線形注意とGLAの仕組み
一般的なLLMはsoftmax注意を使うため、推論時にキーと値を保持するKVキャッシュが会話や文書の文脈長とともに増えていく。これは同時実行数を下げ、サービングコストを押し上げ、エージェント型アプリケーションが有用な履歴を捨てざるを得ない状況を生む。Laplace 3Bはこの問題に対して、Gated Linear Attention(GLA)で過去の文脈を固定サイズの行列状態に圧縮する approach を採る。
系列あたりの再帰状態は29.5MBで、文脈長に関係なく一定だ。学習時の注意計算は系列長Tに対してO(T²)からO(T)へ、推論は1トークンあたりO(1)になる。モデルは24層のデコーダで、次元は3,072、ヘッド数16、ヘッドあたりの次元はdk=96とdv=192、FFNの内部次元は8,192とされている。
各ヘッドの減衰率は学習されず、初期化時に幾何スケジュールで固定される。16個のヘッドに記憶長のばらつきを持たせる設計で、ヘッドごとに過去を忘れる速さが異なる仕組みになっている。
Trainium2向けの3つの変更
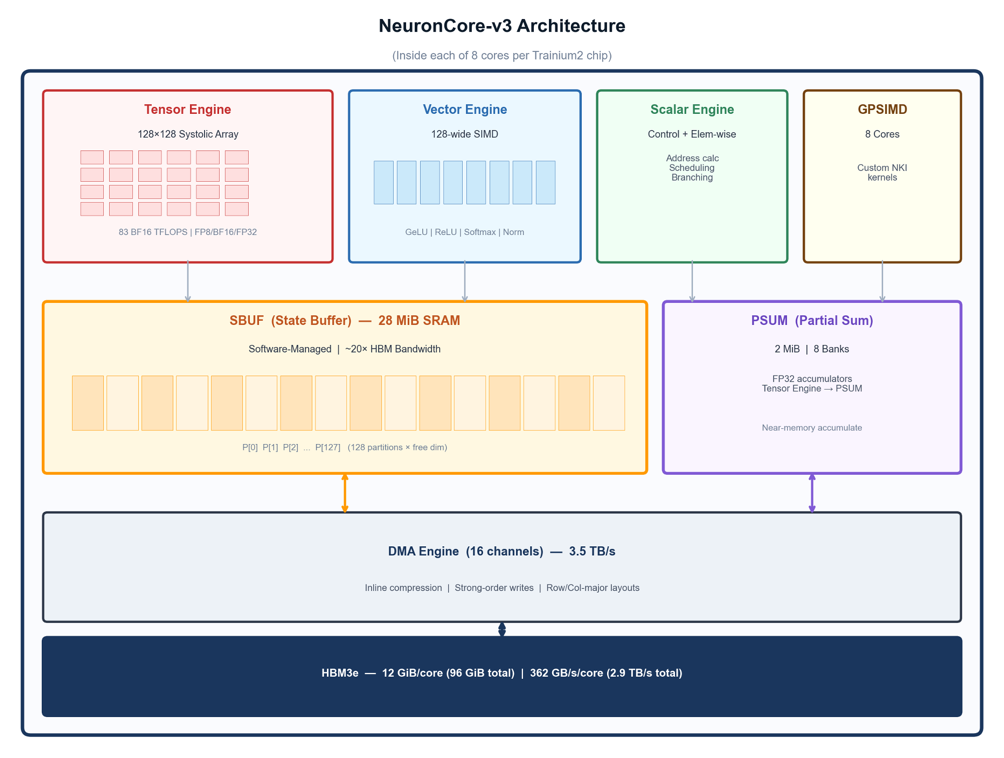
元の実装はGPU向けに最適化されたTritonカーネル「fused_chunk_simple_gla」を使っていた。GenAIICのチームはまずGLAカーネルを標準のPyTorch演算子で書き直し、両方式を比較したうえで、性能が良かったTorchNeuron Nativeのベータ版を選択した。チャンク数は16、1チャンクは128トークンで、NeuronCoreのオンチップバッファが128パーティションに分かれていることに対応させている。この対応によりスループットが14%向上したという。
2点目はMuonオプティマイザの通信設計である。FSDP2では各ランクが重みの1/64しか持たないため、2回のall_to_allで完全な行列を各ランクに配り直す方式に変更した。ランクあたりの通信量は10.87GBから0.45GBへ24分の1になり、スループットは毎秒73,378トークンから119,934トークンへ1.63倍に上がり、損失曲線はビット単位で同一だったとしている。
3点目は逐次的な再帰の後方パスの扱いだ。Trainium2のコンパイラはグラフを事前に把握する必要があるため、16チャンク分の状態更新を静的にアンロールし、グラフサイズとオンチップメモリの制約に収めた。
学習と推論の実測値
学習は64個の論理NeuronCoreをすべて使い、all_to_allによるMuonの経路で実行された。フルレシピは190,735ステップ(FineWeb-Eduの1,000億トークン)で、公開されている結果は84,210ステップ、約440億トークン時点のものだ。損失は約11.4から2.3729まで滑らかに低下し、勾配ノルムは初期のスパイクのあと約0.05へ落ち着いた。ウォームアップ後のスパイクや発散、NaN/Infは確認されていない。
推論は未改修のvLLMエンジンで行われ、1,280系列の同時実行で毎秒11,544出力トークンを記録した。プロンプトを2,048トークンから8,192トークンに伸ばしても、出力トークンあたりのコスト増は0.5%にとどまったという。BF16で3プロンプト×48ステップの出力がi14のリファレンスとトークン単位で一致したことも報告されている。
現時点での注意点
線形注意は過去のキーと値を保持するのではなく履歴を圧縮するため、検索品質はワークロードごとに評価する必要がある、と記事は述べている。KVキャッシュ方式との精度比較の数値は今回示されていない。
学習結果はフルレシピの途中である84,210ステップまでのもので、残りのステップでの挙動は明らかになっていない。また原文は「フルインスタンスへのスケーリング」の箇所で途切れており、それ以降の内容は確認できない。モデルの公開範囲やライセンス、利用料金についても記載がない。
| 項目 | 全勾配をgather+broadcast | all_to_all転置(MuonFSDP2) |
|---|---|---|
| ランクあたり通信量 | 10.87 GB | 0.45 GB |
| 通信量の削減率 | 基準 | 24分の1 |
| スループット | 毎秒73,378トークン | 毎秒119,934トークン |
| 損失曲線 | — | ビット単位で同一 |
The 29.5 MB recurrent state per sequence is roughly 82 times smaller than a comparable KV cache at 8,192 tokens.
系列あたり29.5MBの再帰状態は、8,192トークン時点の同等のKVキャッシュと比べて約82分の1です。
今後の見通し
線形注意モデルをTrainium2で動かすための具体的な実装手順が示されたことで、独自アーキテクチャをAWS上で学習・提供する選択肢が広がるとみられる。GLAカーネルのPyTorch書き換えやall_to_allを使ったMuon通信の設計は、他のカスタムモデルにも応用できる可能性がある。ただし公開されている学習結果は予定ステップの約44%時点にとどまり、長文脈での検索品質や複数インスタンスに広げた場合の性能は明らかになっていない。フルレシピ完了時の損失、品質ベンチマーク、trn2.48xlargeの料金が示されれば、実務での採用可否を判断しやすくなる。
日本の開発者・IT企業にとっての意味
日本のIT企業にとって注目すべきは、カスタムアーキテクチャを動かすために独自カーネルを書く必要が薄れつつある点だ。GPU向けのTritonカーネルを標準PyTorch演算子に置き換え、TorchNeuron Nativeのベータ版で動かせたという報告は、AWS上でモデル構造を変えるハードルが下がることを示す。長文の文書解析や長時間動くエージェントでは、文脈長によらず推論状態が29.5MBで一定という性質が、同時実行数の見積もりを立てやすくする可能性がある。一方で、履歴を圧縮する方式は検索品質の評価が必須であり、既存のRAGや検索処理の精度を同じ指標で測り直す必要がある。未改修のvLLMで動いた点は移行コストの面で有利だが、対応バージョンやライセンス、料金は不明なままだ。
気になる点
- 既存のvLLM環境でLaplace 3Bを動かせますか
- 記事によれば、未改修のvLLMエンジンで提供できたとされています。デコーダ層ごとにトークンミキサーという1つの属性をラッパーで置き換え、モデルが自身をattention-freeと宣言するため、vLLMは系列ごとに固定1ページを割り当てます。ただし対応するvLLMのバージョンや公開条件は原文に記載がありません。
- KVキャッシュをやめると品質は落ちませんか
- 線形注意は過去のキーと値をすべて保持するのではなく固定サイズの状態に圧縮するため、記事はワークロードごとに検索品質を評価するよう促しています。今回の記事には精度のベンチマーク数値が示されておらず、KVキャッシュ方式との品質比較は現時点では公表されていません。
- 日本企業も同じ構成を試せますか
- 技術的にはAWSのTrainium2インスタンスとTorchNeuron Nativeのベータ版が前提で、記事はtrn2.48xlarge 1台での結果を報告しています。ただしインスタンスの料金、Laplace 3Bの公開状況やライセンス、TorchNeuron Nativeの一般提供時期は原文に記載がなく、現時点では公表されていないとしか言えません。
用語解説
- KVキャッシュ
- 推論時に過去トークンのキーと値を保持しておくメモリ。文脈が長くなるほど大きくなり、同時実行数を制約する。
- 線形注意
- 注意計算を再帰的な状態更新として扱う方式。系列長に対する計算量を線形に抑え、推論状態を固定できる。
- GLA
- Gated Linear Attentionの略。ヘッドごとに減衰する行列状態で過去の文脈を圧縮する線形注意の一種。
- FSDP2
- Fully Sharded Data Parallelの新版。モデルのパラメータを複数のランクに分割して保持する分散学習手法。
- Newton–Schulz法
- 行列の直交化を反復計算で近似する手法。Muonオプティマイザが勾配の直交化に用いる。
- TorchNeuron Native
- AWS Trainium向けのネイティブPyTorchバックエンド。記事ではベータ版が使われた。
出典
Beyond the KV cache: Training and serving i14’s Laplace 3B linear attention model on AWS Trainium2 with native PyTorch
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する