- 評価ラベルの96.8%が既存モデルの予測由来で、代替モデルが構造的に不利になっていた
- 専門家が356枚の画像を新規アノテーションし、マルチラベル化で誤評価の原因を解消
- プロンプトをv0からv27まで反復改善し、Micro F1 0.55→0.81、コスト86%削減
何が起きたのか
Property Finderは中東・北アフリカ(MENA)向けに不動産情報アプリを提供する企業で、1日あたり数万枚の物件画像を処理している。画像1枚につき透かし検出、部屋の分類、家具の有無、写真品質、建設状況など11の品質属性を判定し、平均15枚の画像を持つ新規物件を公開前に評価している。AWSの生成AIイノベーションセンターとの共同作業で、より低コストなモデルへ移行しようとした際に、評価手法そのものが障害になっていることが分かった。
発表によると、同社の評価用ラベルの96.8%は既存の視覚言語モデル(VLM)の予測をそのまま正解として使ったものだった。人手による検証を経たサンプルは3.2%にとどまる。この状態では、代替モデルは「現行モデルの出力にどれだけ似ているか」で採点されることになり、実際の正しさとは無関係に不利になる。
評価が循環する構造
記事はこの構造を「循環評価」と呼んでいる。現行モデルは本番環境で動いており大きな苦情も出ていないため、その出力は十分な正解に見える。しかし、置き換えたいモデルの答えを物差しにして別のモデルを測れば、比較そのものが成立しない。
さらにラベルには隠れた誤りもあった。透かしの文字抽出では、存在しないブランド名の生成や文字の欠落が「正しい」と記録されていた。写真分類では複数の部屋が写る画像に単一ラベルを強制していた。人手で付けた3.2%のサンプルにも、仕様にないカテゴリ(例: Office)が混入していたという。
正解データの作り直し
バイアスを断ち切るため、同社は過去のモデル出力を一切参照せず、不動産掲載品質の専門知識を持つ担当者が新規にアノテーションした。対象はUAEの356枚で、エジプトの230枚は地域横断の確認用として別途用意された(本記事では結果を報告していない)。最初に注釈した256枚をチューニング用の開発セット、全356枚を最終比較用の評価セットとしている。
単一ラベルからマルチラベル分類への変更も大きな改善だった。廊下の写真に扉越しの寝室が写っている場合、両方が正解になり得る。複数ラベルを許容することで、妥当な副次予測を減点せずに済む。評価指標はMicro F1を主軸に、頻出クラスに引っ張られて希少属性の弱点が隠れるのを補うためMacro F1を併記し、ラベル別の適合率・再現率、画像ごとのIoUも使った。単一ラベル9属性については完全一致の精度も算出している。
プロンプト最適化の反復
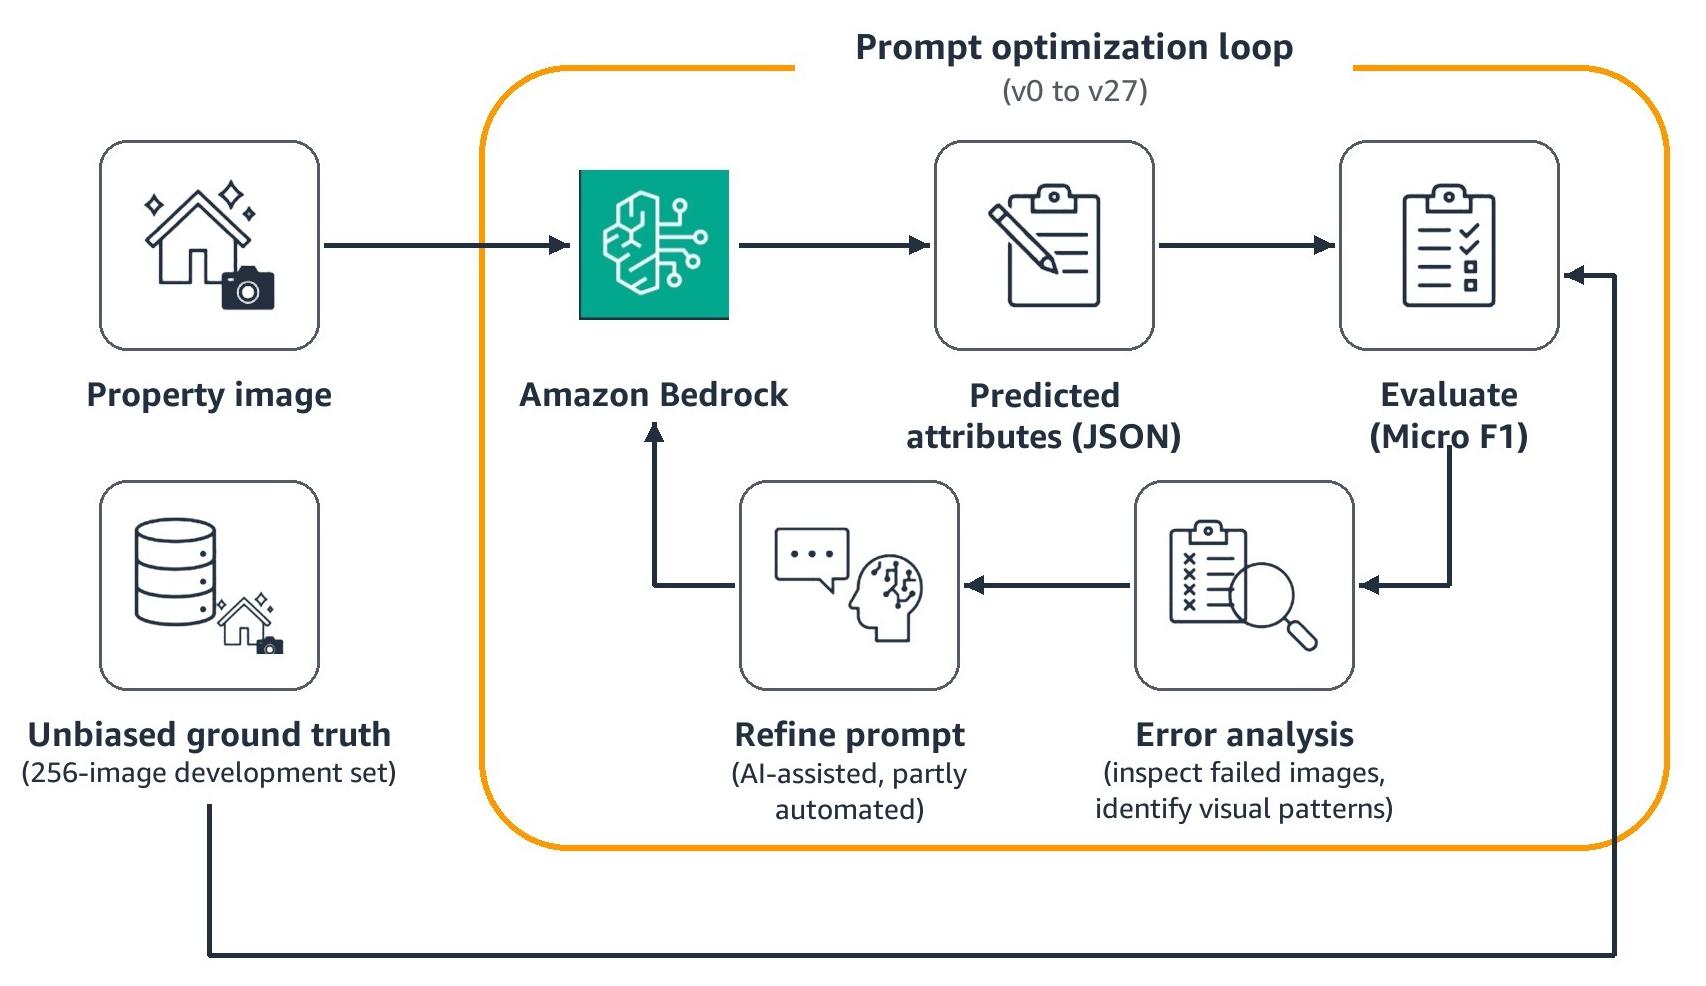
評価の土台ができた後、AWSのチームはプロンプトの改善をv0からv27まで反復した。各プロンプト版をエージェント、Micro F1を報酬、画像ごとのエラー分析を勾配に見立てた強化学習に似たループで、失敗画像から視覚的なパターンを見つけて次の版に反映する。記事ではGEPA(Genetic-Pareto reflective prompt evolution)に近い考え方だと説明されている。
初期の単一ラベル版では、扉越しに見える部屋を誤って主たる部屋として分類していた。そこで「フレームの大部分を占める部屋で分類する」という明示的な指示を加えた。地域特有の装飾的なアラビア文字を透かしと誤検出する問題も、ルール化で除去した。v21で写真分類と部屋カテゴリをマルチラベル出力に切り替え、全モデル共通の開始プロンプトとした。その後はモデルごとに個別調整し、v27ではDSPyライブラリの自動プロンプト最適化フレームワークMIPROv2で写真分類タスクを再構成している。
結果と注意点
開発セット(256枚)で、プロプライエタリモデルAは自系統向けに調整したv22でMicro F1 0.55だった。Llama 4 Maverick 17B Instructは共通のv21で0.75、個別調整後のv27で0.81に達した。Property Finderが最終的に採用したv27_PFは、レンダリング画像、枠付き画像、廊下などへのルールを追加した版である。評価セット(356枚)ではLlama 4 Maverick 17B Instructが0.80、プロプライエタリモデルAが0.56だった。
ただし記事は、この数値が楽観的だと明記している。評価セットには開発用の256枚が含まれ、両モデルのプロンプトはその画像で調整されているためだ。モデルをAからLlama 4 Maverick 17B Instructに替え、それぞれ自系統のプロンプトを使った場合、開発セットのMicro F1は0.55から0.81へ上昇し、相対で47%の改善となる。コストは86%削減されたという。一方、透かし属性とその他属性を2回のAPI呼び出しに分ける方式や、汎用的なプロンプトは精度が伸びなかったとも報告されている。
| 項目 | プロプライエタリモデルA | Llama 4 Maverick 17B Instruct |
|---|---|---|
| 開発セットのMicro F1 | 0.55(v22) | 0.81(v27) |
| 評価セットのMicro F1 | 0.56(v22) | 0.80(v27_PF) |
| 共通プロンプトv21でのMicro F1 | 記載なし | 0.75 |
| コスト | 比較の基準 | 86%削減 |
Of their labeled samples, 96.8 percent came directly from the predictions of the existing vision language model (VLM) rather than independent human verification.
同社のラベル付きサンプルのうち96.8%は、独立した人手による検証ではなく、既存の視覚言語モデル(VLM)の予測をそのまま引き継いだものだった。
今後の見通し
今回の事例は、モデル選定の前に評価データの出所を疑うという手順の重要性を示している。同様の循環評価は、本番モデルの出力をそのまま正解として蓄積してきたチームなら程度の差こそあれ抱えている可能性があるとみられる。次の判断材料になるのは、マルチラベル化や専門家注釈にかかるコストをどう抑えるかだ。記事では複数モデルの不一致を人手で裁定するハイブリッド方式が将来の拡張案として挙げられているが、効果や運用負荷は示されていない。評価セットを開発セットから完全に分離した場合にスコアがどこまで下がるかも、現時点では不明である。
日本の開発者・IT企業にとっての意味
日本企業でも、既存モデルの出力をそのまま正解ラベルとして評価データセットを作る運用は珍しくない。今回の事例は、その習慣が代替モデルの導入判断を誤らせることを具体的な数値で示している。モデルを乗り換えたいが精度が落ちる、と結論づける前に、評価データの96.8%が現行モデル由来ではないかを確認する価値がある。実務面では、専門家による再注釈とマルチラベル化に工数がかかる点が導入の壁になる。一方で、プロンプト最適化を反復する枠組みと、Micro F1・Macro F1・ラベル別指標を組み合わせた評価設計は、業種を問わず流用しやすい。コスト86%削減という結果は、評価の作り直しに投資する根拠として参考になる。
気になる点
- 同じ手法は日本の開発現場でも使えるのか
- 手順自体は特定の業種に依存しません。ラベルの由来を確認し、モデル出力を参照しない独立した人手注釈で正解データを作り、プロンプトを反復改善するという流れです。ただしドメイン知識を持つ注釈者を確保できるかどうかが効果を左右するとみられます。
- ラベルは何枚あれば足りるのか
- 記事ではUAEの356枚(開発用256枚と追加100枚)を使い、モデル間の中程度の差を検出するには概ね十分としています。一方、属性ごとの希少クラスは例数が少なく、小さな差は検出できない可能性があるとも明記されています。
- コストは具体的にいくらになるのか
- 記事には金額や単価は示されておらず、プロプライエタリモデルAと比べて86%低いという相対値のみです。日本リージョンでのモデル提供状況や料金は、Amazon Bedrockのリージョン別対応モデル一覧で確認する必要があります。
用語解説
- Micro F1
- 全予測を等しく重み付けして算出する調和平均。頻出クラスの影響が大きく、全体の正解率に近い指標として使われる。
- グラウンドトゥルース
- 評価の基準となる正解データ。モデル出力を流用すると循環評価になり、比較の妥当性が失われる。
- 視覚言語モデル(VLM)
- 画像とテキストを組み合わせて扱うモデル。物件画像の属性判定のように、画像に対する分類や説明の生成に用いられる。
- プロンプト最適化
- モデルへの指示文を反復的に書き換え、出力精度を高める手法。エラー分析をもとに版を重ねる方式が一般的。
- IoU
- Intersection over Union。2つのラベル集合の重なり具合を測る指標で、画像ごとの予測と正解の一致度を表す。
- MIPROv2
- DSPyライブラリに含まれる自動プロンプト最適化フレームワーク。指示文と例の構成を自動で探索する。
出典
Fix evaluation bias to unlock better models on Amazon Bedrock
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する