- Together AIがエージェントで推論を継続最適化する「Together Compiler」を発表
- 24時間未満で最大2.6倍のTPS、低レイテンシで1111〜1205 TPSを記録と主張
- エンジンを再起動せず候補をホットリロードする「常駐エンジン」が中核
何が発表されたのか
Together AIは2026年11月4日、AI推論ワークロードを継続的に自動最適化する仕組み「Together Compiler」(略称TKCC)を公表した。エージェント(自律的に試行錯誤して課題を解くソフトウェア)が最適化候補を生成し、それを推論エンジン上で検証するループを回す点が特徴である。同社はこれを「真に継続的な最適化ループ」を実現した最初の事例と位置づけている。
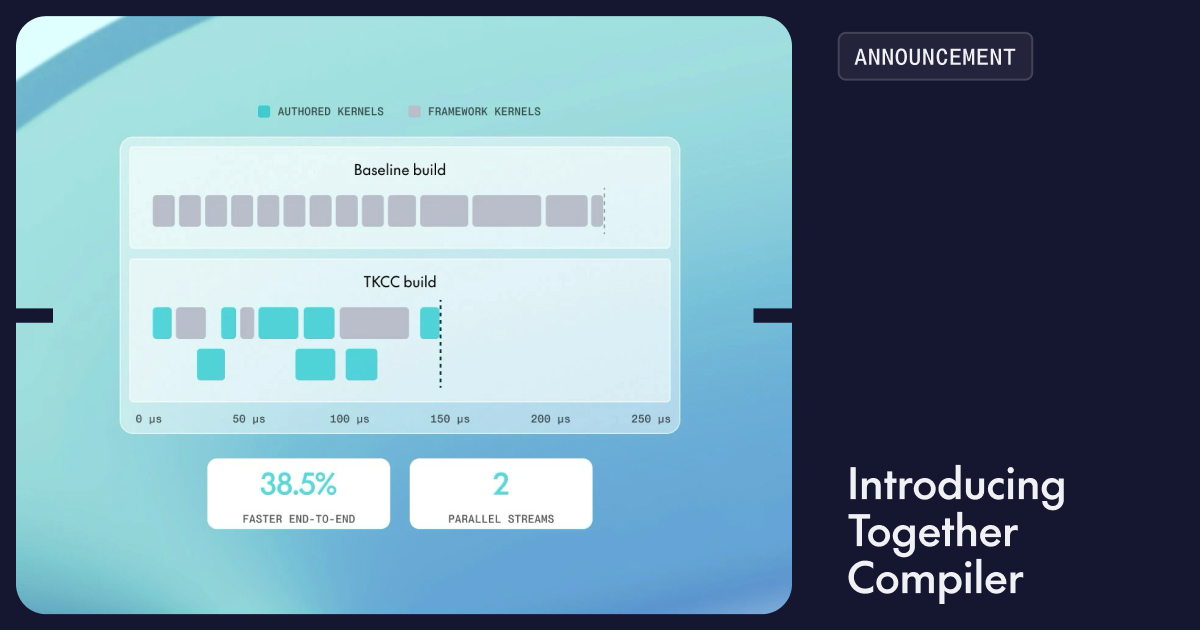
同社の報告によれば、24時間未満でフロンティアのオープンソースモデル(Kimi K3、GLM 5.3、MiniMax M3.1-Flash、DeepSeek v4.1-Flash)において最大2.6倍のTPS(1秒あたりのトークン処理数)を達成した。さらにSemiAnalysisのInferenceXベンチマークの低レイテンシ部門で、MiniMax M3.1-Flashで1111 TPS、DeepSeek v4.1-Flashで1205 TPSを記録し、最先端の性能を示したとしている。
Together Compilerはすでに同社の推論基盤で稼働しており、毎日数兆トークンの処理に使われているという。研究成果は論文として公開されている。
手作業の最適化が限界になる背景
同社は、推論ワークロードが「数千のレジーム」に分かれると説明する。レジームとはモデル・ハードウェア・顧客・ユースケース・トラフィック形状の組み合わせを指す。アーキテクチャの面ではTransformerの登場から約11年が経つが収束は見られず、OpenRouter上のトップ10オープンソースLLMに同じアーキテクチャは一つもないという。ハードウェアもH100、B200、B300、NVL72、Groqなど多様で、それぞれ別の戦略が必要になる。
トラフィックも絶えず変わる。同社は、ある国の営業時間帯のトラフィックは別の国よりプロンプト長が1.4倍长い(97k対70k)といった地域差を観測している。新しいモデルが公開されると、まずチャット形式での評価が始まり、2週間後にはエージェント的な用途に移行してプロンプト長が80%増える傾向があるという。さらに顧客からのリクエストはランダムにバーストし、プロンプト長が突然2倍になったりキャッシュヒット率が下がったりする。
こうした環境では固定ルールやヒューリスティクスに頼る最適化は通用しにくい。エージェントによる探索は理論上適しているが、同社は今日のエージェント型システムが「実験の速度」でボトルネックになっていると指摘する。
設計の3つの要点
第一の要点は、GPUの遊休時間を減らして実験スループットを最大化することだ。既存のエージェント型最適化システムは、実験ごとにVLLMやSGLang、TRT-LLMといったエンジンを起動・破棄する必要があり、起動に数十分かかることが実験速度を大きく妨げていた。TKCCは一度起動したエンジンに候補のforward passをホットリロードする「常駐エンジン」という方式を採る。複数のエージェントがメッセージボードで連携しながら、並列に候補を出し続ける。
第二の要点は、計測のスループットと忠実度のバランスである。単体カーネルだけを切り出してランダムな入力データで評価すると、実際の推論エンジン内の挙動を反映しにくい。特にMoEやスパースアテンションのようなデータ依存のプリミティブでは、入力分布がどの最適化が勝つかに直接影響する。そこでTKCCは、少数の層だけを読み込む「高速エンジン」と、多くの層を読み込む「低速エンジン」を階層的に使い分ける。前者は素早い反復と分散の小さい計測に、後者は実データ分布で最適化が成立するかの検証に向く。
第三の要点は、並列化戦略を選ぶための独自コストモデルである。TPやEP、DCPといった並列化構成は、ソフトウェア実装が未成熟なこともあり、すべてを実測するのは現実的でない。ハードウェア仕様やマイクロベンチマークだけでは、MoEのエキスパート偏りやプロンプト長の偏りといったデータ依存の性質を捉えきれない。TKCCのコストモデルは、仕様・マイクロベンチマーク・実測forwardを段階的に組み合わせて高精度な見積もりを作りつつ、探索空間を高速に枝刈りする。
ベンチマークで示された数値
まず評価されたのは定番のmegakernelワークロードであるLlama 1Bのbatch size 1で、人手と従来の機械学習コンパイラの双方で最適化が進んだ設定にもかかわらず、TKCCは1.7倍高いTPSを生成し、系列長を伸ばしても優位を維持したという。
InferenceXのAgentXベンチマークでは、推論エンジンとハードウェアの各組み合わせについて公開されている最良のエンジン構成を出発点に、すべての設定で性能のフロンティアを更新し、最大2.6倍のTPSを達成したとしている。低レイテンシ用途では、InferenceXの構成ではなく自社コストモデルで並列化構成を選ぶことで高速化が観測されたという。
LLM以外への汎用性も示されている。気象モデリング、偏微分方程式(PDE)、時系列、生物学の分野で公開されているコードベースを対象に、Claude Codeの/goalコマンドを使う場合と比べた幾何平均の高速化を報告した。同社はTKCCをLLM推論以外にも使える汎用AIコンパイラとして位置づけている。実験スループットは、比較対象のエージェント型性能最適化システムに対して252倍高いとされる。
現時点で分かっていないこと
提示された数値の多くはTogether AI自身による報告であり、本記事の範囲では第三者による再現・検証には触れられていない。比較対象は「公開されている最良のエンジン構成」やオープンソースのmegakernel、Claude Codeの/goalコマンドであり、何を基準にどれだけ改善したのかを読む際にはベースラインの定義を確認する必要がある。
制約も明記されている。Trainium2では、実装が限られたHBM容量のため高い並行度をまだサポートしておらず、AgentXではなく合成のマルチターンデータセット(70k ISL、3.5k new ISL 95% cached、700 OSL)で実行したという。
また、TKCCを外部の開発者が利用できるのか、利用形態や価格がどうなるのかについては、この記事では言及されていない。
| 項目 | 高速エンジン | 低速エンジン |
|---|---|---|
| 読み込む層数 | 少数の層 | 多数の層 |
| 主な用途 | 素早い反復と分散の小さい計測 | 実データ分布で最適化が成立するかの検証 |
Instead, TKCC proposes a new paradigm of "persistent engines" where the engine starts up once and can hot-reload any candidate forward pass, without any restarts.
その代わりにTKCCは「常駐エンジン」という新しいパラダイムを提案する。エンジンは一度起動すれば、再起動なしに任意の候補forward passをホットリロードできる。
今後の見通し
次に注目されるのは、TKCCの効果が第三者環境でも再現されるかどうかである。今回はTogether AI自身の基盤と公開ベンチマークでの結果が中心で、外部の推論事業者が同じ手法を適用した場合の改善幅は明らかになっていない。Trainium2のように現時点で制約が残るハードウェアへの対応が進めば、適用範囲が広がる可能性がある。また、外部向けの提供形態や料金が示されれば、自社運用かマネージド利用かを判断する材料になる。同社が掲げる「Polymorphic Inference」の考え方がどこまで一般化するかは、論文と今後の公開情報を待つ必要がある。
日本の開発者・IT企業にとっての意味
自社でLLM推論を運用する日本企業にとって、モデルの入れ替わりやトラフィックの変化に合わせて推論設定を人が調整し続けるコストは無視できない。TKCCの主張が正しければ、エージェントに継続的な最適化を任せるという選択肢が現実味を帯びる。ただし現時点で外部提供は不明なため、すぐに導入を検討するというより、設計思想を自社の運用に移植できないかを見る段階といえる。押さえるべきは「常駐エンジンで実験の起動コストを消す」「計測を階層化して速度と忠実度を両立させる」「並列化構成はコストモデルで枝刈りする」という3点である。実務では、公開ベンチマークの数値をそのまま信じるのではなく、自社のトラフィック形状でTPSだけでなくレイテンシ分布やSLA達成率を含めて評価することが重要になる。
気になる点
- TKCCは自社の推論環境に導入できるのか
- 本記事の範囲では、外部提供の有無や導入方法、料金は公表されていない。現時点で分かっているのは、Together AI自身の基盤で稼働し毎日数兆トークンを処理しているという点と、設計思想を説明した論文が公開されているという点である。
- 既存のVLLMやSGLangは置き換わるのか
- TKCCは、VLLM・SGLang・TRT-LLMといったエンジンを実験ごとに起動・破棄する代わりに、起動したまま候補のforward passをホットリロードして評価する枠組みとして説明されている。既存エンジンを土台に使う位置づけとみられ、完全な置き換えを主張した記述はない。
- 比較のベースラインは何だったのか
- 3種類が示されている。人手で調整したmegakernel、InferenceXで公開されている最良のエンジン構成、そして気象・PDE・時系列・生物学の分野で公開されているコードベースをClaude Codeの/goalコマンドで最適化した場合である。
用語解説
- TPS
- 1秒あたりに処理できるトークン数。推論性能を表す代表的な指標。
- 常駐エンジン(persistent engine)
- 推論エンジンを起動したまま、最適化候補のforward passをホットリロードして評価するTKCCの仕組み。
- megakernel
- 複数の演算を1つのカーネルにまとめ、メモリアクセスや起動のオーバーヘッドを減らす実装手法。
- MoE
- Mixture of Experts。入力に応じて一部の専門家ネットワークだけを使う構造で、負荷が偏りやすい。
- TP/EP/DCP
- 原文に略語で列挙された並列化戦略。TPはテンソル並列、EPはエキスパート並列を指すとみられる。
- InferenceX
- SemiAnalysisが提供する推論性能のベンチマーク。AgentXなどのワークロードが含まれる。
出典
Together Compiler: Continuous Compilation for AI inference
https://together.ai/blog/together-compiler-continual-compilation-for-ai-inference
AI導入も顧問も、お任せください
何から手をつけるか、どこまでAIに任せるか。自社の業務に合わせて整理し、導入から運用まで伴走します。相談だけでも構いません。
AI導入について相談する